机器学习(Machine Learning)是人工智能(AI)的一个分支,它使计算机系统能够利用数据和算法自动学习和改进其性能。
机器学习是一个不断发展的领域,正在改变我们与技术的互动方式,为各类复杂问题提供全新的解决思路。简单来说,机器学习就是让计算机依靠数据进行学习的技术,现已广泛应用在各行各业。
可以用一个生活化例子理解:教小孩识别猫咪,不需要逐条罗列“猫有两只耳朵、四条腿、胡须”这类复杂规则;只需要给他看大量猫咪照片,并标注“这是猫”,看多之后孩子就可以自主识别从未见过的猫咪。机器学习原理与之类似:我们不去手写复杂业务规则,而是让计算机从海量数据当中,自动挖掘内在规律与模式。
机器学习是如何工作的?
机器学习本质是一个迭代过程:计算机从大量数据中学习模式规律,以此完成决策与预测工作。
完整大致流程:
- 收集、准备数据集,选择适配业务的算法训练模型;
- 模型不断调整内部参数,降低预测错误,提升对新数据的预测准确度;
- 将训练完成的模型部署上线,做实时预测;后续还可以结合新增数据迭代更新模型。
完整项目步骤拆解:
1. 数据收集
收集业务相关数据,数据源可以是数据库、文件、网络接口、实时数据流。
数据分为两大类:结构化数据(表格类数据)、非结构化数据(图片、文本、视频)。
2. 数据预处理
- 数据清洗:处理缺失值、异常值、错误、重复样本;
- 特征工程:筛选有效特征,也可以构造新特征;
- 标准化/归一化:统一数据数值范围,提升算法运行效果。
3. 选择模型
先明确业务问题类型(分类、回归、聚类等),再挑选适配的算法,可同时对比多个算法效果。
4. 训练模型
- 数据集划分:拆分为训练集、验证集、测试集;
- 训练:在训练集上学习,调整参数最小化损失函数;
- 验证:借助验证集调参,避免出现过拟合。
5. 评估模型
使用测试集检验模型真实能力,常用指标:准确率、召回率、F1分数等;也可以采用交叉验证,评估模型泛化能力。
6. 模型优化
- 调整超参数:学习率、树深度等训练前就设定的参数,可使用网格搜索、随机搜索优化;
- 重新筛选特征,进一步提升模型表现。
7. 部署模型
把模型集成到网站、APP、软件等实际业务系统;上线后持续监控性能,根据新数据维护更新。
8. 反馈循环
支持持续学习,模型随着新增业务数据不断迭代,适配业务变化。
关键概念补充
- 损失函数:衡量预测结果和真实结果的差距,训练目标就是最小化损失函数;
- 优化算法:例如梯度下降,用来求解最优模型参数;
- 正则化:增加惩罚项,用来防止模型过拟合。
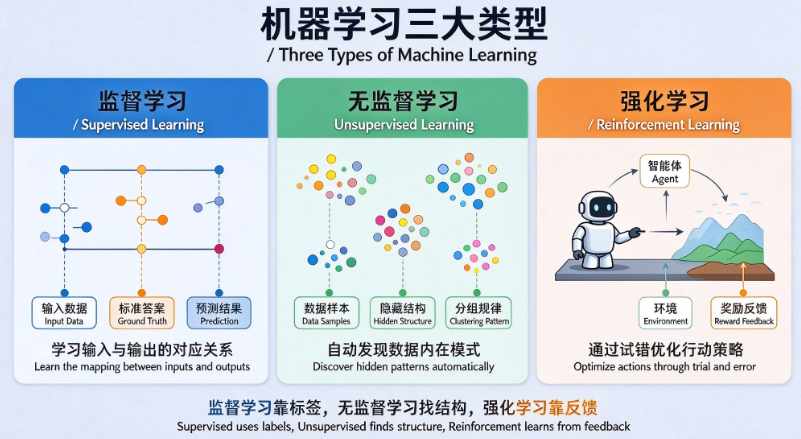
机器学习的三大类型
1. 监督学习(Supervised Learning)
使用带标签的数据训练模型,学习输入数据和标签之间的对应关系,完成预测或者分类任务。
- 典型应用:分类(垃圾邮件识别)、回归(房价预测)
- 代表算法:线性回归、决策树、支持向量机(SVM)
2. 无监督学习(Unsupervised Learning)
输入没有标签的数据,模型自主挖掘数据内部隐藏结构与规律。
- 典型应用:聚类(客户分群)、降维(数据可视化)
- 代表算法:K‑means聚类、主成分分析(PCA)
3. 强化学习(Reinforcement Learning)
智能体和环境交互,依靠不断试错,通过奖励、惩罚反馈,学习最优行动策略,最大化长期回报。
- 典型应用:游戏AI(AlphaGo)、自动驾驶、机器人控制
- 代表算法:Q‑learning、深度Q网络(DQN)
三者区别小结:监督学习依靠标准答案;无监督学习自主找规律;强化学习依靠环境反馈试错学习。
机器学习应用领域
- 推荐系统:短视频平台视频推荐、电商商品推荐、音乐软件歌单推荐。
- 自然语言处理(NLP):语音识别、机器翻译、情感分析、智能客服聊天机器人。
- 计算机视觉:人脸识别、物体检测、图像分类、自动驾驶识别行人和障碍物。
- 金融分析:信用评分、信用卡欺诈检测、风险评估。
- 医疗健康:辅助疾病诊断、药效分析、病情趋势预测。
- 游戏娱乐:游戏AI对手、动态难度调整,代表案例AlphaGo。
机器学习的未来方向
随着数据规模暴涨、算力不断提升,机器学习会渗透到更多行业:
- 强化学习:无需人工指引,依靠试错解决复杂任务;
- 自监督学习:降低对标注数据的依赖,直接从无标签数据学习特征;
- 深度学习:属于机器学习子领域,基于神经网络,持续推动图像、NLP领域技术突破。
机器学习可以打造更加智能的系统,替代大量重复工作,会成为各行各业重要的技术驱动力。
入门示例:线性回归预测房价
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
import seaborn as sns

# 图表风格与中文配置
sns.set_style("whitegrid")
plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei', 'PingFang SC']
plt.rcParams['axes.unicode_minus'] = False

# 1. 准备数据集
# 房屋面积(平方米)
house_sizes = np.array([50, 60, 70, 80, 90, 100, 110, 120]).reshape(-1, 1)
# 对应房价(万元)
house_prices = np.array([150, 180, 210, 240, 270, 300, 330, 360])

# 2. 创建模型并训练
model = LinearRegression()
model.fit(house_sizes, house_prices)

# 3. 预测新数据
pred_price = model.predict([[85]])
print(f"85㎡房屋预测价格:{pred_price[0]:.2f} 万元")

# 4. 绘图
plt.scatter(house_sizes, house_prices, color='blue', label='真实样本')
plt.plot(house_sizes, model.predict(house_sizes), color='red', label='拟合预测线')
plt.scatter(85, pred_price, color='green', s=100, label='85㎡预测点')
plt.xlabel("房屋面积(㎡)")
plt.ylabel("房价(万元)")
plt.title("线性回归:面积预测房价")
plt.legend()

# 保存图片(推荐,所有环境通用)
plt.savefig("house_price.png", dpi=300, bbox_inches="tight")
print("图表已保存至 house_price.png")
运行输出:
85㎡房屋预测价格:255.00 万元
图表已保存至 house_price.png
常见问题:图表没有弹窗
- 本地终端:可以增加
import matplotlib; matplotlib.use('TkAgg')启用窗口; - 服务器/SSH无桌面环境:不能使用 plt.show(),只能 savefig 保存图片;
- 注意:
plt.savefig()必须写在plt.show()前面,否则图片空白。
本章小结
- 机器学习是人工智能的分支,核心是从数据中自动学习模式,而非人工编写全部规则;
- 完整机器学习项目是迭代流程,包含数据收集、预处理、训练、评估、调优、部署;
- 三大类型:监督学习、无监督学习、强化学习,分别适配不同业务场景;
- 机器学习广泛应用于推荐、视觉、NLP、金融、医疗等领域。
0 条笔记