机器学习项目和普通软件开发项目不一样,它不是写完代码就结束。机器学习项目拥有一套完整的生命周期,从业务需求出发,直到模型上线、持续维护。整个过程是循环迭代的,上线之后依然需要持续监控、更新数据、重训模型。
机器学习项目生命周期阶段
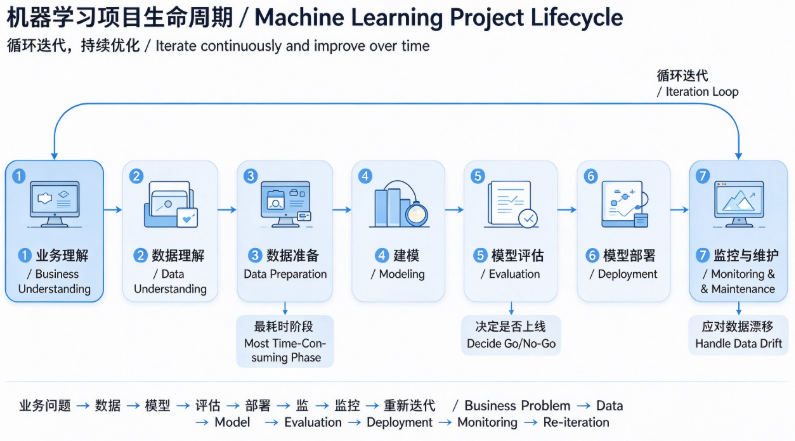
完整生命周期分为7个阶段:
- 业务理解 Business Understanding
- 数据理解 Data Understanding
- 数据准备 Data Preparation
- 建模 Modeling
- 模型评估 Evaluation
- 模型部署 Deployment
- 监控与维护 Monitoring & Maintenance
注意:流程不是单向一次性跑完,经常会回到前面步骤迭代优化。例如评估阶段效果很差,可能返回数据准备阶段重新清洗数据、构造特征。
1. 业务理解 Business Understanding
项目第一步,不是直接去找数据写代码,而是先搞清楚业务目标。
- 明确业务问题:我们要解决什么问题?是分类还是回归?
- 定义成功指标:用什么标准判断模型是否可用(准确率、成本降低额、营收提升等)
- 评估项目资源:数据、算力、人力、时间是否充足
- 判断可行性:机器学习是否适合解决当前问题,还是简单规则程序就能搞定
示例:电商需要识别恶意刷单账号。业务目标:降低刷单带来的营销损失;成功指标:尽可能识别出刷单账号,同时减少误判正常用户。
2. 数据理解 Data Understanding
确定业务目标后,开始收集并探查数据。
- 收集原始数据:数据库、日志、第三方数据源
- 数据探查:查看样本数量、字段分布、最大值最小值
- 发现问题:缺失值、异常值、数据倾斜、错误数据
- 初步分析特征和目标之间的相关性
这一步用来判断现有数据是否足够支撑模型训练。如果数据质量太差,项目可能直接终止。
3. 数据准备 Data Preparation
机器学习项目中,数据准备通常占用 60%~80% 的工作量。原始脏数据不能直接送入模型,需要加工处理。
- 数据清洗:填充/删除缺失值,剔除异常、重复、错误样本
- 特征选择:去掉无关、冗余字段,保留有用特征
- 特征工程:创建新特征,转换字段格式
- 数据转换:标准化、归一化、编码类别数据
- 数据集划分:将数据集拆分为训练集、验证集、测试集
训练集 Training set:用于训练模型
验证集 Validation set:训练过程调参,选择最优模型
测试集 Test set:全程只使用一次,用来评估模型在未知新数据上的泛化能力
4. 建模 Modeling
选择合适算法,搭建并训练模型。
- 选择候选算法:线性回归、决策树、随机森林等
- 设置初始超参数
- 使用训练集训练模型;验证集辅助调参
- 尝试多种模型,对比初步效果
参数区分
- 模型参数 Model Parameter:训练过程模型自动学习得到(如线性回归权重)
- 超参数 Hyperparameter:训练前人工设定(学习率、树深度)
5. 模型评估 Evaluation
用测试集评估模型性能,不能只看训练集表现。
- 使用评估指标:准确率、精确率、召回率、F1、MAE、MSE等
- 检查是否存在过拟合 / 欠拟合
- 业务层面校验:模型预测结果是否符合业务常识
- 判断模型是否达到预设业务指标
- 评估不达标:返回前面阶段,重新处理数据、调整特征或者更换算法
过拟合 Overfitting:模型在训练集表现极好,但是遇到新数据效果很差,记住了训练样本噪声,没有学到通用规律。
欠拟合 Underfitting:模型太简单,连训练集本身规律都无法学习,训练和测试效果都很差。
6. 模型部署 Deployment
模型在本地测试效果达标后,部署到真实生产环境。
- 将模型打包:导出训练好的模型文件
- 封装服务:做成API接口,供业务系统调用
- 灰度发布:小流量上线,观察线上表现,不直接全量开放
- 集成到业务系统(网站、APP、后台)
纸上效果好的模型,上线后可能因为线上数据分布变化出现效果下滑。
7. 监控与维护 Monitoring & Maintenance
模型上线不等于项目结束,这是机器学习项目和普通程序最大区别。
真实世界数据分布会随时间发生变化,这个现象叫数据漂移 Data Drift、概念漂移 Concept Drift。
- 监控:监控模型预测性能、输入数据分布、响应延迟、错误率
- 定期重训:收集新业务数据,周期性重新训练模型
- 版本管理:保存不同版本模型,方便回滚
- 业务迭代:业务需求变化时,重新启动一轮生命周期
生命周期迭代总结
机器学习项目是一个持续循环的闭环。
部署完成后持续监控,当模型效果衰减,项目会再次回到数据理解、数据准备阶段,开启新一轮迭代。
本章小结
- 机器学习项目生命周期共7个阶段:业务理解、数据理解、数据准备、建模、评估、部署、监控维护。
- 数据准备是最耗时阶段,占据项目大部分工作量。
- 数据集分为训练集、验证集、测试集;测试集只能最后评估使用。
- 上线后需要持续监控,应对数据漂移与概念漂移,定期更新模型。
- 整个流程是循环迭代,不是一次性单向流程。
思考题
- 为什么机器学习项目上线之后,还需要持续监控模型?
- 过拟合与欠拟合有什么区别?
- 训练集、验证集、测试集分别有什么作用?
0 条笔记