学习机器学习就像学习一门全新语言,先要掌握基础词汇。这些术语构成机器学习的语言体系,是深入学习的必备基础。
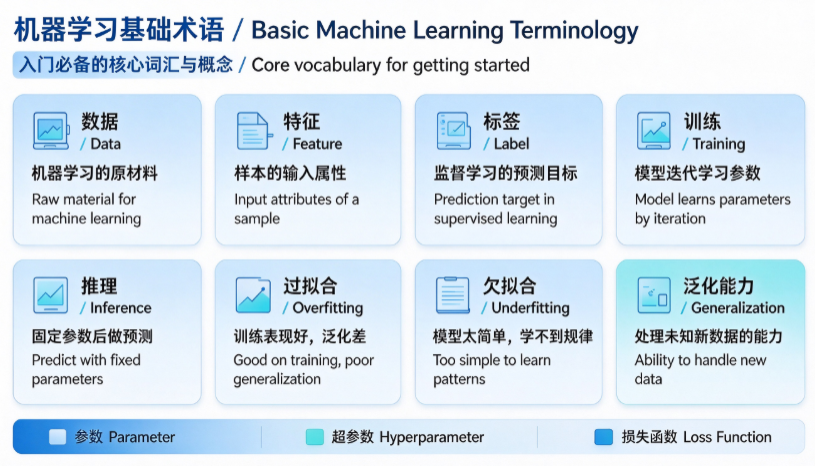
举一个通俗例子:教机器人识别水果
- 数据 Data:各类水果图片与相关信息
- 特征 Feature:水果的颜色、形状、大小、味道
- 标签 Label:水果的名称(苹果、香蕉、橙子)
- 模型 Model:机器人学到的识别水果的方法
- 训练 Training:教机器人认识水果的学习过程
- 推理 Inference:机器人识别从未见过的新水果
1. 数据(Data)
数据是机器学习的原材料,如同做菜的食材。没有数据,模型无法开展训练。
数据的两种类型
结构化数据 Structured Data
格式规整,以表格形式存储,行列清晰。
示例:学生信息表、房屋信息表、数据库表。
import pandas as pd
students_data = {
    '姓名': ['张三', '李四', '王五'],
    '年龄': [18, 19, 20],
    '成绩': [85, 92, 78],
    '班级': ['一班', '二班', '一班']
}
df = pd.DataFrame(students_data)
print(df)
非结构化数据 Unstructured Data
没有固定表格格式,需要额外处理才能送入模型。
示例:文本评论、照片图片、语音音频、视频文件。
# 非结构化数据示例
text_data = "这个产品质量很好,我很满意!"
# image_data = 产品照片
# audio_data = 用户语音评价
垃圾进,垃圾出 Garbage In, Garbage Out
机器学习重要原则:输入数据质量,直接决定模型最终效果。脏数据会产出效果糟糕的模型。
import pandas as pd
# 包含缺失、异常、类型混乱的脏数据
problematic_data = {
    '价格': [100, 200, None, 300, -50],
    '评分': [4.5, '好', 3.8, 4.2, 5.0],
    '销量': [1000, 1200, 800, 1500, '很多']
}
df = pd.DataFrame(problematic_data)
print(df)
print(f"缺失值总数量:{df.isnull().sum().sum()}")
数据集划分
- 训练集 Training Set:用于模型学习规律。
- 验证集 Validation Set:训练中调超参数,辅助筛选模型。
- 测试集 Test Set,全程不参与训练,用来评估模型对新样本的泛化能力。
2. 特征(Feature)
特征是样本可被观察的属性,是模型用来做预测的输入依据。
特征工程非常关键:优质特征可以大幅降低模型难度,劣质特征会严重拖累效果。
特征分类
- 数值特征 Numerical Feature:数字,可以做数学运算。例:年龄、收入、房屋面积。
- 类别特征 Categorical Feature:代表类别,不能直接进行数学运算。例:性别、城市、学历。
- 文本特征 Text Feature:文本内容,需要做分词、向量化处理。例:商品评论、新闻文本。
特征工程示例
从原始字段衍生出新的有效特征:
import pandas as pd
house_data = {
    '面积': [80, 120, 60, 150, 90],
    '卧室数': [2, 3, 1, 4, 2],
    '建造年份': [2000, 2010, 1995, 2015,2005],
    '价格': [200, 350, 150, 500, 280]
}
df = pd.DataFrame(house_data)
# 衍生新特征
df['房龄'] = 2026 - df['建造年份']
df['每平米价格'] = df['价格'] / df['面积']
print(df)
3. 标签(Label)
标签就是监督学习中的“标准答案”,是我们希望模型预测的目标值。
- 分类标签 Classification Label:离散类别。例:垃圾邮件/正常邮件、患病/健康。
- 回归标签 Regression Label:连续数字。例:房价、温度、销售额。
标签质量很重要:标签错误、标签不统一,会直接导致模型学错规律。
4. 模型(Model)
模型是算法从数据中学到的规律,本质是数学函数+一组参数集合:输入特征,输出预测结果。
- 参数 Parameter:训练过程模型自动学习得到的值,例如线性回归的斜率 w、截距 b。
- 超参数 Hyperparameter:训练前人工设置,模型无法自己学习,例如学习率、树的最大深度。
模型复杂度:模型能力强弱。模型太简单容易欠拟合;模型过于复杂容易过拟合。
简单线性模型示例:
import numpy as np
X = np.array([1, 2, 3, 4, 5])
w, b = 2, 0
def linear_model(x):
    return w * x + b
print(linear_model(X))
5. 训练(Training)
训练就是模型学习的过程,类比学生上课学习知识。
训练循环流程:
- 输入样本,模型给出预测;
- 通过损失函数 Loss Function计算预测与真实标签的误差;
- 使用优化算法(梯度下降)更新模型参数;
- 循环迭代,不断降低损失。
损失函数 Loss Function:衡量单个样本预测误差;
代价函数 Cost Function:全部样本损失的平均值,代表整体误差。
6. 推理(Inference)
训练完成之后,固定模型参数,输入新数据得到预测结果,这个阶段叫推理。类比考完试,用学到的知识解答新题目。
⚠️ 训练阶段修改参数;推理阶段参数固定,只做预测,不再学习。
简单推理示例:
class HousePriceModel:
    def __init__(self):
        self.feature_weights = {'面积':2.5,'卧室数':10.0,'房龄':-1.0}
        self.bias = 50
    def predict(self, features):
        price = self.bias
        for k,v in features.items():
            price += self.feature_weights[k] * v
        return price

model = HousePriceModel()
print(model.predict({'面积':80,'卧室数':2,'房龄':5}))
7. 重要基础概念
过拟合 Overfitting
模型记住训练集噪声,而非通用规律。训练集效果极好,未知新数据效果很差。
解决:增加数据、正则化、降低模型复杂度、提前停止训练。
欠拟合 Underfitting
模型能力不足,连训练集本身规律都学不会,训练集、测试集效果都很差。
解决:增加特征、选用复杂度更高的模型、延长训练迭代。
泛化能力 Generalization
模型处理从未见过的新数据的能力,机器学习的核心追求目标。
偏差‑方差权衡 Bias‑Variance Trade‑off
- 偏差 Bias:模型本身假设带来的误差,对应欠拟合;
- 方差 Variance:对训练集微小噪声敏感,对应过拟合;
机器学习需要平衡偏差与方差,获取最小总误差。
8. 三大学习范式
- 监督学习 Supervised Learning:数据集带标签。分为回归(预测连续数值)、分类(预测类别)。
- 无监督学习 Unsupervised Learning:无标签,自动挖掘数据结构。典型任务:聚类、降维。
- 强化学习 Reinforcement Learning:智能体与环境交互,依靠奖励、惩罚信号学习最优动作。
9. 常用评估指标
- 准确率 Accuracy:分类任务,预测正确样本占全部样本比例,适合样本均衡场景。
- 精确率 Precision:预测为正的样本中真正为正的比例。
- 召回率 Recall:所有真实正样本被识别出来的比例。
- F1分数 F1‑Score:精确率、召回率调和平均,综合评价分类器。
- 均方误差 MSE:回归任务,衡量预测值与真实值之间的偏差。
本章小结
- 数据分为结构化、非结构化;遵循“垃圾进,垃圾出”原则。
- 特征是输入,标签是监督学习的预测目标。
- 训练:调整参数学习规律;推理:固定参数做预测。
- 参数由模型自动学习;超参数需要人工预先设置。
- 过拟合:死记训练数据,泛化差;欠拟合:模型太简单学不到规律。
- 数据集拆分为训练集、验证集、测试集;测试集不能参与训练。
思考题
- 参数与超参数的区别是什么?各举一例。
- 训练和推理阶段模型行为有什么不同?
- 过拟合、欠拟合现象如何区分?
0 条笔记