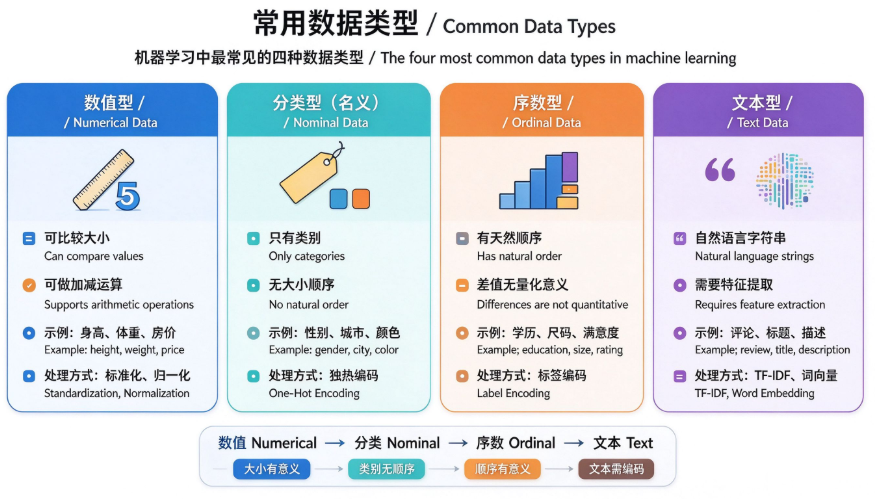
机器学习里,数据集根据业务含义,通常分为四大类:数值型、分类型、序数型、文本型。不同类型的数据,对应的特征处理方式差异很大,是特征工程的基础。
1. 数值型(Numerical Data)
数值型数据代表数量,可以进行大小比较和数学运算,分为连续数值和离散数值。
- 连续数值:取自一段区间内的任意数值,一般由测量得到。
示例:身高、体重、温度、房价、收入 - 离散数值:只能取特定数值,大多是计数结果。
示例:购买数量、页面访问次数、样本数量
适合直接送入回归类模型训练;数值的大小、差值都具备实际意义。
示例代码:
import pandas as pd
df = pd.DataFrame({
    "身高": [165.2, 172.5, 178.1],
    "购买数量": [2, 1, 5]
})
print(df.dtypes)
2. 分类型(Nominal Data,名义型)
分类型数据用于标记类别,类别之间不存在大小、先后顺序关系。
示例:性别、颜色、城市、商品品类
只能判断是否相等,不能比较大小,例如不能认为“红色>蓝色”。
原始字符串无法直接输入模型,常规处理方案:独热编码(OneHot)。
注意区分序数型:名义分类只有类别标识,没有顺序。
3. 序数型(Ordinal Data)
同样属于类别数据,但类别之间存在天然顺序,类别之间的间隔无法量化。
示例:评价等级(差、一般、良好、优秀)、学历、服装尺码 S/M/L/XL
可以比较顺序:优秀>良好,但是不能认定“优秀 − 良好 = 良好 − 一般”。
常规处理方案:标签编码(LabelEncoder)映射为 0,1,2,3 这类数字。
4. 文本型(Text Data)
自然语言字符串,内容长度不固定。
示例:用户评论、新闻标题、对话记录、产品描述
原始文本不能直接交给模型,需要文本特征工程。
常规处理方案:词袋模型、TF-IDF、词嵌入(Word Embedding)。
四种类型对比表
| 类型 | 是否可比较大小 | 是否可做加减运算 | 常见处理方式 |
|---|---|---|---|
| 数值型 | ✅ | ✅ | 标准化、归一化 |
| 分类型(名义) | ❌ | ❌ | OneHot 独热编码 |
| 序数型 | ✅ | ❌ | 标签编码 |
| 文本型 | ❌ | ❌ | TF-IDF、词向量 |
完整示例:Pandas 查看数据类型
import pandas as pd

data = {
    "体重": [55.2, 62.3, 70.1],          # 数值型
    "城市": ["杭州","宁波","温州"],        # 分类型
    "满意度": ["差","良好","优秀"],        # 序数型
    "评论": ["很不错","一般般","不推荐"]    # 文本型
}
df = pd.DataFrame(data)
print(df.dtypes)
小结
- 数值型:支持加减运算;
- 名义分类型:仅代表类别,无顺序;
- 序数型:存在顺序,但差值无意义;
- 文本型:自然语言,需要单独做特征提取。
新手常见问题:直接将字符串分类数据传入 sklearn,模型无法识别,必须先编码转换。
思考题
- 周一、周二、周三属于分类型还是序数型?
- 颜色编号:1=红,2=蓝,3=黄,能不能直接当成数值型训练?为什么?
- 归一化一般针对哪一类数据?
0 条笔记