机器学习已经融入各行各业,不再只是实验室技术。它通过从历史数据中学习规律,实现自动识别、预测、决策与优化。本文介绍机器学习主流应用场景,同时区分不同场景对应的任务类型。
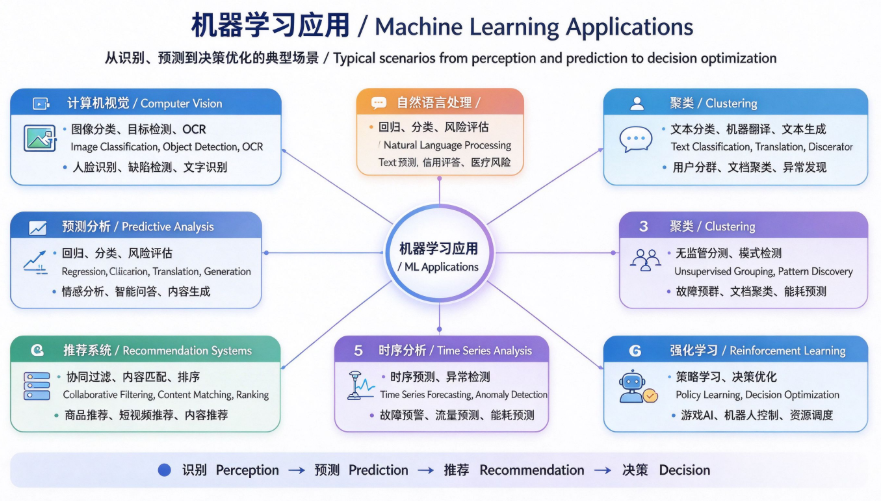
1. 计算机视觉
计算机视觉让机器看懂图片和视频,是应用最广泛的方向之一。
- 图像分类:判断图片属于哪一类。例如识别猫狗、识别商品、证件照分类。
- 目标检测:找出图片里物体的位置并标注。例如人脸识别、车牌识别、工地安全帽检测。
- 图像分割:把图片按像素划分不同区域。例如医疗影像病灶分割、自动驾驶道路区域分割。
- OCR文字识别:从图片中提取文字,票据识别、身份证信息读取都属于这类。
任务类型:分类、检测、分割
2. 自然语言处理(NLP)
自然语言处理实现机器理解、生成人类语言。
- 文本分类:情感分析(好评/差评)、垃圾邮件识别、新闻内容归类。
- 机器翻译:多语种自动翻译。
- 文本生成:文案写作、摘要生成、对话问答。
- 命名实体识别:从文本提取人名、地名、时间、金额等关键信息。
任务类型:文本分类、序列标注、生成任务
3. 预测分析
基于历史数据预测未来数值或结果,传统机器学习最常用场景。
- 销量预测:电商、零售预测未来商品销量,辅助备货。
- 金融风控:评估用户逾期、欺诈风险。
- 房价、客流、能耗预测。
- 医疗预测:基于体检指标预测患病风险。
任务类型:回归、二分类
4. 推荐系统
根据用户历史行为,推送用户可能感兴趣的内容。
- 短视频推荐、商品推荐、音乐推荐、文章推荐。
- 核心思路:挖掘用户和物品之间的关联,协同过滤、内容特征匹配都是经典方案。
5. 时序数据应用
针对随时间变化的连续数据做分析。
- 服务器流量监控、异常告警。
- 传感器数据(工业设备振动、温度)故障预测。
- 股票、负荷时序预测。
任务类型:时序预测、异常检测
6. 聚类
在没有标签的数据里自动发现相似群体,属于无监督学习。
- 用户分群:把用户划分成不同群体,定向运营。
- 图片素材自动分组、文档聚类。
- 异常检测:找出和大部分样本差异很大的数据。
7. 强化学习
智能体在环境中不断试错,通过奖励机制学习最优动作策略。
- 游戏AI、机器人控制。
- 自动驾驶决策、资源调度优化。
应用场景汇总表
| 领域 | 典型例子 | 常用机器学习任务 |
|---|---|---|
| 计算机视觉 | 人脸识别、OCR、缺陷检测 | 分类、检测、分割 |
| 自然语言处理 | 情感分析、翻译、问答 | 文本分类、序列建模 |
| 预测分析 | 销量预测、风险评估 | 回归、分类 |
| 推荐系统 | 商品、短视频推荐 | 协同过滤、排序模型 |
| 时序分析 | 设备故障预警、流量预测 | 时序预测、异常检测 |
| 聚类 | 用户分群 | 无监督聚类 |
| 强化学习 | 机器人、游戏AI | 策略学习 |
简单示例:情感分析(文本分类)
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression

# 样本
texts = [
    "这个产品很好用",
    "质量很差,不推荐",
    "体验不错,值得购买",
    "很失望,不建议买"
]
labels = [1, 0, 1, 0] # 1好评,0差评

# 文本转特征
vec = TfidfVectorizer()
X = vec.fit_transform(texts)

# 训练分类模型
model = LogisticRegression()
model.fit(X, labels)

# 预测新句子
test_text = ["非常满意"]
pred = model.predict(vec.transform(test_text))
print("预测结果:", "好评" if pred[0]==1 else "差评")
小结
机器学习的应用可以简单分为两大类:
- 有监督学习:有标注数据,用来做分类、回归预测;
- 无监督学习:没有标签,用来聚类、挖掘隐藏模式;
- 强化学习:通过和环境交互持续优化策略。
现实项目里,很多产品是多种能力组合,例如电商平台同时用到OCR、推荐、销量预测、风控模型。
思考题
- 短视频推荐系统属于哪一类机器学习任务?
- 设备故障告警识别异常数据,是监督还是无监督场景?
- 人脸识别主要属于哪个技术方向?
0 条笔记