一、Harness 多模态是什么
DeepSeek Harness 的多模态能力,是在原有文本 Agent 框架之上增加图像输入支持,可以把截图、图表、照片、PDF 图片版和文本指令混合在一起交给智能体执行任务。
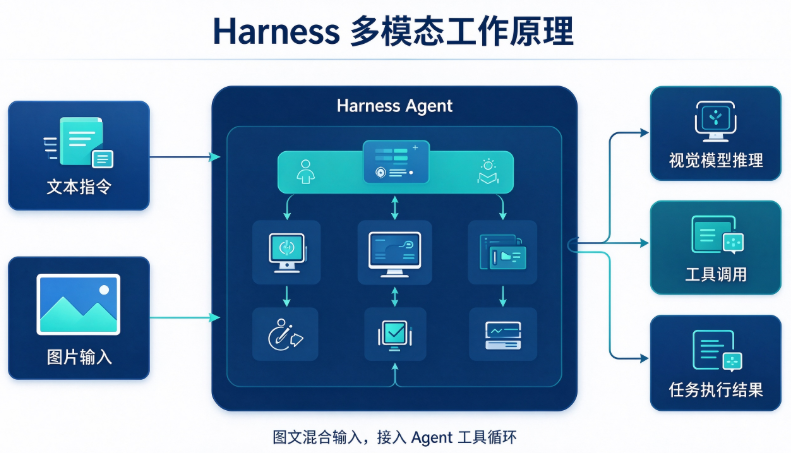
核心要点:
- Harness 内核本身不做图像编码,多模态能力依赖支持视觉的大模型(DeepSeek V4-Flash-Vision-Exp、DeepSeek-Flash 或其他第三方 VLM)。
- 底层模型适配器新增开关,标记模型是否支持图片输入;只有标记为支持图像的模型,WebUI 才允许拖拽上传图片附件。
/goal、/plan等原生 Agent 指令现在支持图文混合输入,PTC 模式也支持在子代理之间转发图片附件。- 图片附件会持久保存在会话上下文,支持多轮连续看图;框架内置机制防止大图、多轮累计图片 token 过载问题。
支持图片格式:JPEG、PNG、GIF、WebP。
二、两种多模态工作模式
模式1:原生视觉模型(推荐)
直接选用支持视觉的模型,Harness 将图片和文本一起打包传给模型,模型原生理解图片内容,适合截图分析、图表解读、UI 页面排查、手写文档识别。
- 优点:端到端理解,图文联合推理,Agent 可以根据图片内容直接决定调用工具。
- 适用:
deepseek-v4-flash-vision-exp/deepseek-flash等原生多模态模型。
模式2:子代理视觉委托(社区插件方案)
主 Agent 仍然使用纯文本模型,遇到图片时自动调用视觉子代理插件(dsh-subagent-vision),子代理调用 VLM 识图,把图片转成文字描述返回给主 Agent,继续执行任务。
- 优点:不用切换主模型,存量纯文本工作流直接复用看图能力。
- 缺点:图片信息先转为文本,会丢失部分视觉细节。
还有社区代理插件
dsh-vision-proxy,作为模型适配器中间层,自动把图片转成文本再送入原模型。
三、环境准备
- 将 Harness 更新到最新版本
npm install -g @deepseek-ai/dsh@latest
- 准备支持视觉的模型 API Key,在
Settings → Models配置模型提供商。 - 在模型配置面板勾选 Allow image input,开启图片输入能力(Harness 通过这个标记判断是否接收图片附件)。
- 启动 Harness Web:
dsh web,打开http://127.0.0.1:3080。
四、WebUI 图文任务实操
- 切换模型为视觉模型(
deepseek-v4-flash-vision-exp或 deepseek-flash)。 - 直接将图片拖拽到输入框,或点击附件上传。
- 输入文本指令,图文一起发送。
示例任务:
上传一张网页截图:帮我分析这个页面布局,找出UI问题,并给出修改方案。
上传代码截图:读取截图中的代码,修复bug并输出完整可运行代码。
上传Excel图表图片:解读图表数据,总结趋势,生成分析报告。
混合任务:
/plan这张架构图,然后读取项目目录文件,核对架构是否和图一致。
特性:图片会保存在当前会话,后续多轮对话模型可以继续引用同一张图片,不需要重复上传。
五、Python SDK 调用多模态任务
SDK 同样支持传入图片,底层复用 Harness 多模态适配器。支持三种图片传入方式:本地文件、图片URL、Files API 文件ID。
from harness_sdk import HarnessClientclient = HarnessClient(base_url="http://127.0.0.1:3080")
session = client.create_session(profile="standard", workspace="./workspace") # 图文混合任务,传入本地图片文件路径
task = session.run_task(
prompt="分析这张截图,找出报错原因并给出修复代码",
images=["./screenshot.png"]
)result = task.wait()
print(result.output)
注意:SDK 同样需要当前会话选中的模型开启图像输入能力。
六、多模态 Profile / Bundle 配置
你可以自定义 Profile,默认启用视觉模型和配套插件。示例配置片段:
agent-default-model:
  provider: deepseek
  model: deepseek-v4-flash-vision-exp
model-providers:
  deepseek:
    apiKey: "你的key"
    capabilities:
      inputModalities: ["text", "image"]
inputModalities 用来声明模型支持的输入类型,["text","image"] 代表支持图文。
七、典型业务场景
- 截图 Debug:上传程序报错截图,Agent 读取报错信息,自动检索代码、定位问题、修复代码。
- UI/网页评审:上传页面截图,分析布局、配色、交互缺陷,输出改进方案。
- 图表与数据分析:读取折线图、柱状图、手绘草图,提取数据、生成结论。
- 工程图纸、架构图解析:看懂架构图,对比项目源码,校验代码实现是否符合图纸设计。
- 文档OCR+处理:扫描文档、手写笔记识别,提取文字,整理成Markdown。
- 混合多轮Agent规划:看图生成计划
/plan,再调用文件工具、Shell工具完成后续工程任务。
八、图片处理规则与限制
- 图片大小:过大图片会自动压缩,避免 token 超限;多轮对话框架会自动管理历史图片,防止上下文膨胀。
- 计费:图片会按视觉token计费,和文本token分开,以模型服务商计费规则为准。
- 会话隔离:图片附件属于当前会话,新建会话需要重新上传。
- 权限:图片仅保存在本地Harness实例,仅上传到你配置的模型API服务商。
九、常见问题排查
- 上传图片后发送被拦截
模型没有开启Allow image input,模型适配器标记为仅文本,Harness 会拒绝图片附件。到模型配置面板勾选图像输入开关。 - 图片上传成功,但模型看不懂图片
确认使用的模型本身具备视觉能力;普通纯文本模型即使开启标记,也无法解析图片。 - 多轮对话,图片越传越多,请求超时/报错
Harness 新版本已经修复历史图片累积载荷问题;复杂长任务建议适时新开会话。 - 子代理模式识图失败
检查dsh-subagent-vision社区插件安装正常,并且在插件设置中指定可用的视觉子模型。 - Python SDK 传入图片报错
确认Harness服务版本最新,且当前会话模型开启图像输入能力。
十、小结
Harness 的多模态不是独立的OCR工具,而是把视觉理解完整接入Agent工具循环。模型看懂图片之后,可以继续调用文件读写、Shell、代码执行、Git等全套工具,完成图文结合的复杂工程任务。
两种方案按需选择:原生视觉模型适合端到端看图推理;社区子代理插件适合存量纯文本Agent快速增加识图能力。
0 条笔记