Skills 工作原理(渐进式加载机制详解)
很多新手会误以为:Skill 一旦放入项目目录,就会被 AI 一次性全部读取、常驻内存。这是完全错误的。
Skill 真正的核心工作原理是:渐进式披露(Progressive Disclosure),也叫三层按需加载机制。
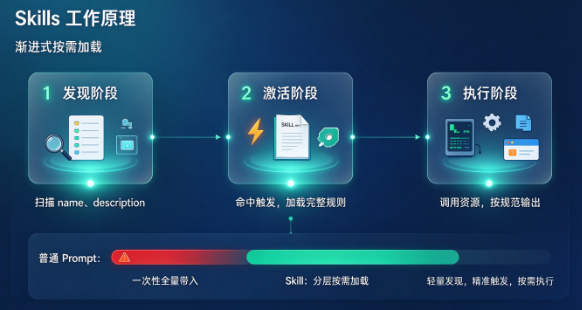
简单一句话总结:平时只记名字,匹配才读规则,执行才调资源。
这套机制解决了传统 Prompt 的最大痛点:上下文溢出、Token 成本高、模型注意力混乱,也是 Skill 可以无限叠加、工程化落地的根本原因。
一、为什么必须使用渐进式加载?
如果 AI 每次对话都把项目里所有 Skill 的完整内容、脚本、模板、示例全部载入上下文,会出现三个致命问题:
- 上下文爆炸:技能越多,对话窗口越容易溢出;
- 推理成本飙升:大量无效 Token 消耗,浪费算力;
- 模型注意力错乱:无关技能干扰当前任务,导致回答出错、乱触发。
因此 TraeCode 等智能体插件采用 分层、按需、轻量化 的加载逻辑,全程只加载「当前任务需要的信息」。
二、Skill 三层核心工作机制(核心原理)
Skill 的完整运行分为三层加载,层层递进、按需唤醒,以我们本地的 roll-dice 掷骰子技能 为例,全程贴合真实运行逻辑。
第一层:元数据扫描(发现阶段——永久轻量加载)
会话启动瞬间,AI 只会做一件事:扫描所有 Skill 的 YAML 头部元信息。
仅读取三个轻量信息:
- 技能名称(name)
- 功能描述(description)
- 版本与作者
本阶段特点:
- 不加载正文、不加载脚本、不加载模板;
- 占用 Token 极低,可以同时容纳几十上百个技能;
- 作用:让 AI 知道「我有哪些能力、分别能解决什么问题」。
类比:AI 只看了所有技能的「目录清单」,没有翻开任何一本书。
第二层:正文加载(匹配阶段——触发后按需载入)
当用户输入指令,例如「帮我掷一个 d20 骰子」,AI 会进行语义匹配:
用户意图 == roll-dice 技能 description 关键词
匹配成功后,才会加载完整 SKILL.md 正文。
此时 AI 才读取:任务目标、触发场景、执行步骤、输出规范、限制规则。
本阶段特点:
- 未匹配的技能,全程不加载、不占用上下文;
- 只加载当前命中的单个技能完整规则;
- 模型开始严格按照自定义流程执行任务,不再自由发挥。
类比:AI 找到了对应的书,翻开完整阅读「操作说明书」。
第三层:资源调用(执行阶段用到才加载)
当技能需要真实执行动作时,AI 才按需读取外部资源:
- 需要示例时,加载 examples 样例;
- 需要统一格式时,加载 templates 模板;
- 需要代码运算时,调用 scripts 脚本;
- 需要校验时,读取 tests 测试用例。
以 roll-dice 为例:AI 执行到最后一步,才调用本地 PowerShell / Bash 终端命令生成随机点数,不需要的资源全程不加载。
类比:看书看懂之后,真正动手干活时,才调用工具、参考案例。
三、Skill 完整运行链路(通俗易懂版)
结合本地 roll-dice 项目,完整流程如下:
- 启动扫描:TraeCode 扫描
.agents/skills所有技能元数据,生成能力清单; - 意图匹配:用户输入掷骰子指令,命中 roll-dice 描述关键词;
- 技能激活:系统注入完整 SKILL.md 规则,锁定执行流程;
- 资源执行:按需调用终端命令,生成真实随机点数;
- 规范输出:按照技能定义的格式返回结果;
- 会话结束释放:本次对话结束,多余资源自动释放,不残留上下文。
四、Skill 与普通 Prompt 的本质区别
| 对比项 | 普通 Prompt(临时指令) | Skill(渐进式加载) |
|---|---|---|
| 加载方式 | 每次对话全量带入 | 三层按需加载,轻量化常驻 |
| Token 消耗 | 高,重复消耗、浪费严重 | 极低,节省 70%+ 无效 Token |
| 执行稳定性 | 模型自由发挥,输出不稳定 | 强制按 SOP 执行,规则固定 |
| 复用性 | 单次对话失效,无法复用 | 永久本地存储,随时调用、可迭代 |
| 工程化能力 | 无版本、无管理、无法协作 | 支持 Git、版本迭代、团队共享 |
五、渐进式加载的三大核心优势
1. 极致节省 Token,降低成本
大量技能仅保留轻量元数据常驻,只有触发的技能才加载正文和资源,彻底避免全量加载带来的资源浪费。
2. 任务专注,准确率更高
未触发的技能不会干扰模型注意力,AI 只会聚焦当前任务的专属规则,大幅降低错乱、幻觉、跑偏问题。
3. 支持无限扩展、工程化落地
不受上下文窗口限制,可以无限新增技能、脚本、模板,是 AI 智能体从「玩具对话」走向「自动化工程」的核心基础。
六、常见原理误区纠正
- 误区1:Skill 放目录里就会一直占用上下文。
正解:仅元数据常驻,正文和资源全部按需加载。 - 误区2:技能越多,AI 越卡、越容易出错。
正解:分层加载机制隔离无关技能,技能数量不影响运行效率。 - 误区3:修改 SKILL.md 立刻生效。
正解:修改后需要刷新技能列表,让插件重新扫描元数据与正文。
七、全文总结
Skills 的核心工作原理就是 渐进式三层披露加载机制:
元数据常驻发现、关键词匹配激活、资源按需执行。
它彻底解决了传统 Prompt 高消耗、不稳定、不可复用的短板,让 AI 从「被动回答」升级为「按标准流程自动执行任务」,是所有 AI 智能体自动化、工程化能力的底层核心。
极简原理流程图
会话启动 → 扫描技能元数据(发现) → 用户指令匹配关键词(激活) → 加载完整技能规则 → 按需调用脚本/终端/模板资源(执行) → 输出标准化结果 → 释放多余上下文
0 条笔记