很多 Skill 开发停留在“功能可用”阶段:本地测试正常、上线后偶发报错、随机超时、流程中断、结果异常。这类间歇性、无规律、难复现的问题,靠人工调试、单次测试、事后复盘根本无法根治。
传统监控只能发现“技能挂没挂”,而可观测性可以回答“为什么挂、卡在哪、哪一步退化、如何优化”。Skills 监控与可观测性是 AI 技能工程化的质量运维底座,也是技能从个人脚本、Demo工具,升级为工业化、可量产、可长期迭代的智能服务的核心标志。
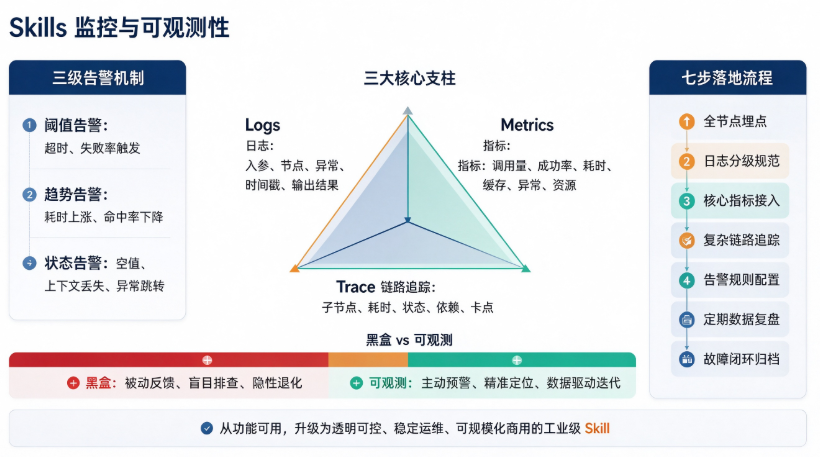
一、传统监控与可观测性的核心区别
绝大多数新手混淆“监控”和“可观测性”,二者是基础运维与高阶透明运维的层级差距:
- 传统监控:基于预设规则,只判断成功/失败、在线/离线,只能发现已知问题,无法解释故障根源,属于“被动告警”。
- 可观测性:通过日志、指标、链路追踪三大数据,完整还原运行全貌,既能发现已知故障,也能定位未知隐性问题,属于“数据驱动、主动洞察”。
简单总结:监控看结果,可观测看全过程;监控防崩溃,可观测防退化。
二、为什么 Skill 必须搭建可观测体系
无观测的技能运行完全是“黑盒状态”,规模化迭代后会出现大量不可逆问题:
- 偶发空值、解析失败、API 超时,问题随机出现,无法复现排查
- 迭代后性能隐性退化,耗时变长、缓存失效,无数据感知
- 多技能编排、异步并发场景,任务流转混乱,无法定位卡点
- 只能被动接收用户报错,无法提前发现隐患、提前修复
- 优化全凭经验,不知道高频故障节点、高耗时环节,迭代无方向
在工业化 Skill 体系中:无观测的技能,一律不允许量产上线。可观测性是技能稳定性的最后一道防线。
三、Skill 可观测性三大核心支柱(行业标准)
完整的可观测体系由 Logs 日志、Metrics 指标、Trace 链路追踪 三者构成,互为补充、缺一不可。
1. Logs 日志:记录细节,用于问题复盘
日志是最细粒度的运行记录,完整留存每一次执行的入参、节点、异常、时间戳、输出结果,用于精准还原故障现场。
Skill 工程统一四级日志规范:
- INFO:正常流程记录(启动、参数接收、节点完成、结果输出)
- WARN:潜在隐患记录(参数不规范、缓存失效、非致命异常)
- ERROR:功能故障记录(解析失败、IO 异常、业务报错)
- FATAL:致命崩溃记录(启动失败、全局中断、初始化异常)
实战案例:技能偶尔返回空白结果,无显性报错。通过检索 WARN 日志,定位到第三方 API 偶发空值返回,精准修复兜底逻辑。
2. Metrics 指标:量化状态,用于全局监控
将技能运行状态数据化、可视化,告别“感觉稳定、偶尔卡顿”的主观判断,用真实数据评估质量。
Skill 六大核心监控指标:
- 调用指标:总调用次数、高频时段、日均调用量
- 质量指标:执行成功率、失败率、超时率
- 性能指标:平均耗时、最大耗时、慢任务占比
- 缓存指标:缓存命中率、重复请求次数、缓存失效次数
- 异常指标:重试次数、熔断触发次数、接口报错次数
- 资源指标:文件 IO 频次、并发峰值、内存占用情况
3. Trace 链路追踪:串联流程,用于卡点定位
针对组合编排、异步并发、多 API 联动的复杂技能,链路追踪会串联全流程,记录每一个子节点的执行时长、运行状态、依赖关系。
解决核心痛点:整体执行慢、整体报错,但不知道具体卡在哪一步、哪一个子技能。
实战案例:自动化报表技能整体耗时 4s,体验卡顿。通过链路追踪发现,天气 API 节点耗时占比 75%,针对性增加缓存、超时优化后,整体耗时压缩至 1s 内。
四、三级告警机制:从被动排错到主动预警
可观测体系的最终价值是提前发现问题、自动止损,工程化落地三套告警策略:
- 阈值告警:固定数值触发,如单次执行超时3s、连续3次调用失败,立即告警
- 趋势告警:监控数据渐变,如平均耗时持续上涨、缓存命中率持续下跌,提前预警性能退化
- 状态告警:捕捉非常规运行状态,如参数空值、上下文丢失、分支异常跳转
五、可观测性标准化落地流程
从零搭建完整 Skill 可观测体系,遵循七步标准化流程,适配所有自研、自定义、编排类技能:
- 全节点埋点:在启动、入参解析、核心执行、API调用、结果输出、异常捕获全流程埋点
- 日志分级规范:统一日志格式、时间戳、场景描述,区分开发调试日志与生产日志
- 核心指标接入:开启调用、成功率、耗时、缓存、异常全维度统计
- 复杂链路追踪:编排、并发、多工具联动技能强制开启链路追踪
- 告警规则配置:配置阈值、趋势、状态告警,过滤无效噪音告警
- 定期数据复盘:统计高频故障、高耗时节点,反向驱动功能优化与性能迭代
- 故障闭环归档:每次问题记录原因、修复方案、优化策略,形成运维知识库
六、落地效果对比:黑盒技能 vs 可观测技能
| 对比维度 | 传统黑盒技能 | 可观测体系技能 |
|---|---|---|
| 故障发现 | 被动等待用户反馈,问题滞后严重 | 主动预警,隐患提前感知、提前处理 |
| 问题定位 | 盲目试错,排查耗时久、无法复现 | 链路+日志精准定位,秒级锁定故障节点 |
| 性能优化 | 凭经验优化,无法精准定位瓶颈 | 数据驱动,针对性优化高耗低效节点 |
| 迭代质量 | 隐性退化频发,越迭代越不稳定 | 指标对比监控,迭代质量可控可追溯 |
| 运维成本 | 排查难度大、维护成本极高 | 轻量化运维,故障快速闭环 |
七、工程化最佳实践
- 简单技能重日志,复杂技能重追踪:单功能技能完善日志体系,编排并发技能强制开启链路追踪
- 日志轻量化分级输出:开发环境详细打印,生产环境精简留存,避免日志刷屏拖慢性能
- 指标量化不主观:所有质量、性能评估以数据为准,杜绝“感觉稳定、感觉流畅”
- 告警精准去噪音:合理配置阈值,避免频繁无效告警,聚焦核心故障
- 观测反哺迭代:以监控数据为依据,持续优化性能、修复高频隐患
八、总结
Skills 监控与可观测性,是整套 AI 技能工程化体系的运维质量终章。功能开发解决“能不能用”,性能优化解决“快不快”,测试调试解决“稳不稳定”,可观测性解决“能不能长期、安全、可控量产”。
通过日志细节复盘、指标量化监控、链路全程追踪三大核心能力,彻底打破技能运行黑盒状态,实现故障可定位、性能可量化、迭代可追溯、风险可预警。让零散的脚本工具,真正升级为透明可控、稳定运维、可规模化商用的工业化 AI 技能体系。
0 条笔记