本课目标
理解存储层次设计的核心思想;掌握Cache基本原理、三种地址映射方式;熟悉Cache替换策略与写策略;理解Cache命中率、平均访问时间计算;理清Cache、主存、辅存之间协同工作逻辑。
8.1 存储层次设计思想
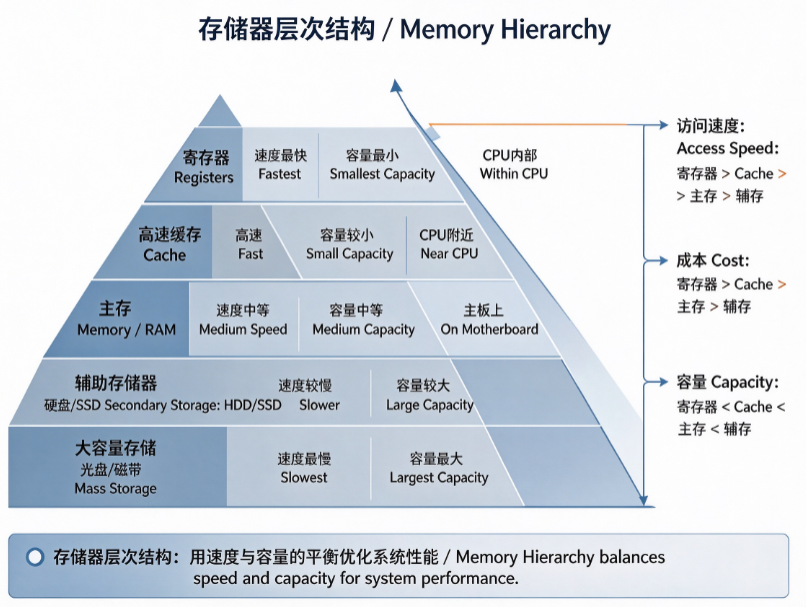
单独一种存储器无法同时满足速度快、容量大、价格低三个需求:高速存储单元成本昂贵,大容量存储速度偏慢。
因此现代计算机采用分层存储,将不同类型存储器组合:上层作为下层的高速缓存,把CPU频繁访问的数据放在离CPU更近、速度更快的存储介质中。
存储层级从CPU向外依次:
寄存器 Registers → 高速缓存 Cache(L1/L2/L3) → 主存 Main Memory → 辅助存储 Secondary Storage
核心局部性原理(Cache能够生效的理论基础)
- 时间局部性 Temporal Locality:刚被访问过的数据,短时间内大概率再次被访问;
- 空间局部性 Spatial Locality:访问某一地址的数据,相邻地址的数据也很可能被访问。
8.2 Cache 基本工作原理
Cache是介于CPU与主存之间的高速小容量存储器,由SRAM构成。
CPU读取数据时:
- 先访问Cache;
- 命中 Hit:Cache中存在目标数据,直接读取,访问延迟很小;
- 缺失 Miss:Cache没有目标数据,需要从主存读取数据块,同时把这块数据拷贝进Cache,供后续访问使用。
块(Block / Line):Cache与主存之间数据传输的基本单位,一次传输一整块连续数据,利用空间局部性。
性能指标
- 命中率 Hit Rate:命中次数 / 总访问次数
- 缺失率 Miss Rate = 1 − 命中率
- 平均访问时间 $T_{avg}=HitTime + MissRate\times MissPenalty$
命中时间:访问Cache耗时;缺失损失:从主存调入数据块的额外延迟。
8.3 Cache地址映射方式(重点)
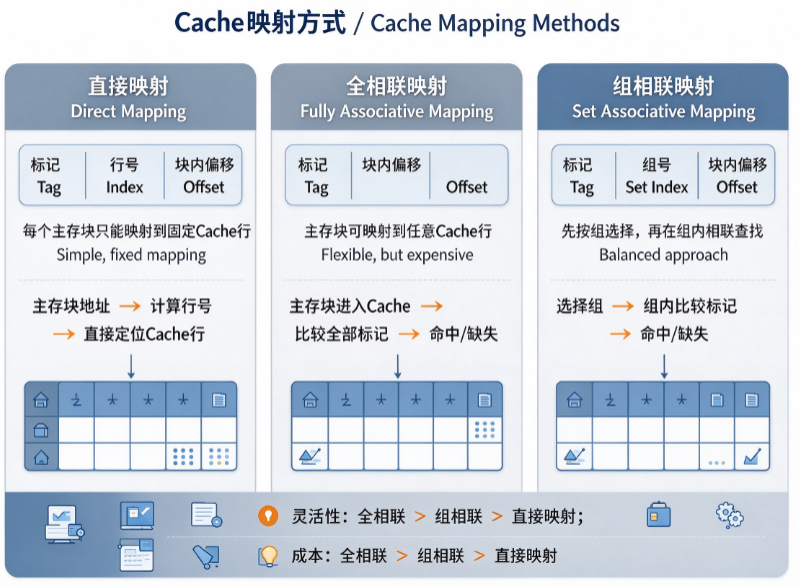
主存块放到Cache行,有三种映射规则,用来确定主存块可以放在Cache的哪些位置:
直接映射 Direct-Mapped Cache
主存块只能映射到Cache唯一固定行。
公式:Cache行号 = 主存块号 mod Cache总行数
优点:硬件简单,查找速度快;缺点:容易发生冲突缺失,即使Cache有空行,同映射位置的块会互相挤掉。全相联映射 Fully Associative Cache
主存块可以放入Cache任意空闲行。
优点:冲突缺失极少;缺点:硬件复杂,需要同时比较所有Cache行标记,成本高,速度慢。组相联映射 Set-Associative Cache
折中方案。Cache划分为多个组;主存块先映射到固定组,块可以存放在组内任意一行。
例如2路组相联:每组包含2个Cache行。兼顾硬件复杂度与冲突缺失率,现代CPU普遍使用。
8.4 Cache替换策略
当Cache已经存满,又有新主存块需要调入,必须淘汰旧块。常见替换算法:
- LRU(Least Recently Used)最近最少使用:淘汰最长时间没有被访问的数据块。综合性能最好,CPU最常用;
- FIFO 先进先出:按调入顺序淘汰最早进入Cache的块;实现简单,但会出现Belady异常;
- 随机替换 Random:随机挑选块淘汰,硬件最简单,性能较差。
8.5 Cache写策略
CPU写数据时,需要同步Cache与主存,两种主流方案:
- 写直达 Write Through:写Cache的同时,同步写入主存。主存数据永远保持最新;缺点:每次写操作都访问主存,写延迟高。
- 写回 Write Back:只写入Cache,不立刻更新主存。当Cache块被替换淘汰时,才一次性写回主存。速度更快;需要增加脏位Dirty Bit标记:脏位=1代表Cache内数据和主存不一致。现代CPUCache默认使用写回。
本课小结
存储器层次结构依靠局部性原理,平衡速度、容量、成本。Cache作为主存高速缓冲,分为直接映射、全相联、组相联,组相联是工程主流。LRU是最常用替换算法;写直达和写回是两种写策略,写回性能更优。平均访问时间用来量化评估Cache整体性能。
思考练习
- 时间局部性与空间局部性分别是什么?为什么它是Cache可行的基础?
- 简述直接映射、全相联、组相联的优缺点。
- LRU替换算法原理是什么?
- 写直达与写回Cache的区别,脏位Dirty Bit作用是什么?
0 条笔记