你选AI工具的时候,是不是只看“好不好用、免不免费”?
其实你选的不只是一个工具,更是一条技术路线。选闭源还是开源?选云端还是本地部署?选海外厂商还是国产厂商?这些选择会直接影响你的工作效率、数据安全和长期成本。
如果你在考虑职业发展,更需要知道哪些公司在引领技术,哪些方向代表未来。
这篇不讲枯燥的行业新闻,帮你搭一个完整的认知框架,看懂AI行业的玩家格局、技术路线、商业模式和未来趋势。
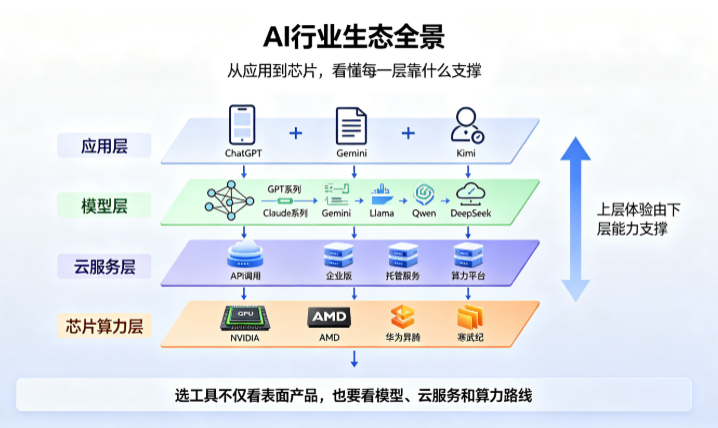
一、全球主要玩家:三分天下的格局
AI行业的玩家大致可以分成三类:美国头部公司、中国头部公司、特色独角兽,各有各的技术路线和产品策略。
1. 美国头部公司:技术领先的第一梯队
美国在大模型技术上整体处于领先地位,四家公司最具代表性:
| 公司 | 核心模型 | 核心特点 | 代表产品 |
|---|---|---|---|
| OpenAI | GPT-4、GPT-4o | 技术标杆,商业化最成熟 | ChatGPT、GPTs |
| Anthropic | Claude 3/3.5 | 安全优先,长文档能力极强 | Claude.ai |
| Google DeepMind | Gemini | 多模态能力强,研究底蕴深厚 | Gemini应用 |
| Meta AI | Llama系列 | 开源路线主力,免费开放 | Llama 3/3.1 |
简单说:追求最强能力选OpenAI,处理长文档选Anthropic,多模态选Google,想免费商用选Meta的Llama。
2. 中国头部公司:快速追赶的本土生态
中国AI公司在中文理解、本土场景落地上优势明显,也形成了完整的产品矩阵:
| 公司 | 核心模型 | 核心特点 | 代表产品 |
|---|---|---|---|
| 百度 | 文心大模型(ERNIE) | 布局最早,政企落地案例丰富 | 文心一言、文心千帆 |
| 阿里巴巴 | 通义千问(Qwen) | 开源力度大,参数档位齐全 | 通义千问、阿里云百炼 |
| 腾讯 | 混元大模型 | 擅长视频生成、数字人、社交场景 | 腾讯混元助手 |
| 字节跳动 | 豆包大模型 | 多模态与内容生成优势突出 | 豆包AI、Coze扣子 |
| 月之暗面 | Moonshot系列 | 主打超长上下文,百万字文档读取 | Kimi智能助手 |
| 深度求索 | DeepSeek | 代码能力顶尖,大规模开源 | DeepSeek Chat/Coder |
除此之外还有智谱AI、稀宇科技等厂商,各有侧重。整体来看,中文场景、本土数据安全、企业定制化,是国产模型的核心优势。
3. 全球独角兽:小而强的特色玩家
还有一些创业公司,成立时间不长但技术特点鲜明:
- Mistral AI(法国):模型以小而精著称,效率高,MoE架构领先;
- Cohere(加拿大):主打企业服务和检索增强;
- SpaceXAI(原 xAI,美国):马斯克旗下,2026年2月被SpaceX收购,同年5月正式由 xAI 更名为 SpaceXAI,不再作为独立公司运营,成为 SpaceX 旗下 AI 产品线,主打真实信息与推理,拥有超大规模算力基础设施,代表产品为 Grok 大模型。
二、路线之争:开源 vs 闭源,怎么选不踩坑
这是AI行业最核心的路线选择,直接决定你的数据安全、使用成本和可控性。
先搞懂:什么是开源,什么是闭源?
- 闭源模型:模型不对外开放,你只能通过网页或API调用,看不到内部权重。代表:OpenAI、Anthropic。
- 开源模型:可以下载完整模型权重,能在自己设备上运行,还能修改和二次发布。代表:Llama、Qwen、Mistral、DeepSeek。
注意:很多号称“开源”的模型其实是“开放权重”,有商业使用限制,商用前要看清许可协议。
一张表看懂两者优劣
| 对比维度 | 闭源模型 | 开源模型 |
|---|---|---|
| 能力上限 | 通常更强,代表当前最高水平 | 追赶中,但差距在快速缩小 |
| 数据隐私 | 数据要传给第三方厂商 | 数据留在本地,不流出 |
| 使用成本 | 按Token按量付费,用量大成本高 | 一次性硬件投入,长期成本低 |
| 定制能力 | 有限,只能通过提示词调整 | 完全可控,可微调、可量化 |
| 部署难度 | 零部署,开箱即用 | 需要技术团队部署维护 |
| 更新速度 | 厂商持续更新,自动升级 | 需要自己跟进新版本 |
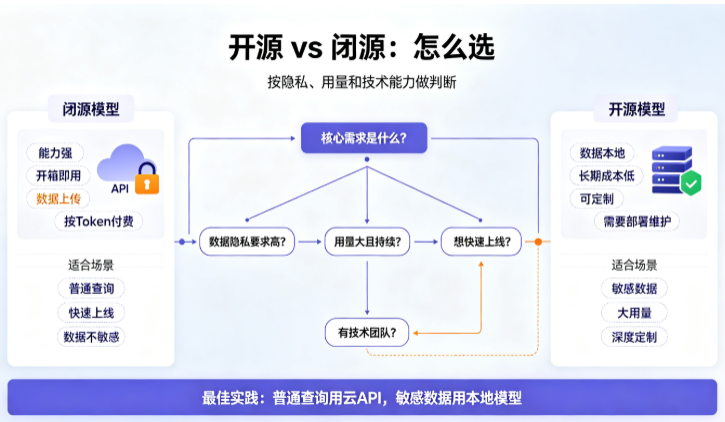
怎么选?记住这个策略
- 选闭源:追求最强能力、数据不敏感、用量不大、想快速上线;
- 选开源:数据极度敏感不能出公司、用量很大API付费太贵、需要深度定制、有技术团队。
最实用的是混合策略:普通查询用云API,敏感数据用本地模型;白天高峰用云服务,夜间批量任务用本地跑。
三、部署方式:云AI vs 本地AI
另一个重要选择是:用云端的AI服务,还是在自己电脑/服务器上跑模型?
云AI:开箱即用,不用折腾
就是通过网页或API调用云端的AI服务,不用管模型部署在哪、用了多少GPU。
- 优点:零初始成本、即用即付、能力上限高;
- 缺点:数据要上传、长期用成本高、依赖网络。
本地AI:完全可控,数据不落地
在自己的电脑或服务器上运行开源模型,数据完全不离开设备。
- 优点:数据隐私、无持续费用、速度稳定;
- 缺点:需要买显卡、有技术门槛、模型大小受显存限制。
常见的本地部署工具:Ollama(一键启动,适合新手)、LM Studio(图形界面)、vLLM(高性能生产部署)。
个人建议
先用云AI体验和探索,熟悉之后如果有强隐私需求或者用量很大,再考虑本地部署。个人学习用,一张消费级显卡就能跑7B-13B的模型。
四、底层基石:算力、芯片与云服务
AI不只是软件,底层的算力才是整个行业的根基。
为什么英伟达几乎垄断了AI芯片?
训练和跑大模型主要靠GPU,而NVIDIA(英伟达)几乎统治了这个市场,核心原因有三个:
- CUDA生态:几乎所有AI框架都优先支持CUDA,软件生态最完善;
- 大显存:专业卡有80GB甚至更大显存,能跑大模型;
- 工具链完善:各种优化库、编译器、开发工具最齐全。
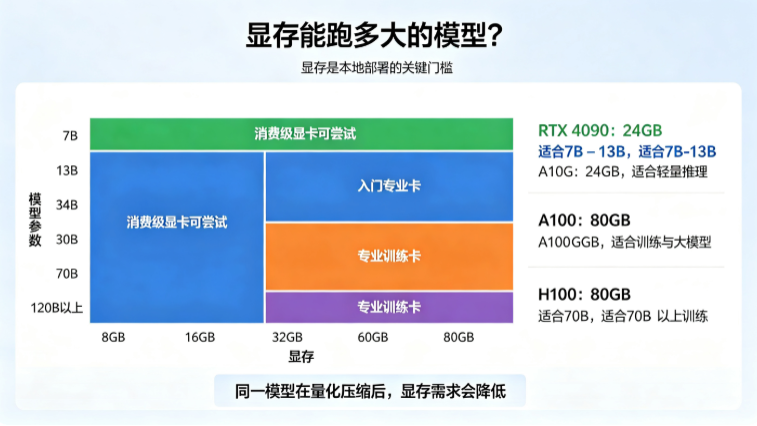
常见显卡怎么选?显存是关键
显存大小基本决定了你能跑多大的模型,大致对应关系:
- 7B模型:需要8-16GB显存
- 13B模型:需要16-32GB显存
- 70B模型:需要60-80GB显存
常见显卡定位:
| 卡型 | 显存 | 定位 | 适用场景 |
|---|---|---|---|
| RTX 4090 | 24GB | 消费级旗舰 | 个人学习、小模型推理 |
| A10G | 24GB | 入门专业级 | 轻量推理、小规模微调 |
| A100 | 80GB | 专业级 | 模型训练、大规模推理 |
| H100 | 80GB | 旗舰级 | 70B以上大模型训练 |
云算力:不用买卡,按小时租
不是每个人都买得起几十万的显卡,云厂商提供了“按小时租用算力”的模式。
- 海外:AWS、Azure、GCP,实例类型最全;
- 国内:阿里云、腾讯云等,国内访问快,合规性好。
国产算力替代
华为昇腾、寒武纪、海光等都在发展国产AI芯片,目前还在追赶阶段,主要差距在软件生态。对普通开发者,还是优先选NVIDIA生态,资料最多、坑最少。
五、AI公司靠什么赚钱?三种主流商业模式
1. B2C订阅制:面向个人,按月付费
最常见的模式,比如ChatGPT Plus、Claude Pro,每月十几到二十美元,解锁高级模型和优先访问。
优点是现金流稳定,缺点是需要持续提供价值,否则用户会取消订阅。
2. B2B API调用:按用量付费
开发者和企业调用API,按Token(可以理解成AI处理的字数)计费,用多少付多少。
举个直观的账:假设每天10万次查询,每次1000Token,用GPT-4o的话,每天成本约20美元,每月600美元。用量再大,成本会快速上升——这也是很多大公司最终选择自托管开源模型的原因。
3. 开源生态变现:模型免费,服务收费
模型本身免费下载,但公司靠托管服务、企业版支持、咨询、定制训练等周边服务赚钱。Mistral就是典型代表。
三种模式对比:
| 模式 | 目标用户 | 收入稳定性 | 技术要求 |
|---|---|---|---|
| 订阅制 | 个人用户 | 中等 | 需要优秀产品体验 |
| API调用 | 开发者、企业 | 高(用量驱动) | 需要稳定的服务 |
| 开源生态 | 企业、开发者 | 较慢 | 需要社区运营能力 |
六、监管常态化:AI不再野蛮生长
AI发展太快,各国都在出台监管政策,了解这些能帮你规避风险。
欧盟《AI法案》:最严格,按风险分级
核心思路是按风险等级监管:
- 不可接受风险:社会评分、实时人脸识别,直接禁止;
- 高风险:医疗、法律、招聘,严格合规,高透明度;
- 中风险:聊天机器人、内容生成,需要标识是AI生成;
- 低风险:游戏、修图,基本无要求。
只要你的产品服务欧盟用户,就要遵守这套规则。
中国监管框架
核心是《生成式人工智能服务管理暂行办法》,重点要求:生成内容真实准确、内容审核完善、数据来源合法、算法透明可解释。
对个人的影响
最需要注意两点:
- 公开发布的AI生成内容,应该有明确标识,不要冒充人工创作;
- 处理个人数据时,要遵守数据保护相关法规。
七、2026年行业趋势:5个清晰的方向
站在2026年的节点,有几个趋势已经非常明确,直接影响每个人的选择。
趋势一:模型能力继续提升,但边际效益递减
更强的模型还会不断出,但每次升级带来的惊喜会越来越小。不是技术遇到瓶颈,而是“够用”的场景已经越来越多了。
应对:关注新特性,但不用盲目追新,够用就好。
趋势二:开源模型持续追赶,差距缩小
顶级开源模型的表现已经非常接近头部闭源模型,而且免费可用。未来会有更多公司加入开源阵营,生态会越来越完善。
应对:可以学习开源工具栈,未来本地部署会越来越可行。
趋势三:应用层开始爆发,Agent走向实用
前几年是模型层的竞争,现在重心开始转向应用层。能自主完成复杂任务的AI Agent(智能代理),会从概念真正走向实用。
应对:把AI和你的行业、你的工作结合,机会在应用层,不在模型层。
趋势四:多模态成为标配
纯文本模型会越来越少,能同时处理文字、图片、音频、视频的多模态模型会成为标配。
应对:拓展思路,不要只用来处理文字,多模态场景有更多机会。
趋势五:监管全面落地
各国监管框架会逐步落地,AI行业从“野蛮生长”进入“规范发展”阶段。
应对:了解基本法规,合规使用,避开高风险领域。
写在最后
了解AI行业生态,不是为了凑热闹,而是为了做选择的时候心里有底。
对大多数人来说,不用纠结太深的技术细节,记住三个实用原则就够:
- 普通日常使用,选云端闭源工具,省心省力,效率最高;
- 敏感数据、大用量场景,优先考虑开源本地部署,长期更可控也更划算;
- 比起追最新的模型参数,更值得花时间的,是把AI真正用在你的领域、你的工作里。
工具永远是手段,解决你的问题,才是最终目的。
0 条笔记