从“一问一答”到“自动做事”:一文读懂AI Agent智能体
你平时用AI是不是这样:问一个问题,给一个答案;让写文案,就写一篇文案。每一步都要你手动推进。
但如果任务复杂一点呢?比如“帮我查明天北京天气,超过25度就推荐300元以内的短袖,再整理成邮件发给老板”。用普通聊天AI,你得分三步操作,每一步都要自己触发。
而 AI Agent(智能体) 不一样:你只说一遍目标,它会自己拆分步骤、调用工具、调整方向,直到把事做完。
简单说:普通大模型是“军师”,只给你出主意;AI Agent是“执行者”,拿到目标自己就去落地。
一、AI Agent vs 普通大模型:到底有什么不一样
很多人分不清两者的区别,用一张表就能看明白:
| 特性 | 普通大模型(LLM) | AI Agent |
|---|---|---|
| 交互模式 | 一问一答,用户驱动 | 自主执行,目标驱动 |
| 能力边界 | 只有模型内置能力 | 可通过工具无限扩展 |
| 记忆 | 仅会话上下文,且有限 | 短期记忆+长期记忆 |
| 规划能力 | 无,或需用户一步步引导 | 自主任务分解与步骤规划 |
| 反馈循环 | 单次生成,做完就结束 | 观察-思考-行动,循环迭代 |
举个最直观的例子:“帮我订一张明天上海去北京、1500元以内的机票。”
- 普通LLM:会告诉你“可以去某某网站查询”,或者帮你写一段查询代码,但它不会真的去查,更不会帮你下单;
- AI Agent:会先理解目标,然后自己调用机票API,拿到航班列表后筛选符合预算的,再对比起降时间,最后给你推荐选项甚至帮你锁定座位。
核心区别:普通LLM给你“答案”,Agent给你“结果”。
二、一个完整的Agent,由四大核心组件构成
如果把Agent比作一个人,它的身体由四个部分组成,各司其职,配合完成任务。
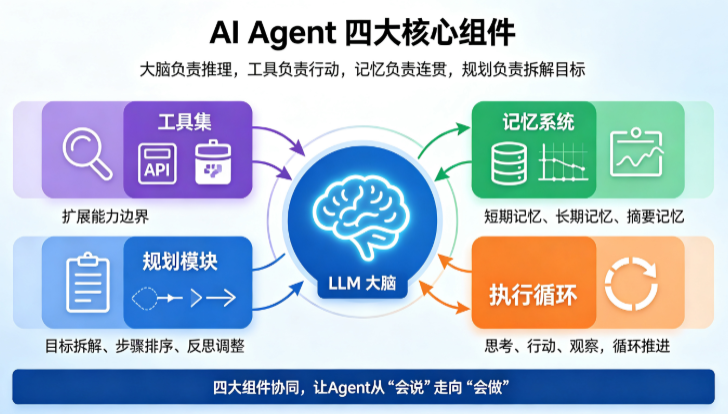
1. 大脑:LLM作为推理核心
大模型就是Agent的大脑,负责四件事:
- 理解用户意图:用户说的话,真正想要的是什么;
- 行动决策:下一步该做什么,调用什么工具;
- 参数生成:要调用工具的话,该传哪些参数;
- 总结输出:信息收集齐了,怎么整理成清晰的回答。
LLM是核心,但不是全部。就像人脑很重要,但光想不做,什么事也成不了。
2. 工具:扩展能力的边界
原生大模型有两个天生短板:知识有截止日期、没法直接和外界系统交互。工具就是用来补这两块短板的。
常见的工具类型:
- 搜索工具:获取最新信息,比如联网搜索;
- 计算工具:执行数学运算、复杂公式;
- 文件操作:读写本地文档、表格、PDF;
- API调用:和外部系统交互,比如订机票、发邮件、查天气;
- 数据库查询:用SQL存取结构化数据;
- 代码执行:运行代码解决问题。
给Agent配上工具,就像给人配上电脑、手机和各种设备——瞬间从“只能想”变成“可以做”。
3. 记忆:短期+长期,分层管理
原生大模型是“失忆的”:每次对话都像第一次见。而Agent需要记住事情,才能连贯做事。
记忆分三层:
- 短期记忆:当前会话的对话、中间步骤、工具返回结果,直接放在LLM上下文里;
- 长期记忆:用户偏好、历史任务、经验知识,存在向量数据库里,需要的时候检索出来;
- 摘要记忆:太久远的对话,让LLM压缩成摘要保存,既保留关键信息,又省Token。
4. 规划:把大目标拆成小步骤
复杂任务不可能一步做完,Agent需要能把大目标拆解成可执行的小步骤。
比如“策划一场10人生日派对”,它会拆成:确认预算时间地点→查询附近场地→设计菜单→列出采购清单→生成日程表。
常用的规划策略:
- 链式思考:一步一步想清楚先后顺序;
- 反思机制:做完一步回头看,有没有问题,需不需要调整;
- 树状规划:同时考虑多条路径,选最优的走。
三、Agent怎么干活?ReAct循环:思考→行动→观察
Agent处理任务的标准流程,叫 ReAct框架,名字来自Reasoning(推理)和Acting(行动)的结合。
它的核心逻辑非常朴素:像人一样,想一步、做一步、看一看结果,再决定下一步,循环直到做完。
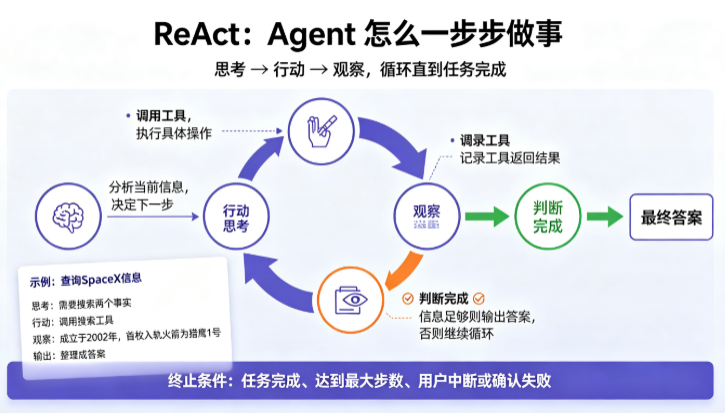
每一轮循环包含三步:
- 思考(Thought):基于当前信息,分析下一步该做什么、为什么这么做;
- 行动(Action):选择合适的工具,执行具体操作;
- 观察(Observation):记录工具返回的结果,作为下一步的依据。
走完一轮,回到思考环节,根据观察到的新信息,继续判断下一步。这个循环会一直转,直到任务完成。
举个完整的例子
用户问题:“SpaceX成立于哪一年?它第一枚成功入轨的火箭叫什么?”
- 思考1:我需要查两个信息,用一次搜索覆盖两个关键词效率最高;
- 行动1:调用网页搜索,查询“SpaceX 成立时间 第一枚入轨火箭”;
- 观察1:搜索结果显示成立于2002年,首枚入轨火箭是猎鹰1号,2008年试飞成功;
- 思考2:信息已经完整,没有歧义,可以回答了;
- 最终回答:整理信息,给出清晰答案。
只用了一轮行动就完成了,所以直接输出答案。如果信息不全,就会继续循环。
必须有的安全阀:终止条件
循环不能无限跑下去,必须设定终止条件:
- ✅ 任务完成:Agent判断信息足够,可以回答了;
- ⚠️ 最大步数:比如最多10步,防止死循环,这是必加的安全阀门;
- 🛑 用户中断:用户主动说“停”;
- ❌ 确定失败:多次尝试都找不到信息,判定任务无法完成。
四、工具调用(Function Calling):Agent的基础技能
工具调用是Agent最核心的基础能力,简单说就是:LLM输出结构化的指令,告诉你它想调用哪个函数、传什么参数,然后你的程序去执行。
不是LLM自己去执行函数,它只负责“决定调用”,真正执行的是你的代码。
完整的工具调用流程
- 注册工具:你先告诉LLM有哪些工具可用,每个工具的名字、用途、参数说明;
- 用户提问:用户输入需求;
- 模型决策:LLM判断该用哪个工具、传什么参数,输出一段JSON格式的调用指令;
- 执行工具:你的程序解析这个JSON,真的去调用API、查数据库或者算数据;
- 返回结果:把工具执行的结果再喂给LLM;
- 生成回答:LLM基于工具返回的结果,整理成自然语言回答用户。
工具定义的关键技巧
工具定义得好不好,直接决定Agent会不会用、用得对不对:
- 描述要清晰:工具的
description要写明白“什么时候用这个工具”,越具体越不容易选错; - 参数要明确:每个参数是什么意思、格式是什么,都说清楚;
- 必填项标注:哪些参数是必须的,哪些可选,明确标出;
- 枚举约束:可选值有限的参数,用枚举列出来,LLM就不会乱传值。
五、主流框架:不用从零开始造轮子
不用自己从零写Agent系统,有成熟的开源框架可以直接用:
| 框架 | 特点 | 最适合场景 |
|---|---|---|
| LangChain Agents | 生态最丰富,工具集成多,开箱即用 | 通用场景、大多数应用 |
| LlamaIndex Agents | 侧重数据连接,擅长和文档、数据库打交道 | 文档问答、私有知识库Agent |
| CrewAI | 多智能体协作,支持不同角色Agent组队 | 复杂项目、团队式协作场景 |
如果是第一次做,优先从LangChain入手,资料最多,坑最少。
六、Agent不是万能的,这些坑要提前知道
AI Agent很强大,但它远不完美,有非常多典型的失败模式,提前知道能少踩很多坑。
常见的六大失败模式
- 工具选错:该查天气去调用了搜索,该计算去调用了别的。工具定义越模糊,越容易犯这个错;
- 参数传错:日期格式不对、缺必填参数、类型传错,导致工具调用失败;
- 无限死循环:搜不到信息还反复搜同一个关键词,原地打转;
- 过早停止:信息还没收集全,就觉得“够了”,给出不完整的答案;
- 幻觉问题:编造根本不存在的工具、参数,甚至假的搜索结果;
- 缺乏常识:比如用户说“明天”,它不知道是“今天日期+1天”,还去搜“明天是几号”。
怎么让Agent更可靠?
没有完美的方案,但有几个公认有效的缓解策略:
| 策略 | 解决的问题 | 怎么做 |
|---|---|---|
| 人机协同 | 避免走偏路 | 关键步骤先让人类确认,再执行,不追求完全自主 |
| 清晰的工具定义 | 工具选择错误 | 描述写详细,加上使用示例 |
| 重试+容错 | 工具调用失败 | 失败自动重试,把错误信息明确反馈给LLM |
| 强制格式约束 | 参数解析错误 | 用JSON Schema严格校验输出 |
| 反思机制 | 死循环 | 定期让它自检:“我是不是在重复做无用功?” |
写在最后
AI Agent不是什么无所不能的超级智能,它更像一个刚入职的助理——能主动做事,但会犯错,会走弯路,有时候还需要你指点一下。
不用一开始就追求“完全自主”,最实用的打开方式是人机协作模式:Agent提议做什么,你拍板确认再执行。用得越熟,再逐步放权。
说到底,Agent从来不是替代人的工具,而是放大效率的杠杆。真正重要的不是Agent自己能做多少事,而是你能不能用好它,把它变成你的专属“执行团队”。
0 条笔记