让大模型听懂人的喜好:通俗读懂RLHF人类反馈强化学习
同样一个问题,大模型可以生成好几种答案:有的逻辑完整但语气生硬,有的文笔流畅却满嘴瞎话,有的简短有力但态度粗鲁。预训练只会教模型学文本统计规律,但它不知道人类喜欢什么样的回答。
RLHF(基于人类反馈的强化学习,Reinforcement Learning from Human Feedback),就是用来解决这件事的技术:把普通人的主观喜好,转化成模型可以学习的信号,教会大模型输出有用、诚实、安全、符合人类价值观的回答。
GPT‑3.5、ChatGPT之所以对话体验大幅变好,RLHF是背后的关键技术之一。
生活化比喻:
预训练:读全网海量书籍文章,学会怎么说话;
指令微调:学会看懂人类的指令,听懂问题;
RLHF:找人打分评判回答好坏,告诉模型“什么样的回答人类更喜欢”,修正它的说话方式。
一、为什么需要RLHF?指令微调不够用吗?
经过指令微调的模型,已经可以按照指令生成内容,但依然存在不少短板:
- 分不清什么是“好回答”,只会模仿文本,不一定贴合人类主观偏好;
- 容易生成冗长啰嗦、套话满满的回答;
- 容易输出不安全、有偏见、误导性内容;
- 同样的问题,会输出多种结果,但不会主动挑选最舒服、最靠谱的那一个。
指令微调是“教模型正确完成任务”,RLHF是“教模型按照人类的审美与价值观做选择”。
二、RLHF完整的三大阶段
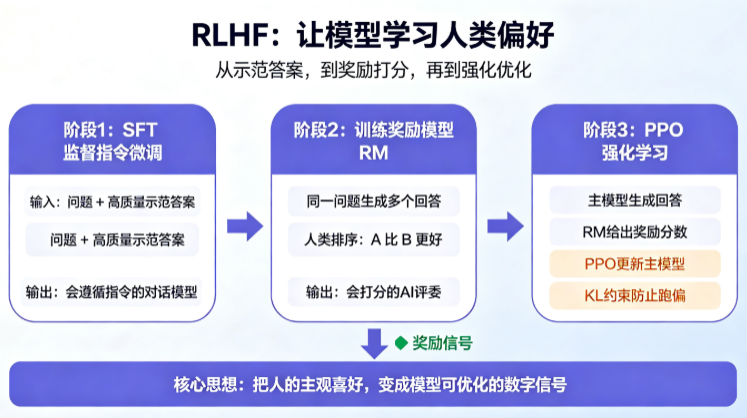
RLHF不是一步训练完成,工业界标准实现分为SFT监督微调、训练奖励模型RM、PPO强化学习三步,环环相扣。
阶段1:SFT 监督指令微调(Supervised Fine‑Tuning)
这是整个流程的地基。
- 操作:收集一批高质量「用户提问 + 人类写的标准答案」样本,对预训练大模型做指令微调。
- 目标:让模型学会遵循指令,知道“收到用户问题应该输出回答”,输出格式大体正确。
注意:这一步不用人类打分,只是人类直接写好示范答案给模型学。
如果SFT质量很差,后面强化学习再强也救不回来。
阶段2:训练奖励模型 RM(Reward Model)——把人的喜好变成分数
这是RLHF最核心的一步:把人类主观好坏,变成机器可以计算的数字分数。
- 拿同一个用户提问,让经过SFT的模型生成多个不同版本的回答(A、B、C、D);
- 交给标注人员,不要求写答案,只做排序打分:把几个回答从最好到最差排顺序;
- 使用这些“回答优劣排序”的数据,训练一个独立的奖励模型RM。输入问题+回答,RM输出一个数字奖励分,分数越高代表人类越喜欢这个回答。
通俗理解:奖励模型就像一个AI评委,学懂了人类的审美。以后任意一段回答丢进去,它就自动给出一个“人类满意度”分数。
小细节:人类做排序比直接打1‑10分更稳定。人很难精准给出7分还是8分,但很容易分辨A回答比B回答更好。
阶段3:PPO近端策略优化,强化学习迭代主模型
现在我们有了能打分的奖励模型,接下来用强化学习去更新原始对话模型。
- 用户输入问题,主模型生成回答;
- 把回答送入奖励模型RM,拿到奖励分数;
- PPO算法利用这个分数,反向更新主模型:高分的回答,鼓励模型以后多生成类似内容;低分的回答,让模型少生成这类内容;
- KL散度约束(非常关键):强制新模型输出不能和SFT基线模型差距过大。防止模型为了拿高分,胡说八道、投机取巧,发生“奖励黑客”问题。
什么叫奖励黑客?模型发现某种话术可以拿高分,但内容本身质量很差,一味讨好奖励模型,偏离真实需求。KL约束用来锁住模型,不让它跑偏太远。
三、RLHF遇到的现实难题
RLHF效果很强,但工程落地麻烦多多,有不少天生缺陷。
- 标注成本昂贵
需要大量人类标注员做 pairwise 对比排序,人力成本高,标注质量还受标注员主观影响,不同人标准不一样。 - 奖励黑客(Reward Hacking)
模型钻奖励模型的漏洞。比如奖励模型喜欢长回答,模型就堆砌废话、写一大段空洞文字拿高分,但实际没有信息量。 - 模式崩溃、退化问题
过度强化之后,模型回答变得千篇一律,话术模板化,创造力下降。 - 人类偏好很难统一
不同人群价值观不一样,一个回答对A群体很好,对B群体可能不合适,很难找到一套“通用完美标准”。 - 训练复杂,调参难度高
PPO强化学习本身调参门槛高,对算力要求大,小规模团队很难完整复现原版RLHF。
| 环节 | 主要风险 | 缓解手段 |
|---|---|---|
| SFT阶段 | 示范样本质量差 | 严控数据集质量,扩大高质量样本 |
| 奖励模型RM | 学错人类偏好 | 增加多样性标注,校验RM打分一致性 |
| PPO强化学习 | 奖励黑客、模式退化 | KL惩罚约束,控制强化学习迭代轮次 |
四、RLHF的现代替代方案:DPO直接偏好优化
原版RLHF流程长、复杂难调参。后来业界推出DPO(Direct Preference Optimization)直接偏好优化,现在已经广泛使用。
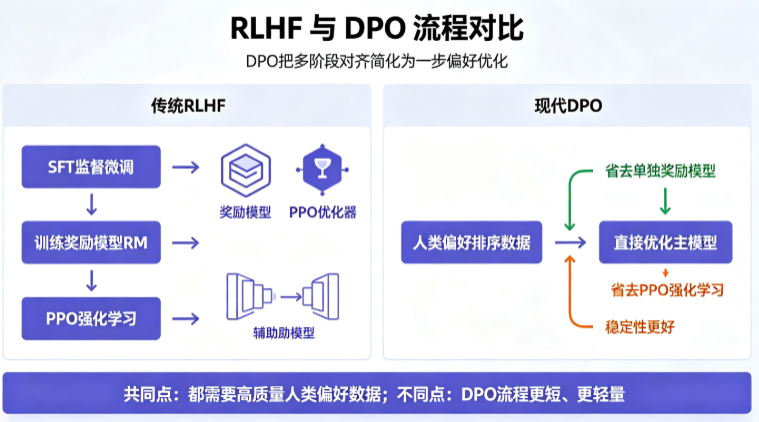
- 原版RLHF:SFT → 训练奖励模型RM → PPO强化学习,三大阶段,两套模型;
- DPO:不需要单独训练奖励模型,也不用PPO强化学习,直接拿人类偏好排序数据,一步优化主模型。
简单讲,DPO把“先训奖励模型,再跑PPO”合并成一步。输入同样是人类偏好对比数据,直接更新对话模型参数。
✅ DPO优势:
- 流程简化,代码、算力开销下降;
- 减少中间环节带来的误差累积;
- 不容易出现奖励黑客,稳定性更好。
现在很多开源大模型对齐,优先使用DPO替代传统RLHF。但要注意:DPO依然需要人类偏好排序数据集,数据质量依旧是第一位,不是换个算法就万事大吉。
五、RLHF、指令微调、RAG、微调之间是什么关系?
很多人容易把这几个概念混在一起,简单梳理分工:
- 预训练:海量原始文本,学习语言、常识;
- SFT指令微调:学习遵循人类指令,学会输入输出格式;
- RLHF / DPO对齐:学习人类的喜好、价值观、安全边界;
- 普通LoRA微调:学习业务风格、输出格式、领域术语;
- RAG检索增强:补充事实知识,解决时效性、私有文档。
它们不是二选一,现代大模型是这套流水线层层叠加出来的。
举个企业场景例子:
基础开源大模型 → SFT指令微调教会对话 → DPO做安全对齐 → LoRA微调学习客服语气 → RAG接入产品知识库回答业务问题。
六、哪些场景适合RLHF/DPO,哪些不适合
✅ 适合做人类对齐:
- 通用对话模型,需要符合人类价值观、安全规范;
- 需要区分回答好坏,优化主观体验(回答更友好、简洁、得体);
- 希望模型拒绝有害提问,减少不安全输出。
❌ 不建议上来就用:
- 只需要灌输大量事实知识,优先RAG;
- 只是想要固定输出格式、简单业务话术,优先SFT/LoRA微调;
- 没有高质量人类偏好对比数据集,不要碰RLHF/DPO,效果会严重打折。
重点提醒:RLHF/DPO不能彻底消除幻觉。它能改善幻觉问题,但不能根治。事实类校验依然需要RAG和人工复核。
写在最后
RLHF最大贡献,是打通了一条道路:把人的主观感受,变成大模型可以学习的训练信号。
传统训练只能看文本数据,而RLHF让AI能够读懂“人类觉得什么回答更好”。
原版RLHF流程复杂笨重,DPO等新算法降低了对齐的门槛。但万变不离其宗:对齐效果的上限,依然取决于人类标注数据的质量,算法只是放大器,不能弥补烂数据。
对于大多数普通开发者,不用从零实现RLHF。优先选用已经做好对齐的开源模型;只有当通用模型的“品味、安全、回答偏好”完全达不到业务要求的时候,再考虑DPO等对齐方案。
0 条笔记