从模型文件到线上服务:通俗读懂大模型部署
训练完或者下载好一个大模型权重文件,并不代表可以直接给业务系统、给用户使用。大模型部署,就是把模型文件变成稳定可用服务的整套工作:优化、封装、对外提供接口、保障并发、监控运行,让真实用户可以调用AI能力。
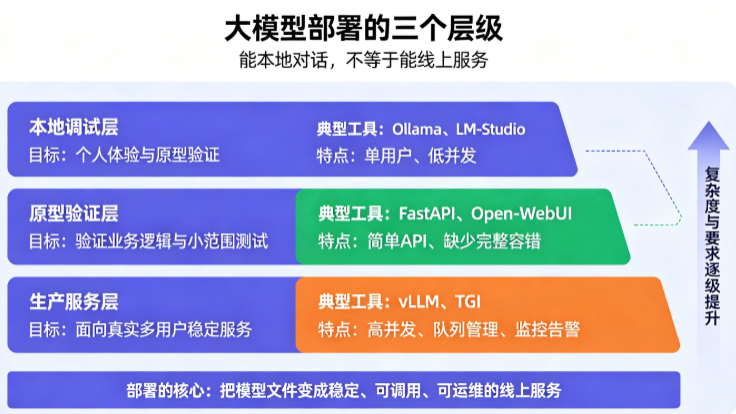
很多人误以为部署就是本地跑通ollama run xxx就算完成,本地能对话只是原型验证;面向多用户、高并发生产环境,要解决速度、显存、并发、稳定性、监控等一大堆工程问题。
通俗比喻:
训练/下载模型 = 造出一台功能强大的发动机;
大模型部署 = 把发动机组装成整车,配上油路、散热、仪表盘,对外开放给很多人同时使用。
一、本地运行、原型部署、生产级部署的区别
很多开发者踩坑,就是混淆了这三个层级,直接把本地demo当成线上服务。
| 类型 | 目标 | 典型工具 | 特点 |
|---|---|---|---|
| 本地运行 | 个人调试、体验模型 | Ollama、LM‑Studio | 单用户,不考虑并发,方便快速体验 |
| 原型部署 | 验证业务逻辑,小范围测试 | FastAPI + transformers、Open‑WebUI | 简单API,并发弱,缺少容错监控 |
| 生产级部署 | 面向大量真实用户 | vLLM、Text Generation Inference(TGI) | 高并发、吞吐量优化、队列管理、监控、弹性扩缩容 |
二、推理:部署的核心环节
部署的核心叫做推理(Inference),推理就是输入提示词,模型计算输出结果。
训练是教模型学知识;推理是用已经学好的模型做回答。
推理分两种输出模式:
- 非流式输出:全部内容生成完毕之后一次性返回结果。适合后台批量处理;用户等待时间长。
- 流式输出(Streaming):一字一段逐步返回,就像ChatGPT逐字打字效果。网页对话产品几乎全部使用流式,用户体验更好。
大模型推理两大核心压力:显存占用、计算速度。
- 显存:既要存放模型权重,又要存放每一个用户对话上下文KV Cache;用户越多,KV Cache占用越高;
- 速度:衡量指标有两个
- TTFT(Time To First Token,首token延迟):用户提问之后,多久看到第一个字,对话体验最重要指标;
- TPOT(Time Per Output Token):每多生成一个字消耗的时间,决定回答输出流畅度。
三、主流推理框架,该选哪一个?
原生Hugging Face Transformers可以跑模型,但没有做高并发优化,不适合生产。生产环境要用专门的推理框架。
1. vLLM
现在业界非常流行的开源推理引擎,核心是**PagedAttention(分页注意力)**技术,借鉴操作系统虚拟内存思路管理KV Cache。
- 优势:显存利用率极高,相同硬件支持更多并发用户;吞吐量大;支持连续批处理;兼容OpenAI接口格式;
- 适合:大多数开源大模型生产部署,个人、企业都大量使用。
2. TGI(Text Generation Inference)
Hugging Face官方推出的推理服务框架。
- 优势:生态适配好,内置量化、流式、日志监控;
- 适合:深度使用Hugging Face生态的团队。
3. Ollama
更多定位本地和简易服务,自带API。
- 优势:上手极其简单;
- 局限:高并发生产场景性能弱,一般不直接对外做线上业务。
4. TensorRT‑LLM
英伟达推出,深度针对NVIDIA显卡硬件做底层优化。
- 优势:极致性能;
- 缺点:配置复杂,对显卡依赖性强。
选型简单建议:
个人原型:Ollama;
中小型生产优先选 vLLM;
Hugging Face深度用户选TGI;
追求硬件极限性能选TensorRT‑LLM。
四、部署的完整流程
1. 模型准备
获取模型权重,一般从Hugging Face下载;根据硬件选择量化版本,如GGUF、GPTQ、AWQ。
AWQ、GPTQ是权重量化格式,专门用于GPU推理;GGUF多用于Ollama、CPU本地推理。
2. 启动推理服务
用vLLM/TGI启动服务,对外提供兼容OpenAI风格HTTP接口。
此时服务只负责接收prompt,返回模型生成内容。
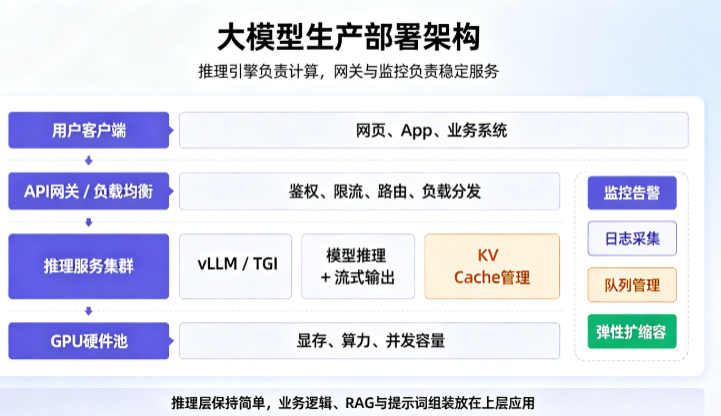
3. 增加网关层(API Gateway)
直接把推理框架暴露公网非常危险,生产环境前面必须加网关:
- 请求鉴权、密钥校验,防止被别人滥用;
- 请求限流,防止瞬间大量请求打垮GPU;
- 负载均衡:多台GPU机器,把请求分发到空闲节点;
- 请求队列,防止并发超过硬件上限。
4. 业务层对接
业务后端调用网关接口,组装提示词、处理RAG检索、处理会话历史、做输入输出过滤。
注意:RAG、提示词组装、会话管理一般放在业务应用层,不要写在推理框架内部。
5. 可观测:日志与监控
需要持续监控关键指标:GPU显存使用率、GPU利用率、队列等待长度、TTFT、TPOT、错误率。
- 如果队列持续堆积,说明GPU算力不足,需要扩容;
- 显存持续打满,容易出现OOM显存溢出崩溃。
6. 上线测试与压测
模拟多用户并发压力测试,观察延迟、报错、显存。不要直接裸上真实流量。
五、三种部署模式:本地、私有化、公有云API
1. 本地部署
模型跑在自己电脑上,适合调试、内部小工具。缺点无法给外部大量用户访问。
2. 私有化部署(本地服务器/私有云GPU)
把模型部署在企业自己拥有的服务器。
✅优点:数据全部不出企业内网,隐私性最好;不依赖第三方API;
❌缺点:需要采购GPU服务器,需要运维人员维护硬件与服务,成本高。
3. 公有云API调用
不部署模型,直接调用厂商提供的接口(OpenAI、通义千问API等)。
✅优点:零硬件运维,开箱即用,弹性扩容;
❌缺点:数据要传给服务商;用量大token费用会很高。
很多企业采用混合模式:通用能力调用公有云API;处理内部敏感文档的模型做私有化部署。
六、关键性能优化手段
1. 量化压缩
AWQ/GPTQ量化,在损失少量效果前提下降低显存占用,单卡可以承接更大模型。
2. KV Cache + PagedAttention
vLLM的PagedAttention高效管理KV缓存,提升并发上限,是现在最重要的优化手段。
3. 批处理
把多个用户请求合并批量送入GPU计算,提高GPU利用率。分为静态批、连续批处理。
4. 合理限制上下文窗口
设置max‑context‑len,不需要超长上下文就不要开最大,减少显存压力。
5. 弹性扩缩容
业务有高峰低谷:高峰期增加GPU实例;低峰期释放资源,节约成本。
现实中GPU很贵,部署的一大艺术就是:在延迟、并发、成本三者之间做权衡,没有完美方案,只有适合业务的平衡点。
七、工程常见踩坑
- 直接把Ollama暴露公网当作生产服务
Ollama适合本地,缺少限流鉴权,高并发性能不足,容易被攻击打崩。 - 忽视KV Cache显存
很多人只估算模型权重显存,忽略多用户并发带来的KV Cache占用,上线直接OOM显存溢出。 - 不做压测直接上线
本地单用户跑很流畅,几十人并发之后,延迟飙升、队列堵塞。 - 把RAG业务逻辑写进推理服务
推理服务应该只做模型计算;检索、会话管理、提示词组装放在上层业务,推理层尽量保持简单。 - 缺少监控告警
GPU跑满、显存溢出、队列堆积,没有人知道,用户大量报错才发现问题。
八、容器与K8s:企业规模化部署
小规模部署直接命令行启动推理程序;当有多GPU多机器、多模型、需要弹性伸缩,就会使用Docker容器打包模型服务,配合Kubernetes(K8s)编排。
- Docker:把推理环境打包镜像,保证开发环境、线上环境一致;
- K8s:管理大量GPU节点,自动调度、故障重启、弹性扩缩容。
个人和小团队不一定需要K8s;但企业级大规模上线,容器编排基本是标配。
写在最后
大模型部署不只是“把模型跑起来”,而是一套完整的工程体系:推理引擎、网关鉴权、队列限流、监控告警、运维扩容。
很多团队把全部精力放在调模型、调提示词,忽略部署工程,结果原型效果很好,一上线并发就卡顿崩溃。
记住一条简单思路:
个人学习原型用Ollama快速跑通;生产优先vLLM/TGI;增加网关、监控、压测再对外提供服务;优先做小规模验证,再逐步扩容,不要一上来追求超大规模架构。
0 条笔记