你可能会说:我只是想用AI而已,干嘛要懂它的工作原理?
其实道理很简单:知道AI的能力从哪来,你才能更清醒地用它。你会知道什么时候该信它、什么时候该质疑;知道它擅长什么、不擅长什么;也会明白“胡说八道”的幻觉从哪来,以及怎么减少它的影响。
不用复杂公式,我们用生活化的类比,把AI工作的核心逻辑讲清楚。
一、神经网络:AI的“大脑”,其实很简单
现代AI的核心是神经网络,名字借鉴了人脑神经元的结构,但做了极大的简化。
从人脑到人工神经元
人脑里大约有860亿个神经元,它们互相连接、传递信号。学习的过程,本质就是调整这些连接的强弱。
人工神经网络沿用了这个思路,但结构简单得多:大量简单的计算单元连在一起,通过调整连接的“权重”来学习。
三层基本结构:从像素到“认出猫”
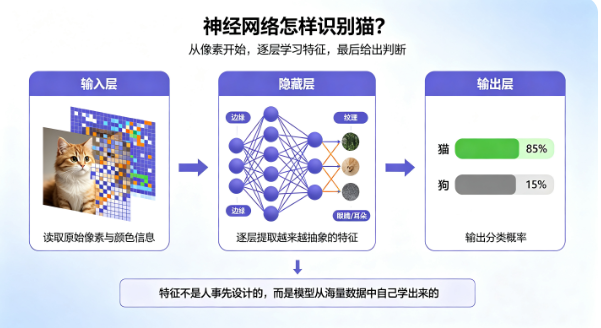
一个典型的神经网络分为三层,我们用“识别一张图是猫还是狗”举例子:
| 层级 | 作用 | 在猫狗识别里做什么 |
|---|---|---|
| 输入层 | 接收原始数据 | 读取图片的每个像素、颜色信息 |
| 隐藏层 | 逐层提取特征 | 从边缘→纹理→耳朵、眼睛等器官,一层比一层抽象 |
| 输出层 | 给出最终结果 | 输出“是猫的概率85%、是狗的概率15%” |
最神奇的地方在于:这些特征不是人事先设计好的,是模型自己从海量数据里学出来的。
第一层可能只会识别“这里有一条竖线”“这里有个圆形”;第二层把它们组合起来,发现“竖线加圆形,可能是一只耳朵”;到更深的层,组合出两只尖耳朵、胡须、猫眼,就判断出“这是猫”。
单个神经元到底在算什么?
单个神经元做的事特别简单,就两步:加权求和 + 激活。
打个比方:就像评委打分。每个输入项(比如“尖的程度”“位置高度”)都有对应的权重(重要程度),把分数按权重加起来,再减去一个门槛值(偏置),过线了就输出,没过就不输出。
比如判断“这是不是猫耳朵”:
- 输入:尖的程度0.8、位置高度0.9、有没有毛0.7
- 权重:尖不尖最重要(0.5),位置其次(0.4),毛最不重要(0.3)
- 算下来总分超过阈值,就输出“可能是猫耳朵”
一个神经元很简单,但当成千上万个神经元分层连在一起,每层学习不同的特征,整体就会产生惊人的智能。
二、训练 vs 推理:十年寒窗 vs 上考场做题
AI的生命周期分为两个完全不同的阶段:训练和推理。搞懂这两者的区别,能解释你对AI的大半疑惑。
训练:寒窗苦读,花大价钱学知识
训练就是给模型喂海量数据,让它反复调整内部参数,预测得越来越准。
比如训练一个猫狗识别模型:
- 准备几百万张已经标注好的图片(这张是猫,那张是狗)
- 让模型猜“这是什么”,一开始基本全猜错
- 告诉它正确答案,让它微调网络里的权重
- 重复几百万次,直到模型预测得越来越准
训练阶段是最烧钱的:一个大模型可能需要几千张GPU连续跑几个月,花费几百万美元。
推理:学会之后,做题就快了
训练好的模型,给它新的输入,它输出结果,这个过程就是推理。
你给ChatGPT发一条消息,它回复你——这是推理;你用手机拍照识别植物——这也是推理。
推理的特点:
- 不需要调整参数,只用训练好的权重做计算
- 算力需求低,单张GPU甚至手机芯片就能跑
- 成本很低,一次调用几分钱甚至几厘钱
一张表看懂区别
| 维度 | 训练(读书) | 推理(做题) |
|---|---|---|
| 核心目标 | 学习知识、调整权重 | 应用知识、给出答案 |
| 数据量 | 需要海量数据 | 单次输入即可 |
| 算力需求 | 极高(几千张GPU) | 很低(单卡/手机) |
| 成本 | 极高(百万美元级) | 极低(每次几分钱) |
| 发生频率 | 几次到几十次 | 每秒数百万次 |
| 谁来做 | OpenAI等大公司 | 普通用户、应用 |
打个最通俗的比方:训练就像十年寒窗苦读,费时间费精力;推理就像上考场做题,一旦学会了,答题就很快。
重要提醒:你平时和ChatGPT聊天,是在推理。模型不会因为你的对话“学习”或者“变聪明”,它的知识截止于训练完成的那一刻。
三、Transformer:让AI真正读懂上下文的核心
2017年Google发表了论文《Attention Is All You Need》,提出了Transformer架构,从此彻底改变了整个AI领域。今天几乎所有的大语言模型,都是基于Transformer。
在它之前,AI读长文总“失忆”
Transformer出现之前,处理句子用的是RNN、LSTM这类模型。它们的问题是:只能一个字一个字地往后处理,两个词隔得远一点,就捕捉不到关联了。
比如这句话:“我把钱包落在了北京的咖啡馆里,第二天回去找,____ 还在。”
人一眼就知道横线填“它”,指的是“钱包”。但旧模型处理到“还在”的时候,可能已经忘了前面“钱包”的存在。
注意力机制:像人一样抓重点
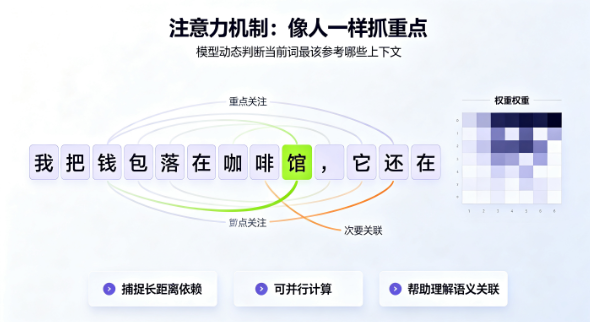
Transformer的核心突破,就是注意力机制。
什么是注意力?打个比方:你读一句话的时候,不是每个字都花同样的精力。看到“它”的时候,你会自动把注意力放在前面的“尾巴”“耳朵”这类关键词上,来判断说的是什么动物。
注意力机制做的就是这件事:根据当前处理的位置,动态给句子里的每个词分配权重,知道该重点关注谁。
所以哪怕“钱包”和“它”隔了十几个字,模型也能精准地把它们对应起来。
注意力机制带来了三个关键优势:
- 能捕捉长距离依赖:隔再远的相关内容都能连上
- 可并行计算:不用一个字一个字处理,可以同时看完整句话,速度快很多
- 有一定可解释性:可以通过注意力权重,看到模型在“看”哪个词
Encoder和Decoder:理解和生成
完整的Transformer分为两部分:
- Encoder(编码器):负责理解输入,把文字变成向量表示,适合文本分类、语义搜索这类任务
- Decoder(解码器):负责根据理解生成输出文本,适合写作、翻译、对话
我们熟悉的GPT、Claude、Llama都是“仅Decoder”架构,所以它们特别擅长生成流畅自然的文本。
四、预训练+微调:从“博学”到“好用”
今天的大模型,基本都采用两阶段训练法:预训练 + 微调。
预训练:读万卷书,学通识
预训练就是把互联网上海量的文本——维基百科、书籍、网页、代码等等,喂给模型,让它只做一件事:预测下一个词。
输入“今天天气真”,让它猜下一个字;输入“1 + 1 = ”,让它猜下一个数字。
这个阶段没有特定任务,就是让模型广泛学习语言规律、常识知识、逻辑、代码等等。预训练是最花钱的部分:数据最多、算力最大、时间最长。
预训练完成的模型,就像一个刚毕业的高材生,博览群书,但还不会“好好干活”。
微调:职业培训,学做事
预训练后的模型虽然博学,但不一定“听话”。
你问它问题,它可能自顾自说个不停,而不是直接回答;你让它写代码,它可能写一半就跑题。
微调就是用高质量的对话数据,再进一步训练模型,教它:
- 理解人类指令,按要求输出
- 保持正常对话风格,拒绝有害请求
- 输出更安全、更有用的内容
微调的数据量比预训练小得多,但对质量要求很高。
一个类比讲透
- 预训练 = 从小学到大学,读万卷书,广泛学习各种通识知识
- 微调 = 毕业后的职业培训,学怎么沟通、怎么写邮件、怎么完成具体工作
预训练让模型有知识,微调让模型好用。这也是为什么同样参数的模型,有的感觉聪明但难用,有的普通但顺手——差别往往就在微调做得好不好。
五、AI为什么会“胡说八道”?幻觉的真相
幻觉(Hallucination)是AI最著名的问题:它经常一本正经地编造不存在的人名、论文、数据,说得比真的还像真的。
本质原因:它在“猜词”,不是在“查事实”
要理解幻觉,先回到AI最底层的工作逻辑:
它不是在查证事实,而是在预测下一个最可能出现的词。
你问“谁发明了电话?”,训练数据里“亚历山大·格雷厄姆·贝尔”这个序列出现的概率最高,所以它答对了;
但你问一个训练数据里没有的问题,它不知道“自己不知道”,只会按照统计规律,编造一个听起来最合理的答案。
幻觉常见的四个原因
| 原因 | 解释 | 例子 |
|---|---|---|
| 训练数据不足 | 话题太冷门,训练数据里很少,模型没学好 | 问一个非常小众的专业问题 |
| 知识截止 | 训练数据之后发生的事,模型不可能知道 | 2024年训练的模型不知道2025年的新事件 |
| 混淆来源 | 把多个来源的信息混在一起,张冠李戴 | 张三和李四经常一起出现,就把李四的论文安给张三 |
| 过拟合 | 训练时把数据里的噪声当成了事实 | 编造出根本不存在的引用文献 |
怎么减少幻觉的影响?
作为普通用户,你可以用这四招:
- 关键信息必核实:涉及医疗、法律、投资、重要事实,一定要去官方渠道查证
- 让模型提供来源:追问“这个信息的出处是什么?”“能给我引用来源吗?”
- 用RAG检索增强:把你自己的文档喂给模型,让它只基于资料回答,不要自由发挥
- 多模型交叉验证:同一个问题问两三个不同模型,答案一致的话可信度更高
记住一句话:AI说的话,听起来再像真的,也可能是编的。涉及高风险决策,永远保持一点怀疑。
写在最后
懂了AI的工作原理,你就不会把它当成无所不知的神,也不会因为它犯错就全盘否定。
它本质上是一个从海量数据里学到语言规律的概率模型:擅长处理有规律、有先例的问题,不擅长凭空查证事实,也没有真正的“理解”和“意识”。
知道它的边界,用好它的长处,规避它的短处,它才是能真正帮到你的高效工具。
0 条笔记