从“只会聊天”到“能看会听”:一文读懂AI多模态
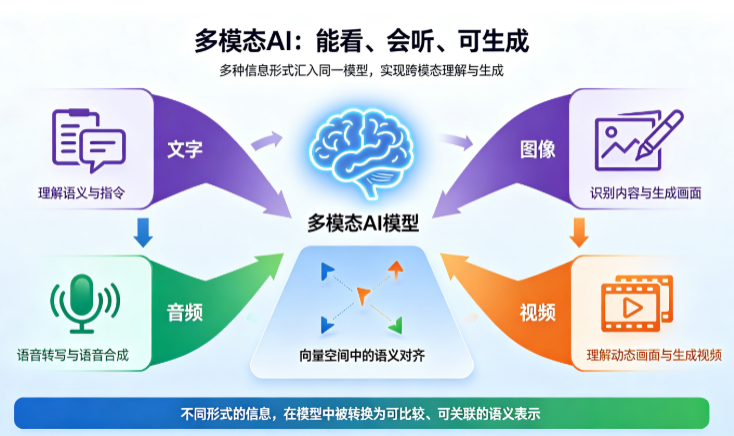
前几年的AI,大多是“单感官”的:文字AI只能写文章,图像AI只能画图,音频AI只能处理声音,各干各的,互不连通。 但现实世界本来就是多模态的——看书有图有字,看电影有画面有声音,面对面交流要看表情听语气。于是多模态AI就出现了:它能同时理解和生成文字、图片、音频、视频多种内容,就像给AI配上了眼睛、耳朵和嘴巴,能用更接近人类的方式和世界互动。
举个最直观的例子:你拍一张购物小票发给AI,它能识别上面的文字(OCR)、读懂买了什么商品、自动整理成表格,还能用语音读给你听。这就是典型的多模态任务——一次输入,跨多种模态处理。
一、先搞懂:什么是多模态AI
单模态 vs 多模态
“模态”简单说就是信息的表现形式。文字、图片、声音、视频,都是不同的模态。
| 类型 | 说明 | 典型代表 |
|---|---|---|
| 单模态AI | 只能处理一种信息类型 | 早期纯文字版GPT、只能画图的Stable Diffusion |
| 多模态AI | 同时处理多种类型,能跨模态理解 | GPT-4o、Claude 3、Gemini |
多模态最核心的突破,是跨模态对齐——它能把不同形式的信息,转换成同一种“语义语言”。 比如看到一张“猫”的图片,它会转换成一组向量;看到“猫”这个汉字,也会转换成向量。这两个向量在数学空间里距离很近,因为它们代表同一个概念。
三个核心挑战
听起来简单,实现起来很难,核心要过三道关:
- 对齐:怎么让图片里的“猫”和文字里的“猫”,在模型看来是同一个东西;
- 融合:同时看到图和文字,怎么把两者的信息结合起来理解;
- 生成:怎么根据文字生成图片,或者根据图片生成文字。
好在这些问题已经逐步被解决,现在的主流大模型,几乎都是多模态的。
二、视觉能力:给AI装上眼睛
图像能力是多模态最成熟的方向之一,分为“看懂图”和“画出图”两类。
1. 图像理解:AI真的能“看”懂
图像理解就是让AI看懂图片内容,不是简单识别像素,而是理解语义。 常见的视觉任务包括:
- 图像描述:这张图里有什么、发生了什么;
- 文字提取(OCR):把图片里的文字扒出来,表格也能还原;
- 图表分析:柱状图、折线图在表达什么,有什么趋势异常;
- 细节检查:帮你找设计稿里的问题、票据里的错误。
主流大模型基本都支持图片输入,使用方式也简单:网页版直接上传图片,API调用则用Base64编码把图片嵌在请求里。
2. 文生图:文字描述变出图片
输入一段文字,就能生成对应图片,这是大家最熟悉的多模态应用。
扩散模型:怎么从文字变出图的?
现在的文生图基本都用扩散模型,原理说穿了很简单:
- 训练时:给清晰图片一点点加噪点,直到变成雪花乱图,让模型学习“怎么去噪”;
- 生成时:从一张随机噪点图开始,根据文字提示一步步去噪,最后生成清晰图片。
这个过程通常20-50步,所以生成一张图需要几秒钟。
主流工具怎么选
| 工具 | 特点 | 适合人群 |
|---|---|---|
| Midjourney | 美学效果天花板,风格多样,通过Discord使用 | 设计师、创意人员,追求效果 |
| DALL·E 3 | 理解能力强,文字生成准,不易崩坏 | 需要准确贴合描述、带文字设计 |
| Stable Diffusion | 开源免费,可本地部署,完全可控定制 | 专业开发者、有隐私需求 |
实用提示:高质量提示词=主体描述+风格+光影+构图+画质。比如“一只戴帽子的橘猫,宫崎骏风格,自然光,特写,8K画质”。
三、视频AI:从静态到动态的进化
视频是“时间+空间”的组合,技术难度比图片大很多,但这两年进步非常快。
1. 视频生成:文字/图片变出视频
2024年被称为“AI视频元年”,各家产品爆发式出现:
- Sora(OpenAI):画面细节和物理逻辑行业顶尖,时长最长60秒,暂未全面开放;
- 可灵(快手):中文提示词适配好,人物动作流畅,支持多段拼接,国内性价比高;
- Runway:海外创作者首选,文生图生视频、AI剪辑、特效一体化;
- Pika:二次元、插画风格表现力强,角色一致性好。
目前AI视频还在早期阶段:优点是创意快、成本低、能实现实拍很难的效果;缺点是时长有限、细节容易崩坏、物理逻辑偶尔出错。适合做概念演示、短视频素材、电商广告,不适合严肃长片和法律证据类场景。
2. 视频理解:AI也能“看”视频
除了生成视频,AI还能看懂视频:
- 视频摘要:几分钟的视频讲了什么,三句话总结;
- 内容检索:找到视频里某个动作、某句话的片段;
- 视频问答:针对视频内容提问。
技术思路也很朴素:把视频按秒抽帧,一帧一帧用视觉模型看懂,再把信息整合起来。
四、音频AI:能听会说还能写歌
音频是发展最久、最成熟的多模态领域。
1. 语音转文字(ASR):说话秒变文字
代表就是OpenAI开源的Whisper,支持99种语言,对口音不挑剔,还能自动加标点。 典型场景:会议录音转写、视频加字幕、播客整理文稿、语音日记。 进阶用法还可以生成带时间戳的转写,精确到每个词、每句话在第几秒。
2. 文字转语音(TTS):让AI读给你听
输入文字就能生成自然的人声。
- 追求最像真人:ElevenLabs,能模仿语气情感;
- 商业级稳定:Azure TTS;
- 免费好用:系统自带的Edge TTS;
- 开源可本地:Coqui。
3. 音乐生成
输入歌词和风格描述,就能生成完整的歌曲,有人声有伴奏,代表是Suno、Udio。 适合快速出Demo、生成背景音乐、尝试不同风格;但还做不到精确控制音符和专业级后期。
五、多模态是怎么做到的?简单讲原理
不用深入公式,理解两个核心概念就够了。
CLIP:图文对齐的基石
CLIP是OpenAI 2021年提出的模型,相当于给AI做了一本“图文对照字典”。 训练时同时给模型看大量“图片+文字描述”的配对,让它学会:
- 把图片转成向量
- 把文字转成向量
- 配对的图文向量尽量靠近,不配对的尽量远离
它第一次证明了跨模态理解是可行的,后来几乎所有多模态模型都受到了它的启发。
典型多模态模型结构
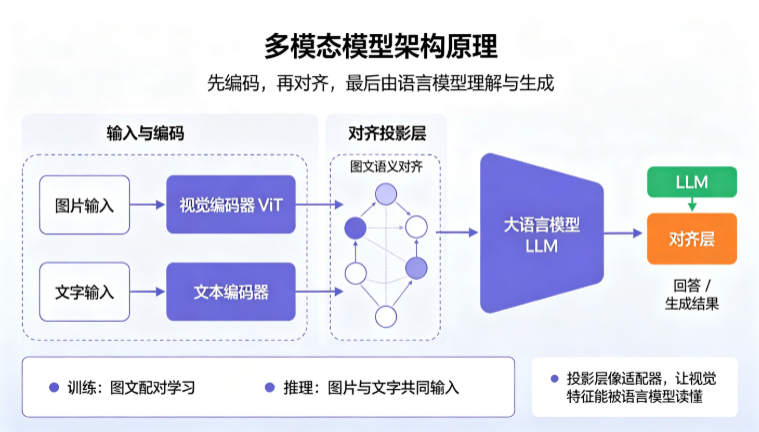
以开源的LLaVA为例,结构非常清晰,就三部分:
- 视觉编码器:比如ViT,负责“看图片”,把图片转成特征向量;
- 投影层:把图片向量“翻译”成大语言模型能懂的格式,相当于适配器;
- 大语言模型:负责理解和回答,就像纯文字AI一样。
训练分两步:第一步先让视觉和语言“对齐”,说同一种语言;第二步用图片问答数据微调,让它学会按指令回答问题。
六、实用提醒与未来趋势
用多模态的几个注意事项
- 成本更高:图像、视频、音频处理都比纯文字贵,调试建议用低分辨率、短素材;
- 版权风险:AI生成的图片、音乐、视频,版权归属目前还有灰色地带,商用前确认工具条款;
- 结果要核验:视觉识别、OCR可能出错,重要信息人工核对。
未来的方向
- 更长更清晰:视频从十几秒到几分钟,再到更长,细节越来越真实;
- 更可控:能用故事板、分镜精确控制每一个镜头;
- 更融合:多种模态无缝结合,不是“文字+图片”简单相加,而是真正融合理解。
写在最后
多模态AI最大的意义,是让AI从“键盘里的文字工具”,变成了能和真实世界交互的系统。 它能看懂你的文档、照片、视频,听懂你的语音,用更自然的方式帮你解决问题。不用纠结太复杂的技术细节,记住一点就够:多模态让AI离真实的“智能”,又近了一步。
0 条笔记