不用联网、数据不出本地:一文读懂本地AI模型部署,普通人也能上手
很多人以为AI只能在云端用:用ChatGPT数据要传到第三方服务器,没网就彻底用不了,用得多了账单还越来越贵。
其实AI完全可以在你自己的电脑上跑。文档不用上传、断网也能用、一次下载无限用、还能完全按需求定制。这就是本地模型部署的价值。
一、为什么要跑本地AI?四个不可替代的优势
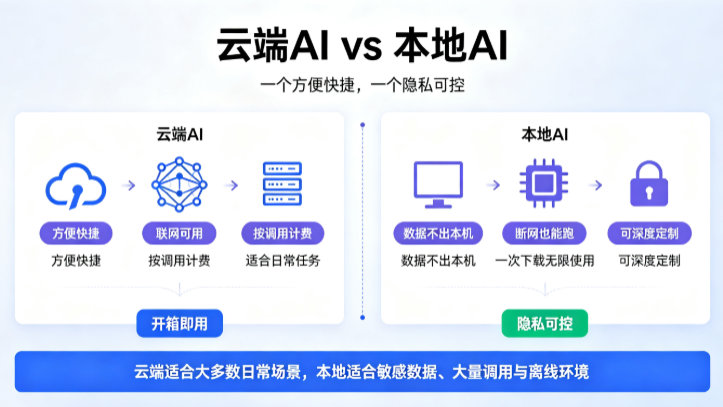
云端AI很方便,但本地AI有它不可替代的场景,两者是互补而非替代。
| 维度 | 云端AI | 本地AI |
|---|---|---|
| 数据隐私 | 数据需要上传厂商服务器 | 所有计算都在本地,数据不离开设备 |
| 网络依赖 | 必须联网才能用 | 下载一次永久可用,断网也能跑 |
| 使用成本 | 按调用量/Token计费,用量大成本高 | 一次性下载,后续无额外费用 |
| 定制能力 | 功能受限,只能用厂商提供的 | 完全可控,可微调、可定制、可二次开发 |
| 上手难度 | 开箱即用,零配置 | 需要一定配置和硬件基础 |
简单说:日常闲聊、普通任务用云端;处理敏感文档、大量调用、隐私要求高、没网的场景,用本地。
二、你的电脑能跑多大的模型?看显存就够了
本地模型能不能跑、跑得多快,核心看显卡显存。模型参数越多,需要的显存就越大。
先搞懂:CPU跑 vs GPU跑
- CPU推理:用电脑主处理器跑,什么电脑都能跑,但速度慢,大模型要等很久;
- GPU推理:用显卡跑,并行计算能力强,速度快几十倍,是主流方案。
N卡用CUDA加速,A卡用ROCm,苹果芯片用Metal,各有对应优化。
显存对应模型大小对照表
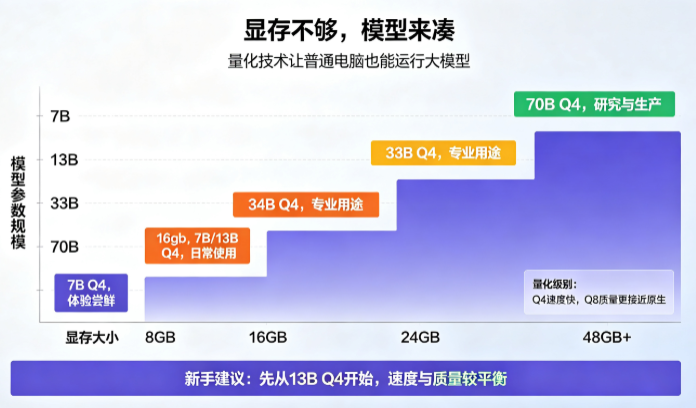
通过量化技术(后面会讲),可以用更小显存跑更大模型。普通用户参考这个表就行:
| 显存大小 | 原生精度可跑 | 量化后可跑 | 适合场景 |
|---|---|---|---|
| 8 GB | 7B模型较勉强 | 7B(Q4)、13B(Q4)勉强 | 体验尝鲜、简单对话 |
| 16 GB | 7B、13B模型 | 7B/13B(Q4/Q8)、33B(Q4) | 日常使用、性价比最高 |
| 24 GB | 7B、13B、33B | 7B/13B/33B(Q4/Q8)、70B(Q4) | 专业用途、流畅体验 |
| 48 GB+ | 33B、70B | 几乎所有主流模型 | 研究、生产环境 |
💡 苹果Mac特别说明:
Apple Silicon芯片是统一内存架构,CPU和GPU共享内存,显存不够自动借内存。16GB统一内存的MacBook,就能流畅跑7B、13B的量化模型,对Mac用户很友好。
四个配置方案推荐
| 方案 | 配置 | 适合人群 |
|---|---|---|
| 入门尝鲜 | 任意电脑8GB内存以上 | 想体验本地AI的新手 |
| 性价比之选 | 16GB内存 + 6GB以上显存 | 个人日常使用 |
| 专业方案 | 32GB内存 + 12GB以上显存 | 开发者、研究人员 |
| Mac方案 | M1/M2/M3 + 16GB统一内存 | Mac用户首选 |
不用迷信大模型,7B量化模型对于大多数日常任务已经够用了。
三、新手首选工具:Ollama,一条命令跑起来
Ollama是目前最流行的本地模型工具,一句话总结:像装软件一样装模型,像聊天一样用AI。
安装有多简单?
Windows/Mac直接去官网下载安装包,Linux一条命令就能装:
curl -fsSL [https://ollama.com/install.sh](https://ollama.com/install.sh) | sh
安装完启动服务,就可以开始用了。
常用的几个命令
不用记复杂操作,核心就几个命令:
ollama pull 模型名:下载模型,比如ollama pull qwen就是下载通义千问;ollama run 模型名:运行模型,直接开始对话;ollama list:看已经下载了哪些模型;ollama rm 模型名:删除不用的模型。
比如想跑中文好的模型,直接ollama run qwen,没有的话会自动下载,下载完就进入对话界面,跟用ChatGPT一样。
不止能聊天:还能当API用
Ollama自带HTTP接口,默认在[http://localhost:11434](http://localhost:11434),可以用代码调用,集成到自己的程序里。
更方便的是:很多工具都兼容Ollama接口,原来调用云端AI的代码,改个地址就能用本地模型。
想要图形界面?配个Open WebUI
觉得命令行太糙?搭配Open WebUI,就能得到一个和ChatGPT几乎一样的网页界面,支持对话、多模型切换、插件等等。
Ollama + Open WebUI,是目前最推荐的新手组合:安装简单、界面友好、功能全。
不想敲命令?试试LM Studio
如果你完全不想碰命令行,LM Studio是纯图形界面工具:
- 内置模型库,搜索点一下就下载;
- 自动提供不同量化版本,选就行;
- 也能开启本地API服务,还兼容OpenAI格式。
新手建议:先用LM Studio上手熟悉概念,熟了再用Ollama做自动化和集成。
四、什么是量化?让小电脑也能跑大模型
量化是让普通电脑跑起大模型的关键技术。通俗说就是“在损失很少质量的前提下,把模型压缩变小”。
大白话理解量化
原生模型每个参数用16位甚至32位小数存储,就像无损音乐,体积大、音质好。
量化就是把它压缩成8位、4位整数,就像高质量MP3,体积小很多,人耳几乎听不出区别。
精度降低了,但体积和显存需求大幅下降,大多数场景体验差别不大。
常见量化级别怎么选?
最常用的是Q4和Q8:
- Q4(4位量化):体积最小、速度最快,质量有轻微下降,日常对话、简单任务完全够用;
- Q8(8位量化):质量接近原生,体积大一圈,追求质量选这个。
还有Q5、Q6中间档位,平衡速度和质量。
新手建议直接选Q4_K_M版本,是经过大量验证的最佳平衡点。
主流格式:GGUF
现在最流行的量化模型格式是GGUF,跨平台、支持多种量化级别、推理速度快,Ollama、LM Studio这些主流工具都支持。
不用纠结太多格式区别,工具默认用什么就用什么。
五、模型怎么选?适合的才是最好的
开源模型成百上千,不用追最新最大的,适合自己硬件和任务的才最好。
参数越大越好吗?
模型参数量可以理解成“脑细胞数量”,越大能力越强,但也越慢、越吃显存。
| 规格 | Q4显存需求 | 速度 | 能力 | 适合场景 |
|---|---|---|---|---|
| 7B | 4-6GB | 很快 | 够用 | 日常对话、简单任务 |
| 13B | 7-10GB | 快 | 良好 | 写作、编程、分析 |
| 33B | 15-20GB | 中等 | 优秀 | 复杂推理、专业领域 |
| 70B | 30-40GB | 较慢 | 接近GPT-3.5 | 研究、生产环境 |
大多数人的最佳平衡点是13B Q4版本:能力不错,速度也能接受。
中文好的模型推荐
很多国外模型中文一般,优先选这些:
- Qwen(通义千问):阿里出品,中文能力强,综合均衡,首选;
- Yi(零一万物):中文理解好,推理能力强;
- DeepSeek:深度求索,代码能力强,中文也不错;
- Llama 3:Meta出品,综合强,但中文需要调教。
按任务选模型
- 日常聊天:Llama 3、Qwen、Mistral;
- 写作文案:Yi、Llama 3;
- 写代码:DeepSeek-Coder、CodeLlama;
- 数学推理:Llama 3、Qwen。
六、实战:搭一个完全离线的本地知识库
本地模型最实用的玩法之一,就是做完全离线的私有知识库:把自己的文档、笔记、手册喂给模型,让它基于这些内容回答问题,全程数据不离开电脑。
原理很简单:RAG检索增强
思路就是:
- 把你的文档切成小块;
- 都转成向量存在本地向量数据库;
- 提问时,先从库里找出最相关的文档片段;
- 把片段和问题一起送给本地模型;
- 模型基于文档内容回答。
用Ollama + LangChain + Chroma就能实现,全程不用联网,文档、向量库、模型都在你硬盘上,完全不用担心泄露。
能用来做什么?
- 把公司产品手册导进去,做内部客服助手;
- 把自己的笔记、书导进去,做个人知识助理;
- 把合同、财报导进去,做本地文档分析。
七、怎么跑得更快?几个实用优化技巧
本地模型跑起来了,还想更快,试试这几个方法:
- 选合适的量化级别:Q4能用就不用Q8,速度提升明显;
- 减小上下文窗口:不用很长上下文的话,把窗口调小,速度会快不少;
- 确保用GPU加速:检查有没有启用CUDA/Metal,别让CPU在跑;
- 限制生成长度:设置最大输出Token,不用生成多余内容;
- 关闭流式输出:API调用不需要逐字显示的话,关了流式能减少开销。
性能优化是平衡的艺术:速度、质量、显存三者不可兼得,根据自己需求选平衡点就行。
写在最后
本地AI不是要替代云端AI,而是多一个选择。
云端方便快捷,适合日常大多数场景;本地安全可控,适合敏感数据、大量调用、离线环境。
不用一开始就追求大模型、完美配置,从一个7B模型、Ollama开始,先跑起来,再慢慢迭代,你会发现:属于你自己的AI,其实没那么远。
0 条笔记