大模型微调通俗讲解:不是重新造模型,是给通用AI做“专项集训”
很多人接触大模型之后会有一个疑问:通用大模型能力很强,但不懂我的业务话术、内部术语、特定输出格式。
除了用RAG检索增强把资料塞给模型,还有另外一条路——微调(Fine‑Tuning)。
很多人把微调理解成“重新训练大模型”,其实二者差别巨大。预训练是从零开始,喂海量互联网数据,学习通用语言、常识;微调是拿一个已经训练好的成熟大模型,用少量业务数据再做一轮专项训练,教会它适配你的场景。
简单打个比方:
预训练:就像普通人读完十几年学校,掌握通用的读写思考能力。
微调:就像上岗岗前专项培训,不用重新从小学课本学起,只用学习岗位的专业话术、工作规范。
一、微调 vs RAG,该选哪一个?
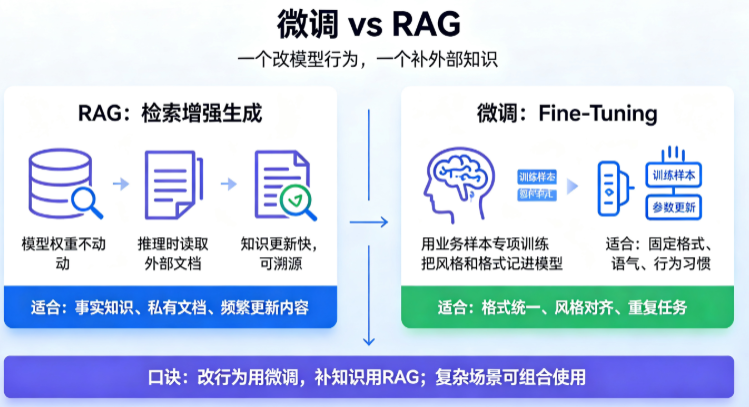
RAG和微调,是把业务知识注入大模型的两大主流手段,很多人会混淆。两者没有绝对的好坏,适用场景完全不同。
| 对比项 | 微调 Fine‑Tuning | RAG检索增强生成 |
|---|---|---|
| 工作原理 | 修改模型内部参数,把能力“记进模型权重” | 不改动模型,推理时实时把参考文档作为上下文喂给模型 |
| 数据需求 | 需要高质量的问答/指令样本,几十到上万条 | 原始文档即可,不需要整理成对的样本 |
| 知识更新 | 更新知识要重新微调,成本高 | 直接增删文档,近乎实时生效 |
| 溯源引用 | 很难输出资料来源,黑盒 | 可以返回引用的文档片段,方便核查 |
| 擅长解决 | 输出格式、语气、风格、固定指令、特定行为习惯 | 事实类知识、私有文档、需要溯源、经常变动的信息 |
| 成本 | 需要GPU算力,有训练成本 | 主要消耗向量库、推理token成本 |
快速判断口诀:
- 想要改行为、改风格、固定输出格式,优先考虑微调;
- 想要灌输大量事实、私有文档,需要溯源、经常更新内容,优先选RAG;
- 复杂业务:RAG + 微调组合使用,微调调教模型说话风格,RAG负责提供事实资料。
二、常见的几类微调方式
微调也分很多种,并不是只有全参数微调一种。不同方案消耗的算力不一样,效果也不一样。
1. 全参数微调(Full Fine‑Tuning)
把模型全部的参数拿出来重新更新。
- 优点:理论上效果上限最高;
- 缺点:显存、算力消耗巨大;大模型要多张高端显卡;容易发生“灾难性遗忘”——把预训练学到的通用知识给学丢了。
- 适用:拥有充足算力、大量高质量样本,一般企业很少直接用在7B以上大模型。
2. LoRA 低秩自适应微调(现在工业界主流)
LoRA 是目前开源项目最常用的微调方案。冻结原始大模型全部权重,只训练额外插入的很小的低秩矩阵。训练完之后,把小矩阵合并回原模型就可以使用。
优势非常突出:
- 显存需求大幅下降,普通消费级显卡就可以微调7B、13B模型;
- 原始模型权重不会被改动,不容易出现灾难性遗忘;
- 训练产出的LoRA权重文件体积很小,方便保存、分发;
- 可以切换不同LoRA适配器,一个基础模型切换多个业务“专项技能包”。
通俗理解:不修改原版课本,只写薄薄一本补充讲义,训练只改这本讲义,使用时讲义和课本一起读。
衍生还有QLoRA,在LoRA基础上加入模型量化,进一步降低硬件门槛,普通消费显卡就能微调大参数量模型。
3. 指令微调(Instruction Tuning)
指令微调的目标不是教模型新知识,而是教会模型听懂人类指令。
数据集格式一般是:用户指令 + 期望模型输出。
大量“指令‑回答”成对数据训练之后,模型会学会遵循人类的提示,听从指令完成任务。现在市面上的对话大模型,几乎都经过指令微调。
4. DPO 直接偏好优化(对齐人类喜好)
前面几种都是输入正确样本来训练;DPO不需要正负样本对比排序,直接利用人类偏好数据,让模型学会产出人类更喜欢的回答,用来做RLHF人类对齐,替代传统强化学习。
三、微调对数据集有严格要求
微调能不能成功,80%取决于数据集质量,而不是模型大小和算力。很多人微调失败,问题都出在数据。
指令微调标准数据格式
一条样本一般由三部分组成:
{
  "instruction": "用户的问题或者指令",
  "input": "可选,额外输入上下文",
  "output": "模型应该输出的标准答案"
}
数据集常见坑
- 数据脏、噪声多:样本里面有错别字、逻辑错误、错误答案。模型会把错误内容学进去;
- 样本数量不足:简单任务几百条高质量样本就够用;复杂业务,往往需要几千条;几十条脏数据很难调出来效果;
- 格式不统一:输出一会列表、一会大段段落,模型学不到稳定输出格式;
- 分布不匹配:训练数据都是简单问题,实际业务都是复杂问题,上线效果落差巨大。
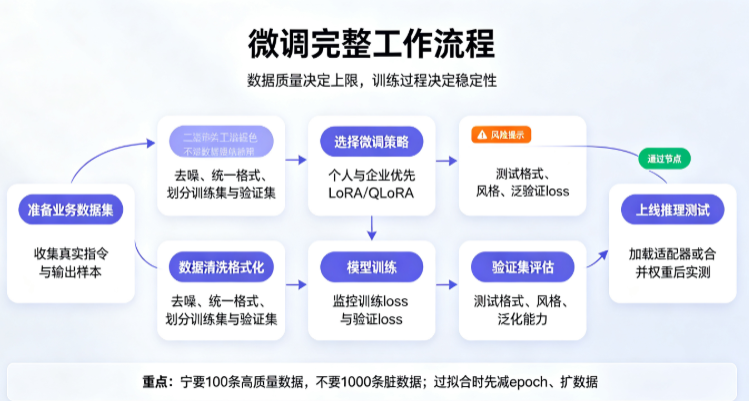
重点提醒:宁要100条高质量干净数据,不要1000条粗制滥造的脏数据。
数据集处理小技巧
- 尽量贴近真实业务用户提问,不要编造脱离实际的虚拟问题;
- 输出格式严格统一,想要模型输出表格,训练样本就要大量表格样例;
- 划分训练集、验证集,训练过程看验证集损失,防止过拟合;
- 过拟合:模型死记训练集样本,遇到没见过的新问题效果急剧变差。
四、微调完整实操流程
第一步:明确目标,判断要不要做微调
先自问三个问题:
- 我想解决的是输出格式、语气、行为习惯,还是大量事实知识?
- 我能不能产出一批高质量成对训练样本?
- RAG能不能搞定这件事?
如果RAG就可以满足,优先选RAG,成本更低迭代更快。
第二步:准备、清洗数据集
收集真实业务对话,人工整理成指令‑输出对,剔除错误、噪声。划分训练集、验证集。
第三步:选择微调方案与硬件
- 个人/中小企业优先:QLoRA / LoRA;
- 硬件:7B模型QLoRA,一张16G显存显卡就可以完成训练;13B建议24G显存。
第四步:开始训练,监控训练指标
训练的时候重点看验证集loss损失值:
- 训练loss持续下降,验证loss也同步下降:正常;
- 训练loss持续下降,验证loss开始走高:出现过拟合,需要停止训练,扩充数据,降低训练轮数epoch。
epoch:数据集完整过一遍叫一个epoch,不是epoch越大越好,训多了极易过拟合。
第五步:效果评估
不要只看训练集表现!拿一批从来没见过的测试问题测试模型。
评估维度:输出格式是否正确、语气风格是否达标、会不会遗忘通用能力、回答是否准确。
第六步:上线部署
LoRA两种上线方式:
- 推理时加载基础模型 + LoRA适配器;
- 将LoRA权重合并到基础模型,直接部署完整模型文件。
五、常见误区,很多人都踩坑
- 误区:微调可以疯狂灌大量新知识
❌ 微调不是无限记忆数据库。大量事实知识交给RAG;微调更擅长学习风格、格式、行为。强行塞海量事实,容易出现混淆和遗忘。 - 误区:数据越多效果一定越好
❌ 质量优先于数量。一堆错误样本,越多效果越差。 - 误区:epoch轮次越多模型越厉害
❌ 训练太久会发生过拟合,死记训练数据,泛化能力变差。 - 误区:微调之后就不需要提示词工程
❌ 微调是增强模型,不是替代提示词。合理的系统提示词依然可以进一步优化效果。 - 误区:微调可以彻底消除幻觉
❌ 微调不能根治幻觉,只能一定程度改善;事实校验、RAG溯源依旧必不可少。
六、什么场景适合做微调,什么不适合
✅ 适合微调
- 需要固定输出模板:每次输出固定表格、固定markdown格式;
- 特定语气风格:企业客服口吻、论文写作、小说人物对话;
- 学会一套固定指令范式,大量重复同类任务;
- 对齐内部业务术语,学会特定的回答习惯。
❌ 不建议优先微调
- 需要频繁更新的事实资料、产品参数;
- 海量私有文档知识库;
- 需要输出引用来源、溯源证据。
写在最后
微调不是万能银弹。
很多业务场景,先用提示词工程,不行就上RAG;当提示词+RAG已经到达瓶颈,再考虑微调。
LoRA、QLoRA大幅降低了微调门槛,但数据集质量才是决定微调成败的关键。不要迷信算力和大模型,高质量样本才是核心。
现实工程中,RAG负责事实知识,微调负责调教模型行为风格,两者互相配合,往往能拿到最好的业务效果。
0 条笔记