RAG的幕后引擎:通俗读懂向量数据库
大模型存在知识截止、幻觉、无法读取私有文档的问题,RAG检索增强生成就是用来解决这些痛点的主流方案。而向量数据库,正是RAG体系里负责语义检索的核心引擎。
很多人会混淆:Embedding嵌入模型负责把文字、图片转成一串数字向量;向量数据库不生成向量,专门用来存储、索引、高速检索海量向量数据。
生活化比喻:
Embedding模型是翻译官,把人类语言翻译成机器看得懂的“语义坐标”;
向量数据库是一座智能图书馆,保存每一份资料的坐标,当你提问,它快速找出语义最接近的资料片段。
一、传统数据库搞不定的难题:关键词匹配不等于理解语义
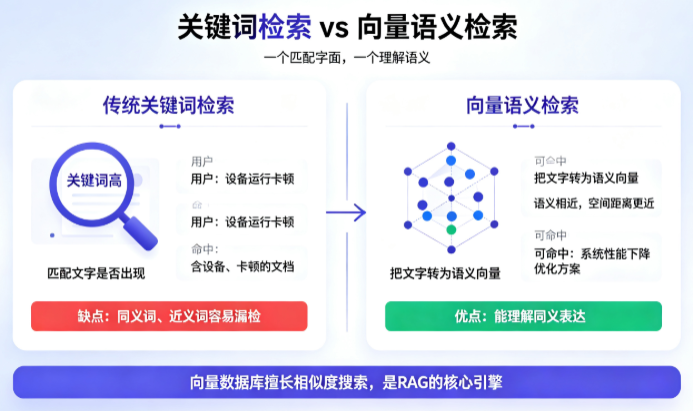
MySQL这类传统数据库擅长精确匹配,判断“字面是否一样”,但看不懂文字背后的含义。
举个例子:
用户提问:“设备运行卡顿该怎么处理?”
- 传统关键词搜索:只会优先返回包含“设备”“卡顿”字眼的文档;如果文档写的是“系统性能下降优化方案”,没有出现卡顿,就搜不到这份高度相关的资料。
- 向量检索:理解两个句子语义等价,哪怕字面用词完全不一样,也可以匹配出来。
| 对比维度 | 传统数据库(MySQL) | 向量数据库 |
|---|---|---|
| 查询逻辑 | 精确匹配、关键词匹配,回答“是什么” | 相似度检索,回答“像什么” |
| 处理对象 | 结构化表格数据(数字、日期) | 文本、图片、音频等非结构化数据的向量指纹 |
| 索引 | B‑树、哈希索引 | HNSW、IVF‑PQ等ANN近似最近邻索引 |
| 核心能力 | 事务、增删改查、统计 | 高维空间快速相似度计算 |
| 典型应用 | 订单、用户信息管理 | AI知识库、以图搜图、个性化推荐 |
二、向量、Embedding到底是什么?
向量(Embedding嵌入):通过专门嵌入模型,把一段文字、一张图片转换成一组几百到几千位的浮点数数组,相当于这份内容独一无二的“语义指纹”。
核心规律:语义越相近,在高维向量空间中的距离就越近。
- “小猫在草地上玩耍”和“猫咪在草坪嬉戏”,向量距离很近;
- “小猫在草地上玩耍”和“汽车高速行驶”,向量距离很远。
文本场景最常用余弦相似度来衡量向量之间的接近程度,数值越接近1,代表语义越相似。
注意:向量本身人类读不懂,它只是给计算机做计算用;向量数据库存储时,会同时保存三件东西:
- 高维向量(用于计算相似度)
- 原始文本/图片片段(检索后拿给大模型使用)
- 元数据:分类、时间、权限标签,用于过滤筛选。
三、向量数据库如何工作?两大流程:入库链路、查询链路
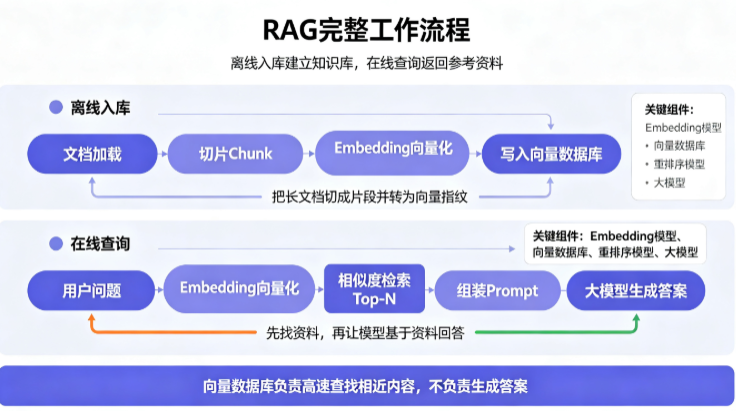
完整的RAG知识库分为离线入库,和用户在线查询两大链路,向量数据库在中间承担存储检索工作。
链路1:文档入库(离线处理)
- 文档加载与切片Chunk:读取PDF、Markdown、Word文档,把长篇文档切分成合适大小片段。块太大细节丢失;块太小上下文断裂,直接影响检索质量。
- Embedding向量化:调用嵌入模型,把每一个文档片段转换为向量。
- 写入向量库:将向量、原文、元数据存入向量数据库,系统建立向量索引,加速后续搜索。
链路2:用户提问在线查询
- 用户输入问题;
- 用户问题交给Embedding模型,转换成查询向量;
- 将查询向量送入向量数据库,执行相似度检索,返回Top‑N语义最接近的文档片段;
- 将检索出来的原文片段拼接进提示词,交给大模型;
- 大模型参考检索到的资料,生成回答返回用户。
ANN近似最近邻索引:速度的秘密
如果没有索引,搜索需要拿查询向量和库里面每一条向量全部对比,数据量大时速度极其缓慢。
向量数据库使用ANN近似最近邻算法,代表如HNSW,牺牲极其微小的检索精度,换取上万倍速度提升,百万级别向量可以做到毫秒返回结果。
HNSW类似地图分层导航:高层粗定位,逐层往下细化,快速定位到相似向量。
小提示:ANN是近似查找,不是100%一定召回全部结果,工程上可以调整参数平衡速度和召回率。
四、向量数据库不只有做RAG,还有这些场景
- 多模态检索:以图搜图,用文字描述搜索图片;音频检索,跨模态匹配内容,电商商品搜索大量使用。
- 个性化推荐系统:把用户喜好、商品特征转为向量,寻找相似用户、相似物品做推荐。
- 异常检测:把正常业务行为向量化,偏离正常向量空间太远的,判定为异常行为,用于风控。
- 混合检索:向量语义检索 + BM25关键词检索两者结合,兼顾字面匹配与语义理解,生产环境RAG普遍使用混合搜索提升召回质量。
五、主流向量数据库怎么选型
不同工具面向的规模、运维成本差异很大,新手不要盲目上重型分布式系统。
| 产品 | 类型 | 特点 | 适用场景 |
|---|---|---|---|
| Chroma | 开源库 | 轻量,上手简单,python友好 | 原型、本地测试、小规模Demo |
| FAISS | 算法库 | Facebook开源,性能强,只提供算法,无完整服务 | 实验、内存内运算,不直接做线上服务 |
| Qdrant | 开源数据库 | Rust开发,单机性能高,元数据过滤强 | 单机中小规模生产环境 |
| Milvus | 分布式开源 | 支持十亿、千亿级向量,功能完备 | 企业级大规模私有化部署 |
| Pinecone | SaaS托管服务 | 零运维,开箱即用,云服务 | 不想维护服务器,快速上线项目 |
| pgvector | PostgreSQL扩展 | 复用已有PostgreSQL环境,学习成本低 | 百万向量以内,已有PG技术栈项目 |
选型简单建议:
- 学习、做Demo原型 → Chroma;
- 已有PostgreSQL环境,数据量不大 → pgvector;
- 单机生产,追求高性能 → Qdrant;
- 企业大规模私有化部署 → Milvus;
- 不想运维服务器,快速上线 → Pinecone。
六、工程落地常见坑
- 向量数据库不是万能,检索效果上限取决于Embedding模型
向量库只负责查找,嵌入模型质量差,再强的向量库也搜不到正确内容。中文场景优先选择针对中文优化的嵌入模型。 - 切片策略直接决定RAG好坏
文档切分不能粗暴按固定字数切割,尽量按照语义段落切分,避免把完整语义拆碎。 - 不能只靠向量检索,建议混合检索
单纯向量有时候会忽略字面关键词,搭配关键词BM25混合检索,结果更稳定。 - ANN是近似检索,会漏召回
重要业务场景,不能完全依赖向量检索结果,需要搭配重排序Rerank模型,对初筛结果二次打分过滤。 - 向量库解决的是“找资料”,消除不了幻觉
就算检索到文档,大模型依然有可能歪曲资料内容;关键业务需要开启引用溯源,人工复核重要输出。
写在最后
向量数据库不是什么神秘黑科技,本质就是专门为高维向量相似度搜索而优化的数据库。
它解决了传统数据库看不懂语义的痛点,是RAG私有知识库的基石。但要记住:向量数据库只是整个系统其中一环,嵌入模型、文档切片、检索策略、重排序,每一步都会影响最终AI回答质量,不能指望只换一个向量数据库就解决全部业务问题。
对于普通开发者,优先跑通原型,验证检索效果,再根据数据规模选择对应的向量数据库,不要一开始就过度设计复杂架构。
0 条笔记