看懂深度学习:从基础原理到完整训练流程
深度学习是大模型、AI绘画、人脸识别背后的底层技术。很多人觉得它是高深的黑盒,本质上它就是一个强大的函数拟合工具:喂给它大量输入与对应的正确答案,它自动挖掘数据里面隐藏的模式与规律。
传统机器学习需要人工手动设计特征;深度学习可以自动从原始数据学习特征,数据越多,效果提升越明显,这也是它能够爆发的根本原因。
生活化比喻:
传统机器学习:老师出题,你把解题步骤(特征)写好交给计算机;
深度学习:给计算机大量的习题和标准答案,让它自己琢磨出解题套路。
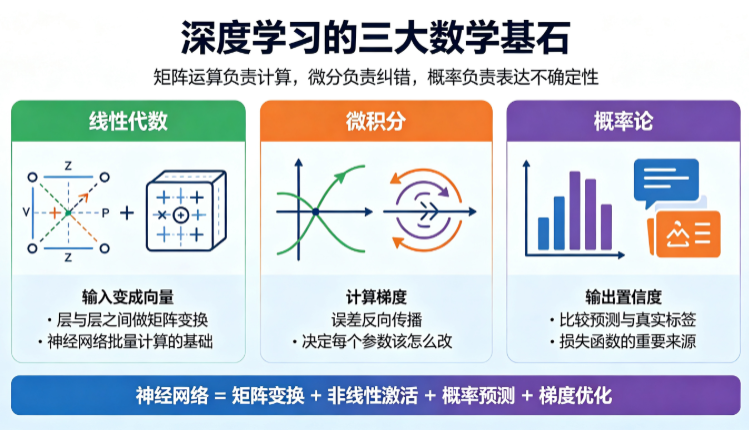
一、深度学习的三大数学基石
不需要精通高数,但要理解三类核心数学思想,整个神经网络都是建立在这三者之上。
- 线性代数(矩阵、向量、矩阵乘法)
把图片、文字全部变成数字向量,矩阵乘法完成神经元的批量计算。神经网络每一层变换,本质就是矩阵运算。 - 微积分(导数、梯度、链式法则)
用来算“错在哪里,该往哪个方向修改参数”。链式法则是反向传播的核心,误差可以一层一层往网络前面回传。 - 概率论
模型输出概率分布,比如图片识别输出“猫80%、狗15%、鸟5%”;损失函数很多也是基于概率设计。
二、神经网络的基本运行逻辑:前向传播
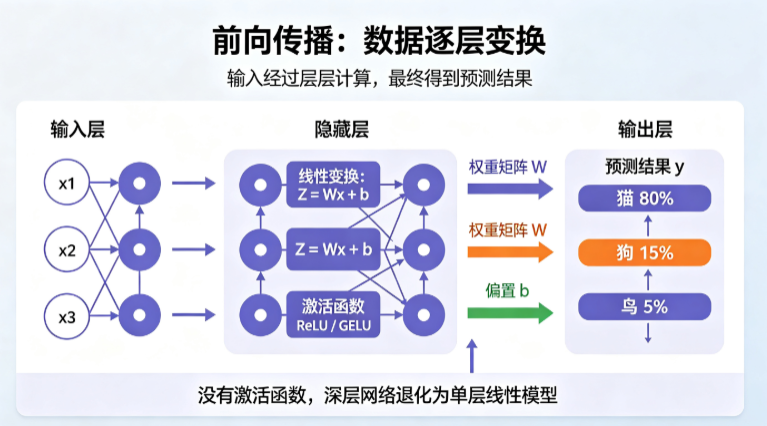
神经网络由一层一层神经元堆叠而成:输入层 → 若干隐藏层 → 输出层。
前向传播就是数据从输入层一路流过每一层,最后得到预测结果的过程。
每一层的通用计算逻辑:输出 = 激活函数(权重矩阵 × 上一层输出 + 偏置)
⚠️重点:如果没有激活函数,无论堆多少层网络,都等价于单层网络。
激活函数的作用就是引入非线性,让网络可以学习现实世界里复杂的规律。
主流激活函数对比
| 激活函数 | 特点 | 适用场景 |
|---|---|---|
| ReLU | 计算简单,正区间不会梯度消失 | CNN、普通隐藏层,最常用 |
| GELU | 曲线平滑 | GPT、BERT、Transformer大模型 |
| Sigmoid | 输出压缩0‑1 | 二分类输出层,现在少用于隐藏层 |
| Leaky ReLU | 解决神经元“死亡ReLU”问题 | ReLU失效的时候备选 |
三、衡量对错:损失函数
前向传播得到预测结果之后,需要一把“尺子”衡量预测和真实答案差距多大,这就是损失函数(Loss Function)。损失数值越大,代表模型错得越离谱。
不同任务选用不同损失:
- 分类任务(识别猫/狗):交叉熵损失 Cross‑Entropy
用来对比模型输出概率分布和真实标签。大语言模型预测下一个词,本质也是多分类,同样用交叉熵。 - 回归任务(预测房价、温度):MSE均方误差
计算预测数字和真实数字的平方差,对大的错误惩罚更重。
训练的目标:不断更新模型参数,把损失值降到尽可能小。
四、反向传播 + 梯度下降:模型自我学习
光知道损失多大还不够,模型需要知道每个权重参数应该调大还是调小。分为两步:
- 反向传播 Backpropagation
利用链式法则,从输出层开始,把误差一层一层反向传回前面每一层,算出每一个参数的梯度。梯度代表:这个参数改动一点点,损失会变化多少。 - 优化器(梯度下降)
拿到梯度,优化器按照学习率去更新全部权重参数。
常见优化器
- SGD随机梯度下降:基础版本,简单,调参工作量大。
- Momentum动量:加入惯性,减少震荡,收敛更快。
- Adam:自适应学习率,绝大多数深度学习任务的默认选择。
- AdamW:增加权重衰减,Transformer大模型首选。
学习率是最重要超参数:学习率太大训练震荡不收敛;太小训练极其缓慢。大模型经常会用预热Warmup:训练前期学习率从小到大慢慢抬升。
五、可怕的过拟合:模型背答案,不会举一反三
什么是过拟合?模型把训练集样本几乎全部记住,在训练数据上表现极好;但是遇到从来没见过的新数据,效果一塌糊涂。就像学生死记硬背习题答案,但换一道新题目就不会做。
解决过拟合的几类正则化手段:
- 数据增强:对原始样本做变换,制造更多训练数据。图像做翻转裁剪;文本做改写替换。是效果最好的手段。
- Dropout:训练时随机临时关闭一部分神经元,不让模型过度依赖少数几个神经元。
- 权重正则 L1/L2:对过大的权重施加惩罚,鼓励权重保持较小数值。
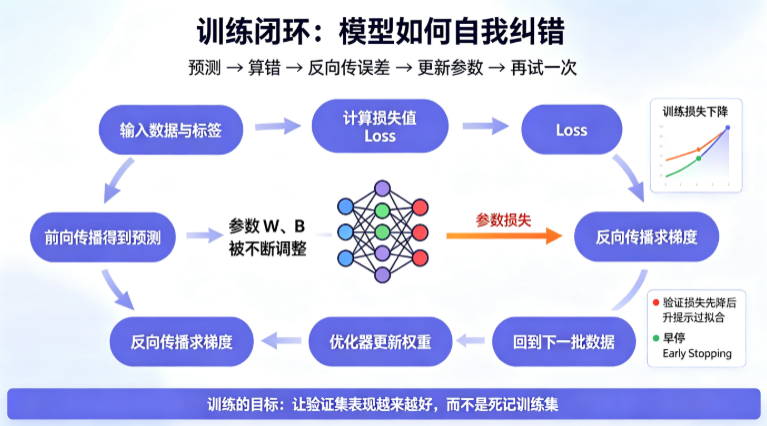
- 早停 Early Stopping:监控验证集效果,验证集不再提升,立刻停止训练,防止继续学死记训练集。
六、归一化:让训练更加稳定
深度网络层数很深,每一层输出的分布会不断发生偏移,导致训练困难。归一化就是把数据调整到合适分布。
| 归一化 | 使用场景 | 特点 |
|---|---|---|
| BatchNorm批归一化 | CNN图像模型 | 按批次做归一化,小batch效果差 |
| LayerNorm层归一化 | Transformer、大语言模型GPT、LLaMA | 在样本内部做归一化,不受batch大小影响,序列模型标配 |
现在所有大语言模型,全部使用LayerNorm,几乎不再用BatchNorm。
七、完整深度学习训练标准流程
不管是图像识别还是大模型微调,完整训练流程都是这套范式:
- 数据集准备:划分训练集、验证集、测试集。训练集用来学知识,验证集调超参数,测试集模拟真实线上效果。
- 搭建网络模型:堆叠网络层,设置激活函数、归一化、dropout。
- 选择损失函数 + 优化器,配置学习率调度。
- 迭代训练循环
- 一批数据送入网络做前向传播,得到预测
- 计算损失
- 反向传播求梯度
- 优化器更新权重
- 验证评估:每轮结束在验证集跑一遍,观察损失、准确率,监控是否出现过拟合。
- 训练结束保存模型权重,做推理预测。
关键点:不要拿训练集效果来评判真实能力!一定要看验证集、测试集指标。
八、训练 vs 推理,分清两个阶段
很多初学者混淆这两个概念:
✅ 训练(Training):拿着大量标注数据,反复迭代更新权重,消耗巨大算力;只做一次或者少数几次。
✅ 推理(Inference):训练完成之后,权重固定不变。输入新数据,只跑前向传播得到结果。我们日常调用AI对话、识别图片,全部都是推理阶段。
推理不需要反向传播,不需要算梯度,算力消耗远低于训练。
写在最后
深度学习没有那么神秘。它的核心循环就是:前向算结果,损失算差距,反向传误差,优化器改参数,一遍遍循环迭代。
Transformer、CNN卷积神经网络这些复杂架构,也只是这套基础训练框架之上,设计出来的特殊网络结构。理解这套基础,再去看大模型、微调、RLHF,很多概念就会豁然开朗。
很多人一上来就堆复杂模型,忽略数据集、过拟合、学习率、归一化这些基础,最后训练效果差,找不到问题根源。数据质量、基础训练参数,往往比网络结构更重要。
0 条笔记