特征工程是机器学习项目里,位于数据清洗之后、模型训练之前的关键步骤。简单来说,特征工程就是从干净的数据里,提取、构造、转换出更适合模型学习的特征,用来提升模型的预测效果。
有一句话在机器学习领域很常用:数据和特征决定了机器学习的上限,模型和算法只是不断逼近这个上限。 足以看出特征工程的重要性。
什么是特征
特征(Feature)就是用来做预测的输入信息。
以我们统一的数据集为例:
- Age(年龄)、Salary(薪资)是特征
- Purchased(是否购买)是标签(Label),也就是我们想要预测的目标
模型本身不会理解“年龄、薪资”的业务含义,它只认识数字。特征工程的目的,就是把原始信息转换成模型更容易理解、更有区分度的数字表达。
特征工程常见操作
1. 特征选择
从现有的特征中,筛选出有用的特征,剔除无用、冗余特征。
- 剔除方差接近0的特征:所有样本的值几乎一样,没有区分能力
- 剔除高度相关的特征:两个特征信息重复,保留其一即可,减少冗余
- 剔除和标签几乎无关的特征:对预测目标没有帮助,还会引入噪声
注意:不要盲目删特征,需要结合相关性分析、业务经验一起判断。
2. 特征构造(衍生特征)
基于原有特征,计算出新特征,挖掘隐藏信息。
示例:已知起始时间、结束时间,可以构造时长;已知单价、数量,可以构造总金额。
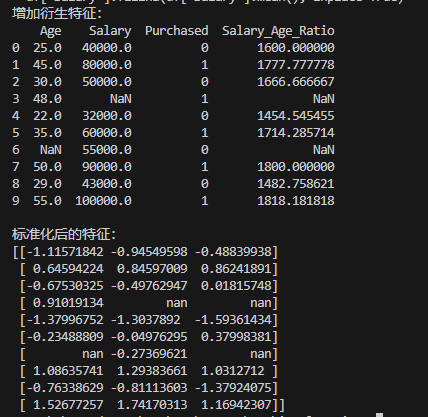
在我们这份数据集里,可以构造:薪资年龄比 Salary / Age。
3. 特征转换
(1)标准化(Standardization)
把数值缩放为均值0,标准差1。
适合:SVM、逻辑回归、神经网络这类对特征尺度敏感的算法。
(2)归一化(Normalization / Min-Max)
把数值压缩到 [0,1] 区间。
适合:距离类算法,KNN。
标准化、归一化只作用于特征,标签一般不需要缩放。
(3)类别编码
如果是文本分类特征(如城市、性别),模型无法直接读取字符串,需要编码:
- 独热编码 OneHot:类别不多时使用,生成0-1向量
- 标签编码 LabelEncoder:类别存在顺序关系时使用(如等级:低/中/高)
4. 特征降维
当特征数量非常多(几十上百维),可以使用 PCA 等方式,把高维特征压缩成少数几个主成分,减少计算量,缓解维度灾难。代价是损失一部分信息。
配套代码示例(沿用统一 data.csv)
数据集和《数据理解》《数据清洗》共用:
Age,Salary,Purchased
25,40000,0
45,80000,1
30,50000,0
48,,1
22,32000,0
35,60000,1
,55000,0
50,90000,1
29,43000,0
55,100000,1
import pandas as pd
from sklearn.preprocessing import StandardScaler

# 读取数据
df = pd.read_csv("data.csv")

# 先做简单清洗(填充缺失值)
df['Age'].fillna(df['Age'].mean(), inplace=True)
df['Salary'].fillna(df['Salary'].mean(), inplace=True)

# 1. 构造新特征:薪资年龄比
df['Salary_Age_Ratio'] = df['Salary'] / df['Age']
print("增加衍生特征:")
print(df)

# 2. 提取特征列
X = df[['Age','Salary','Salary_Age_Ratio']]

# 3. 标准化
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

print("\n标准化后的特征:")
print(X_scaled)
运行结果:
特征工程常见误区
- 数据泄露:使用测试集信息做标准化、特征构造。正确做法:只用训练集拟合转换器,再转换测试集。
- 过度构造特征:生成大量无关衍生特征,带来过拟合。
- 忽略业务逻辑:只看统计指标,构造出业务上毫无意义的特征。
- 盲目降维:PCA 会丢失可解释性,小数据集一般不需要降维。
小结
特征工程是一个反复迭代的过程,没有固定模板。我们不断尝试构造、筛选、转换特征,再送入模型,根据模型效果反向调整特征方案。高质量的特征,往往比调参带来更大的收益。
思考题
- KNN 算法为什么通常需要对特征做归一化?
- 一个有序分类特征(小学/中学/大学)适合用独热编码还是标签编码?
0 条笔记