数据理解是机器学习项目生命周期里紧跟在数据收集之后的环节。这个阶段的核心目标是熟悉数据集、了解字段含义、查看数据分布、初步发现数据里存在的问题,为后续的数据清洗、特征工程做好准备。很多模型效果不佳,根源就是前期没有充分理解数据。
数据理解主要工作内容
- 查看数据集基本信息:样本数量、字段数量、字段类型(数值、分类等)
- 统计描述:均值、最大值、最小值、标准差、分位数
- 检查缺失值:初步定位哪些字段存在空缺
- 查看分布:数值分布、分类标签占比
- 简单相关性分析:特征和标签之间是否存在关联
数据理解是探查,不是修改数据,这个阶段尽量不改动原始数据集。
配套 data.csv(本篇专用,UTF-8保存,可直接用于下面代码)
文件名:data.csv
Age,Salary,Purchased
25,40000,0
45,80000,1
30,50000,0
48,,1
22,32000,0
35,60000,1
,55000,0
50,90000,1
29,43000,0
55,100000,1
字段说明:
- Age:年龄,数值特征
- Salary:薪资,数值特征
- Purchased:是否购买,标签,0=不购买,1=购买
Python 代码示例(数据理解)
import pandas as pd
import matplotlib.pyplot as plt

# 读取数据集
df = pd.read_csv("data.csv")

# 1. 查看前5行
print("===== 数据预览 =====")
print(df.head())

# 2. 查看数据集形状:行数、列数
print("\n===== 数据集形状 =====")
print(df.shape)

# 3. 查看字段类型、缺失信息
print("\n===== 数据基本信息 =====")
print(df.info())

# 4. 数值字段统计描述
print("\n===== 统计描述 =====")
print(df.describe())

# 5. 统计每一列缺失值数量
print("\n===== 缺失值统计 =====")
print(df.isnull().sum())

# 6. 查看标签分布
print("\n===== 标签 Purchased 分布 =====")
print(df["Purchased"].value_counts())

# 7. 绘制年龄分布直方图
plt.rcParams["font.sans-serif"] = ["SimHei"]
plt.hist(df["Age"], bins=6, alpha=0.7)
plt.title("年龄分布")
plt.xlabel("年龄")
plt.ylabel("数量")
plt.show()
说明:如果图表不弹出,参考之前讲的可视化问题排查;服务器环境可以把
plt.show()替换成plt.savefig("age.png")保存图片。
运行结果:
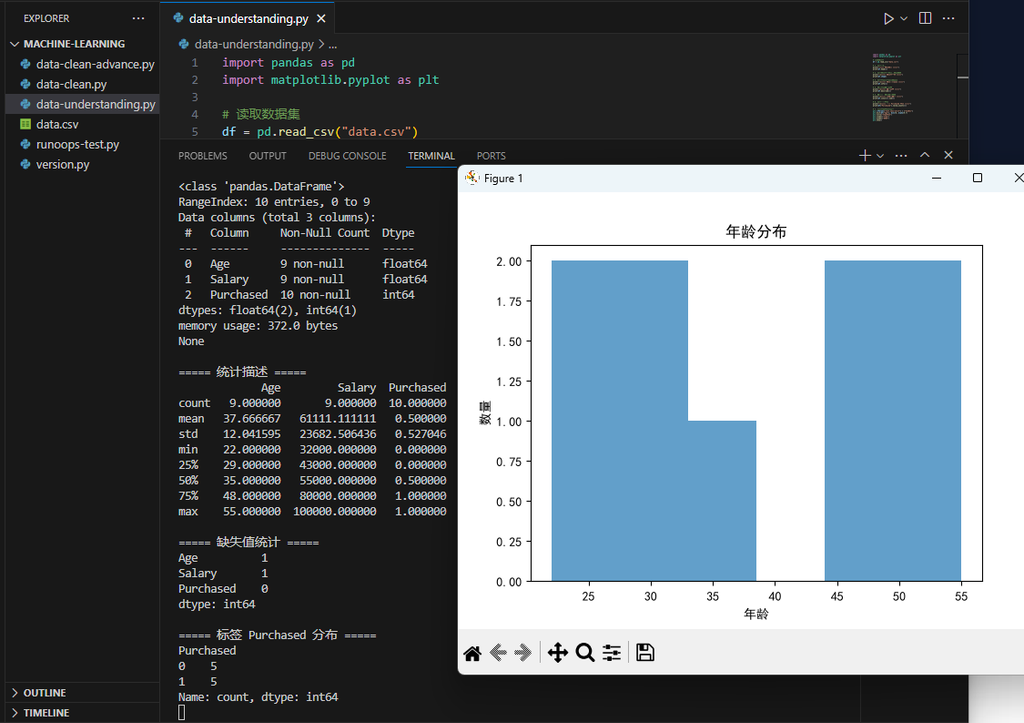
数据理解重点观察点
- 样本量是否足够,如果样本太少,模型很容易过拟合
- 标签是否均衡:比如 90% 都是 0,1 只有很少样本,属于类别不平衡
- 数值范围是否合理:年龄、薪资有没有明显异常值
- 缺失集中在哪一列,缺失比例高不高,提前规划清洗方案
数据理解输出成果
完成探查之后,我们通常会得到一份数据探查报告,包含:
- 数据集概况
- 各字段含义、类型
- 缺失情况
- 数据分布
- 发现的潜在问题清单(异常值、不平衡等)
小结
数据理解的本质是和数据“对话”。先看懂数据,再决定后续怎么清洗、怎么构造特征。跳过这一步直接建模,很容易走弯路。
思考题
df.info()和df.describe()分别适合看什么信息?- 如果标签 Purchased 里 9 条是 0,只有 1 条是 1,会带来什么问题?
0 条笔记