统计学是机器学习的底层支撑。机器学习本质上就是利用统计方法,从数据里寻找规律、估计概率、判断相关性。掌握基础统计概念,才能看懂数据分布、评估模型、识别过拟合,而不是单纯调用库函数跑代码。
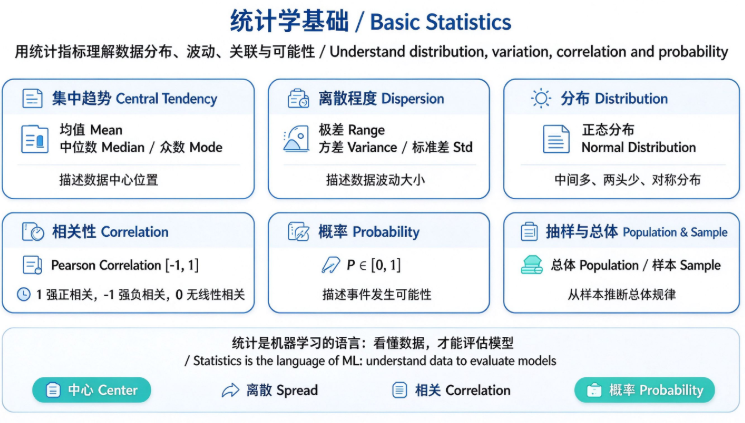
1. 集中趋势指标
用来描述一组数据的中心位置。
- 均值 Mean:所有数值求和除以样本数量,对异常值敏感。
- 中位数 Median:排序后中间位置的数,不容易被异常值干扰。
- 众数 Mode:样本里出现次数最多的值,多用于分类数据。
示例:[22,25,29,30,35,45,48,50,55,41.5](我们数据集Age填充后)
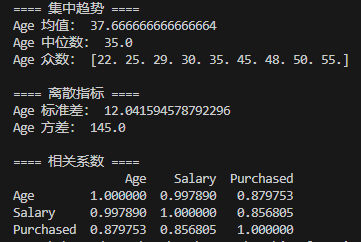
均值≈38,中位数≈40,众数这里没有重复值,不存在众数。
2. 离散程度指标
描述数据分散、波动的大小。
- 极差 Range:最大值 − 最小值,计算简单,但容易被极端值影响。
- 方差 Variance:每个数据和均值差值的平方的平均值。
- 标准差 Standard Deviation:方差开平方,单位和原始数据一致,是机器学习最常用指标。
标准差越大,代表数据越分散;标准差越小,数据越集中在均值附近。
3. 分布
正态分布(高斯分布 Normal Distribution)
数据围绕均值对称分布,中间多、两头少,是最经典的分布。很多机器学习算法(如线性回归)会假设数据近似服从正态分布。
4. 相关性
皮尔逊相关系数 Pearson Correlation,取值范围 [-1, 1]
- 接近 1:强正相关,A变大,B跟着变大
- 接近 -1:强负相关,A变大,B变小
- 接近 0:几乎没有线性相关关系
⚠️ 重点:相关 ≠ 因果。两个指标同步变化,不一定一个导致另一个变化,可能存在第三方因素。
5. 概率
概率描述事件发生可能性,取值 0~1。
- 0:一定不发生
- 1:一定发生
机器学习分类模型输出的概率,代表“属于该类别”的可能性。比如逻辑回归输出Purchased=1 的概率 0.78。
6. 抽样与总体
- 总体 Population:我们关心的全部数据
- 样本 Sample:从总体抽取的一部分数据
机器学习中,我们拿到的数据集一般只是样本,目标是让模型学到总体的规律,也就是泛化。训练集、测试集都属于样本。
7. 置信区间(简单理解)
基于样本,给出总体真实值大概率落在的区间,用来衡量统计结果是否可靠。
配套代码示例(沿用统一 data.csv)
Age,Salary,Purchased
25,40000,0
45,80000,1
30,50000,0
48,,1
22,32000,0
35,60000,1
,55000,0
50,90000,1
29,43000,0
55,100000,1
import pandas as pd
import numpy as np

df = pd.read_csv("data.csv")
df['Age'].fillna(df['Age'].mean(), inplace=True)
df['Salary'].fillna(df['Salary'].mean(), inplace=True)

# 集中趋势
print("==== 集中趋势 ====")
print("Age 均值:", df['Age'].mean())
print("Age 中位数:", df['Age'].median())
print("Age 众数:", df['Age'].mode().values)

# 离散程度
print("\n==== 离散指标 ====")
print("Age 标准差:", df['Age'].std())
print("Age 方差:", df['Age'].var())

# 相关性
print("\n==== 相关系数 ====")
print(df[['Age','Salary','Purchased']].corr())
执行结果:
统计学在机器学习里的用处
- 数据理解:用均值、标准差、相关性看懂数据集
- 特征工程:根据分布选择标准化、归一化
- 模型评估:准确率、召回率都属于统计指标
- 判断样本是否存在偏差、抽样是否合理
小结
机器学习不是黑盒魔法,很多算法背后都是统计理论。统计可以帮我们回答:数据集中在哪?波动大不大?特征之间有没有关联?样本能不能代表真实总体。看懂统计指标,才能合理分析模型结果。
思考题
- 数据里面存在极端异常值,优先用均值还是中位数描述中心?为什么?
- 相关系数等于0,代表两个特征完全没有关系吗?
0 条笔记