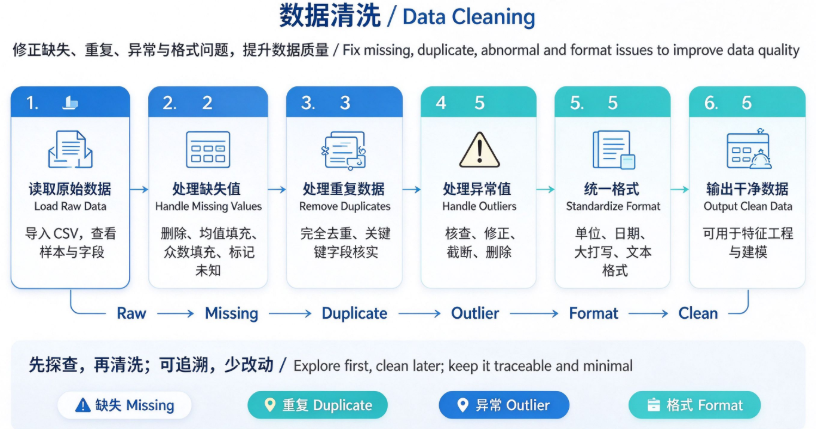
数据清洗是机器学习项目中非常关键的一步,原始数据往往存在缺失、异常、重复、格式混乱等问题。如果直接使用脏数据训练模型,很容易导致模型效果差、预测不准。数据清洗的目标就是修正或者剔除不合格数据,得到干净、规范的数据集。
为什么需要数据清洗
原始数据来源很多:表单采集、数据库导出、接口采集、日志文件等。采集过程中经常出现这些问题:
- 部分字段没有填写,产生缺失值
- 录入错误,出现异常数值
- 同一条数据重复保存
- 字段格式不统一(大小写、单位不一致)
机器学习模型对脏数据很敏感,数据清洗通常会占用整个项目 60%~80% 的工作量。
常见的数据清洗任务
1. 处理缺失值
缺失值是最常见的问题,常用处理方案:
- 删除:缺失样本数量很少时,直接删除该行
- 均值/中位数填充:适合数值型特征
- 众数填充:适合分类特征
- 标记填充:单独新增一列标记该位置原本缺失
不建议无脑填充,要结合业务含义判断。
2. 处理重复数据
完全一样或者主键重复的样本,重复参与训练会放大权重,一般直接去重。
3. 处理异常值
明显脱离正常范围的数据称为异常值,例如年龄 200、薪资负数。可以通过箱线图、标准差筛选,根据业务选择修正或者删除。
4. 统一数据格式
统一日期、文本大小写、单位,保证同列数据类型一致。
完整示例代码 + 配套 data.csv
data.csv(和代码配套,保存为 UTF-8 编码)
Age,Salary,Purchased
25,40000,0
45,80000,1
30,50000,0
48,,1
22,32000,0
35,60000,1
,55000,0
50,90000,1
29,43000,0
55,100000,1
Python 清洗代码
import pandas as pd
import numpy as np

# 读取数据
df = pd.read_csv("data.csv")
print("原始数据:")
print(df)

# 统计每一列缺失值数量
print("\n缺失值统计:")
print(df.isnull().sum())

# 使用均值填充数值列缺失值
df['Age'].fillna(df['Age'].mean(), inplace=True)
df['Salary'].fillna(df['Salary'].mean(), inplace=True)

print("\n清洗后数据:")
print(df)
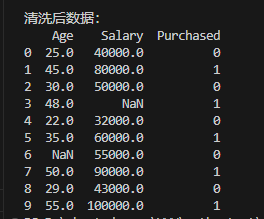
运行输出会看到:Age 和 Salary 中原先为空的位置,被该列平均值填充。
进阶清洗示例(去重 + 异常值简单检查)
import pandas as pd

df = pd.read_csv("data.csv")

# 填充缺失
df['Age'].fillna(df['Age'].mean(), inplace=True)
df['Salary'].fillna(df['Salary'].mean(), inplace=True)

# 删除完全重复行
df = df.drop_duplicates()

# 简单筛选异常值:年龄大于100视为异常
df = df[df['Age'] <= 100]

print("完成全部清洗:")
print(df)
数据清洗注意事项
- 不要盲目删除数据:样本总量很少时,删除会丢失信息
- 记录清洗操作:哪些数据被删除、填充规则是什么,需要留档
- 区分缺失原因:有些空值本身带有业务含义,不能直接填充
- 清洗不能改变标签真实信息,避免人为引入偏差
小结
数据清洗不是固定流程,没有万能方案。核心思路:先探查数据,识别脏数据类型,再选择合适的处理方式。清洗完成后的数据,才可以进入后续特征工程环节。
思考题
- 如果缺失的是分类字段(如性别),适合用均值填充吗?应该怎么处理?
- 什么时候优先删除缺失样本,什么时候优先填充?
0 条笔记