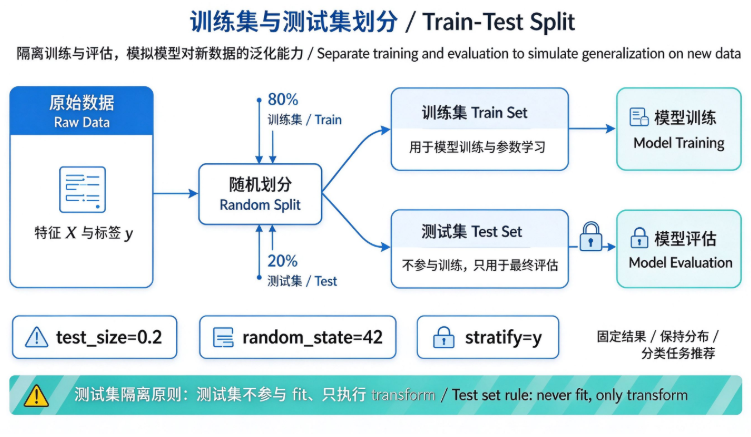
训练集与测试集划分,是特征工程完成之后、模型训练之前必不可少的一步。划分的核心目的,是模拟模型遇到从未见过的新数据时的表现,用来评估模型的泛化能力,判断模型是否过拟合。
训练集、测试集分别是什么
- 训练集(Training Set):占大部分数据,用来喂给模型,让模型学习特征和标签之间的规律。
- 测试集(Test Set):独立、不参与训练,只用来最后评估模型效果,代表未知的真实业务数据。
重要原则:测试集绝对不能参与训练、标准化、特征筛选等任何训练阶段的计算,这是防止数据泄露的关键。
常用划分比例
最经典的划分方案:
- 8:2:80%训练集,20%测试集(中小数据集首选,我们示例使用这个比例)
- 7:3:70%训练集,30%测试集,数据量很小的时候使用
大数据场景下,测试集占比可以降到 10% 甚至更低。
划分关键参数说明
random_state:随机种子,固定之后,每次运行划分结果一致,方便复现实验。stratify=y:分层采样,保证训练集、测试集中标签 0 和 1 的比例和原始数据集一致,适合分类任务,避免划分后样本分布失衡。shuffle:打乱样本顺序;时序数据(时间序列)不能打乱,需要按时间切分。
配套数据集(和前面所有文章统一)
data.csv
Age,Salary,Purchased
25,40000,0
45,80000,1
30,50000,0
48,,1
22,32000,0
35,60000,1
,55000,0
50,90000,1
29,43000,0
55,100000,1
Python 完整示例代码
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# 读取数据 + 基础清洗
df = pd.read_csv("data.csv")
df['Age'].fillna(df['Age'].mean(), inplace=True)
df['Salary'].fillna(df['Salary'].mean(), inplace=True)

# 分离特征X 和标签y
X = df[['Age', 'Salary']]
y = df['Purchased']

# 划分训练集、测试集,8:2分层划分
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42,
    stratify=y
)

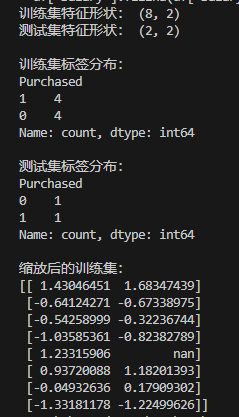
print("训练集特征形状:", X_train.shape)
print("测试集特征形状:", X_test.shape)
print("\n训练集标签分布:")
print(y_train.value_counts())
print("\n测试集标签分布:")
print(y_test.value_counts())

# ✅ 正确做法:scaler仅在训练集fit,再应用到测试集
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

print("\n缩放后的训练集:")
print(X_train)
运行结果:
常见错误(重点)
- 先整体标准化,再划分数据集:测试集信息混入训练流程,造成数据泄露,评估结果虚高,上线后效果暴跌。
- 不设置 random_state:每次划分不一样,实验结果无法复现。
- 分类任务不分层:划分后训练集几乎全是0、测试集全是1,模型评估没有意义。
- 时序数据开启 shuffle:打乱时间顺序,模型学到虚假规律。
补充:验证集(Validation Set)
部分场景会把数据切分成三份:训练集、验证集、测试集。
- 验证集:在训练过程中调参、选择模型;
- 测试集:全程封存,只在最后做一次最终评估。
小结
划分不是简单随机切一刀,核心是保证训练集和测试集分布相近、互相隔离。划分之后再进行标准化、编码等预处理,是标准机器学习流程。只有隔离的测试集,才能可信地反映模型在真实新数据上的表现。
思考题
- 为什么标准化的时候,只能用训练集 fit,不能用全部数据 fit?
- 股票、销量这类时间序列数据,划分时为什么不能打乱样本?
0 条笔记