Agent上下文工程:管好有限的记忆窗口,让智能体稳定干活
很多Agent表现差,不全是大模型推理能力弱,而是塞给模型的信息杂乱、过载或者关键信息被淹没。
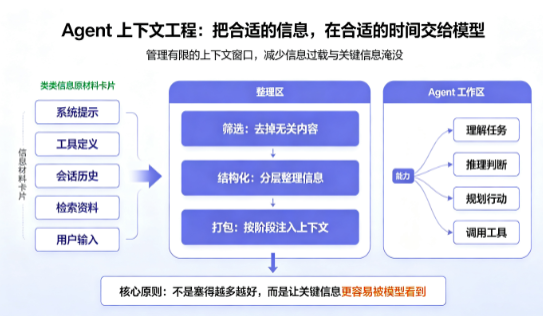
Agent上下文工程(Context Engineering),就是一套系统化管理输入信息的实践:在模型有限的上下文窗口预算之内,筛选、整理、打包信息,把真正有用的内容交给Agent,让它做出可靠判断、调用工具、完成任务。
生活化类比
把大模型的上下文窗口想象成一张办公桌,桌面空间是固定的。
Prompt、工具说明、聊天历史、检索出来的资料全都堆在桌上。
上下文工程就是整理桌面:丢掉无关废纸,重要文件放在显眼位置,按需拿取资料,不要一股脑全部铺在桌面上。桌面东西太多,反而找不到重点。
一、Agent上下文由哪几部分组成
送到大模型的完整上下文由五层信息共同构成,全部会消耗Token预算:
- 系统提示System Prompt:角色身份、行为规则、输出格式,会话全局生效;
- 工具定义Tool Definitions:Agent可以调用哪些工具、参数、用途描述;工具描述写得太啰嗦会大量占token;
- 会话历史History:之前的对话、思考过程、工具输入输出记录,会持续不断增长;
- 检索上下文Retrieved Context:RAG、向量数据库检索出来的文档片段,按需注入;
- 用户当前输入User Input:用户最新的指令、问题。
重要认知:上下文窗口有上限,所有内容加起来不能超限。而且存在**迷失在中间(Lost‑in‑the‑Middle)**现象,放在一大段内容中间的信息容易被忽略,重要规则尽量放在开头或者末尾。
二、上下文预算管理:分配有限token额度
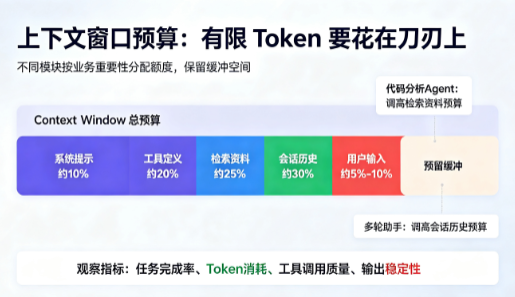
把上下文窗口当做一笔固定预算,不同类型的信息需要分配配额。举个200K上下文窗口的参考分配(可按业务调整):
- 系统提示:约10%,写清角色、核心规则,拒绝冗余废话;
- 工具定义:约20%,精简工具描述,不用的工具不要全部塞进去;
- 检索得到的资料:约25%;
- 会话历史记录:约30%;
- 用户输入:5%‑10%;
- 预留少量缓冲,防止突发超限。
不同业务侧重点不一样:
- 代码分析Agent,检索文档占比可以调高;
- 多轮对话助手,会话历史预算优先保障。
三、各个模块的工程优化技巧
1、系统提示System Prompt
不要堆砌一大堆文字,采用结构化分层书写。
- 分层组织:角色→核心规则→工作流程→输出格式,用标题分隔;
- 优先正向描述:写清楚应该怎么做,而不是只写不要做什么;
- 加入少量Few‑shot示例,比大段文字描述规则效果更好;
- 明确规则优先级,比如“安全规则优先级高于效率”;
- 定期清理,删掉不会触发的冗余规则。
2、工具定义优化
工具列表会吃掉大量token,很多Agent不稳定就是工具太多、描述冗长。
- 精简工具集:当前任务用不到的工具,不要全部加载;可以按任务阶段动态注册工具;
- 工具描述做到简短精准,参数约束写明白,减少调用参数错误;
- 不要一次性把几十种工具全部丢给模型,工具太多会出现选择困难。
3、会话历史压缩策略
多轮执行Agent,历史记录会无限膨胀,必须做压缩,常见方案:
- 滑动窗口:只保留最近N轮完整记录;适合交互轮次不多的场景;
- 分层摘要(最常用):最近几轮保留完整原始记录;更早的对话、工具执行记录,压缩成结构化摘要,保存目标、做过什么、遇到什么错误;
- 阶梯增量摘要:每执行若干轮就做一次摘要;
- 关键轮标记:只保留标记出来的重要步骤,其余丢弃;适合调试场景。
注意:不能全部直接删除历史,Agent会丢失之前做过的工作,重复执行。
4、检索的外部资料管控
RAG检索回来的内容不是越多越好:
- 做相关性过滤,低于相似度阈值的片段直接丢弃;
- 带上来源信息,方便溯源;
- 控制片段总token,防止检索内容占满全部窗口;
- 可以做查询改写,提升检索质量。
四、高级上下文模式
1、渐进式披露(按需加载)
不要任务一开始,就把全部工具、全部参考文档一次性塞进去。
执行到哪个阶段,再注入这个阶段对应的工具、资料。减少无关信息对模型的干扰,避免信息过载。
2、上下文压缩链
处理大批量数据,不要把原始全量数据送入上下文。
拆成链式多步,上一步输出精简摘要,把摘要交给下一步,原始大体积数据不再保留,始终控制上下文体量。
示例:分析大量日志
步骤1:读取日志,只统计错误类型、数量;
步骤2:基于统计结果做根因分析;
步骤3:生成修复方案;
每一步传递的是摘要,不是完整原始日志。
3、上下文水印(调试手段)
在上下文中加入标记,记录策略版本、消耗token数量、检索来源。不会影响模型输出,但调试排查问题的时候,可以快速确认上下文组装是否符合预期。
五、评估迭代:不能只靠主观感受
上下文工程不是写一次就完事,需要持续迭代优化,重点关注几个指标:
- 任务完成率:标准测试集运行,统计成功率,分析失败案例;
- token消耗:平均每次调用消耗多少token,看有没有大量无效信息;
- 工具调用质量:无效调用、错误参数调用占比;
- 输出稳定性:相同输入多次运行,格式、结果是否稳定。
根据失败案例反向定位:是系统提示问题?历史压缩策略不合理?还是检索资料质量差?针对性修改,再回归测试。
六、常见踩坑提醒
- 不是上下文越大效果越好,信息过载会造成关键信息被淹没;
- 系统提示不要无限叠加新规则,新旧规则容易互相冲突;
- 修改工具、系统提示之后,一定要做回归测试,防止老业务逻辑被破坏;
- 历史压缩策略没有万能方案,要贴合业务场景选择;
- 上下文中会携带密钥、内部路径等敏感信息,做好脱敏,不要原样输出到日志。
写在最后
很多人做Agent,把全部重心放在推理规划框架上,忽略上下文工程。
再优秀的ReAct、Plan‑and‑Execute规划框架,如果上下文信息杂乱、过载、关键信息丢失,Agent照样会表现很差。
上下文工程核心就是:在有限的窗口预算之内,合适的时机,给到Agent合适的信息。
它不是一次性写提示词,而是一套贯穿开发、测试、线上运维的持续优化工作。
0 条笔记