多模态大模型:让AI看懂图片、听懂声音
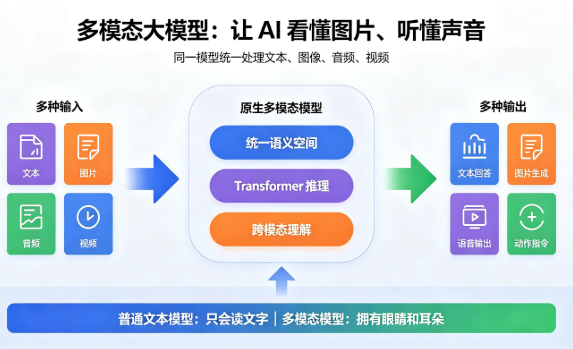
传统的大语言模型(LLM)只认识文字,只能接收和输出文本。但现实世界信息是丰富多彩的:照片、截图、录音、视频,这些都不是文字。多模态大模型,就是可以同时看懂图像、听懂音频、解析视频,并且结合文字完成理解与生成的AI模型。
通俗类比
普通文本大模型:只会读文字的读书人,看不到照片,听不到声音。
多模态大模型:拥有眼睛、耳朵的人,既能读文字,也能看图片、听语音,综合多种感官信息做判断。
模态(Modality):信息的载体形式。文本、图片、音频、视频都属于不同模态。
一、多模态发展的三个阶段
多模态并不是一夜之间成熟,经历了三代演变:
- 第一阶段:纯文本LLM
输入输出全部只有文字。擅长写作、推理、写代码;短板:看不见任何图像、无法处理声音。代表:早期GPT‑3、Claude‑2。 - 第二阶段:VLM视觉‑语言模型
在语言大模型基础上增加视觉编码器,支持图片+文字输入,输出还是文字。可以做截图问答、OCR识别、看懂图表,但原生不擅长音频、视频生成。代表:GPT‑4V、Qwen‑VL。 - 第三阶段:原生多模态模型
训练阶段就把文本、图像、音频、视频全部纳入统一框架。输入可以是任意模态组合,输出也可以产出图片、语音。这是现在行业主流发展方向。
二、多模态内部到底是怎么工作的?
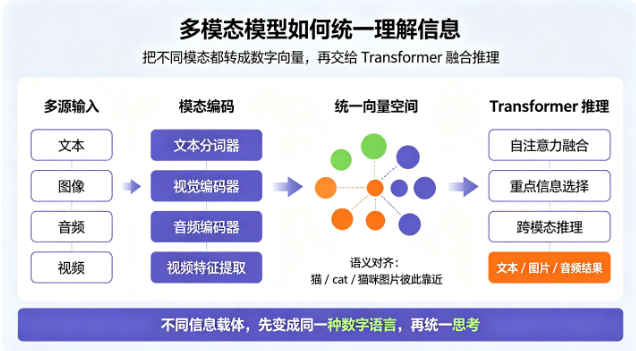
核心思想:把图片、声音、文字全部转化为统一的数字向量(Embedding嵌入),放到同一个语义空间,交给Transformer做统一推理。
举个例子:文字“一只猫”、英文“cat”、一张猫咪图片,经过编码器之后,在向量空间里面位置会靠得很近,模型知道它们表达同一个事物。
完整处理流程分为三步:
- 模态编码
不同类型的数据交给各自编码器:文本分词、图像提取视觉特征、音频解析频谱特征,全部转换成数字向量。 - 对齐到统一语义空间
不同模态的特征做对齐,建立跨模态的关联,图片里的物体可以和文字描述对应起来。 - Transformer推理与解码输出
利用自注意力机制,把图文音信息融合推理;最后解码器根据任务需求,输出文本、图片或者音频。
关键点:Transformer的自注意力Attention是实现多模态融合的核心,它可以自主判断:图片哪一块区域、哪段文字、哪段音频片段是重点信息。
三、多模态五大核心能力
1. 图像理解
接收照片、截图、图表。
常见场景:截图排查程序报错、读取PDF里的图表、手写文字识别、照片内容问答。
2. 图像生成
接收文字提示,产出图片;也支持图生图,参考原图做修改。比如生成海报、插画。
3. 语音交互
包含ASR语音转文字、TTS文字转语音。听懂人说话,也可以合成语音输出,用于实时对话、会议录音总结。
4. 视频理解
读取视频,理解画面、时序变化。可以对长视频做摘要、定位关键事件、根据视频内容问答。
5. 多模态Agent
把看、听的能力和智能体结合。接收截图、语音指令,调用工具完成任务,例如:看截图分析问题之后自动写修复代码。
四、高频基础术语科普
- Token词元:模型处理信息的最小单元,文本、图像块、音频片段都会被处理成token。
- Embedding嵌入:把图片、文字、声音,转换成一组数字向量,用来衡量语义相似度。
- Attention注意力:模型自主选择重点,看图的时候聚焦关键物体,读文字聚焦关键句子。
- 上下文窗口:模型一次性可以处理的token上限,图片、视频同样会消耗token额度。
五、极简Python实战:图片问答
现在绝大多数云大模型API都兼容OpenAI接口格式,只需要把图片转为base64,放到消息的content数组,就可以实现图像问答。
from openai import OpenAI import base64 from PIL import Image from io import BytesIOdef img_to_base64(img_path):
"""本地图片转为base64字符串"""
img = Image.open(img_path).convert("RGB")
buf = BytesIO()
img.save(buf, format="JPEG")
return base64.b64encode(buf.getvalue()).decode("utf‑8") client = OpenAI(
api_key="你的密钥",
base_url="模型服务地址"
) img_b64 = img_to_base64("./cat.jpg") resp = client.chat.completions.create(
model="支持多模态的模型名称",
messages=[
{
"role":"user",
"content":[
{"type":"text","text":"描述这张图片里面有什么"},
{"type":"image_url","image_url":{"url":f"data:image/jpeg;base64,{img_b64}"}}
]
}
]
)print(resp.choices[0].message.content)
简单扩展:
- 语音:消息中使用
input_audio类型,传入音频base64;- 多轮对话:把历史消息持续加入messages列表。
六、实际选型建议
- 只做纯文本任务:不需要多模态,普通LLM性价比更高。
- 只需要看图理解(截图、图表):VLM视觉语言模型就够用。
- 需要同时处理图片+音频+视频:选择原生多模态模型。
- 部署方面:小参数量开源多模态模型(如Qwen2‑VL)可以在消费显卡本地运行;大尺寸模型一般调用云端API。
七、现实局限
- 图片、视频会大量消耗token,大图长视频会拉高调用成本;
- 图像幻觉依旧存在:看图也会编造不存在物体、细节;
- 复杂视频时序推理难度高,超长视频容易丢失细节。
写在最后
多模态大模型,让AI不再局限于文字世界,拥有了“视觉”和“听觉”。
它不是简单的在文本模型上外挂看图插件,而是把图像、音频、文字统一到一套推理框架。
结合Agent智能体之后,接收截图、语音指令自动干活,也是未来AI应用的重要方向。
学习小路径:先掌握普通LLM文本调用 → 再上手图片问答 → 尝试音频输入 → 最后做多模态Agent项目。
0 条笔记