向量数据库通俗解读:大模型RAG的语义搜索引擎
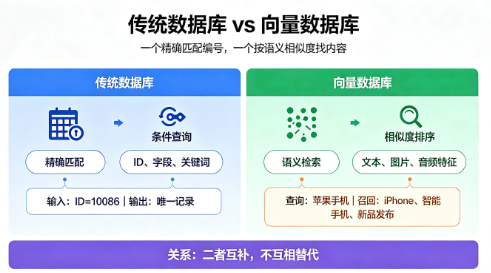
普通MySQL、PostgreSQL这类传统数据库擅长精确关键词匹配,而向量数据库专门用来做语义相似度检索,是构建RAG知识库、AI Agent记忆系统的核心基础设施。它不看字面是否一样,而是判断两段内容“意思像不像”。
生活化类比
传统数据库:去图书馆,输入书的编号,精确找到某一本指定书籍。
向量数据库:告诉图书馆,我想要和《三体》风格接近的科幻小说,系统根据内容含义,找出一批题材、调性相似的书。
一、核心概念:向量与Embedding嵌入
向量Vector:一串浮点数数字,例如[0.13,-0.45,0.77……],代表文本、图片、音频的语义特征。
Embedding嵌入:借助嵌入模型,把文字、图片、音频转换成向量数字的过程。
核心规律:语义含义越接近,在高维向量空间里面,两个向量距离就越近。
比如“iPhone”和“苹果手机”字面文字完全不一样,但语义一致,经过同一个嵌入模型转换之后,向量距离会非常靠近。
注意:不同的嵌入模型生成的向量,处于完全不同的坐标空间,不能互相拿来计算相似度。入库和查询,必须使用完全一样的嵌入模型,否则检索结果完全不可信。
二、相似度怎么算
拿到两组向量,需要计算二者之间相似程度,工业界三种主流方式:
- 余弦相似度Cosine Similarity(文本首选):只看向量方向,忽略长度。取值-1~1,越靠近1代表越相似,RAG文本检索绝大多数场景使用这个。
- 欧氏距离Euclidean Distance:计算空间直线距离,数值越小越相似,多用于图像。
- 点积Dot Product:同时兼顾方向与向量长度,向量做归一化处理后等价余弦相似度,多用于推荐系统。
三、索引:解决海量数据查询太慢
如果库里有几十万、上百万条向量,每一次查询把全部向量挨个算一遍距离(暴力检索Flat),速度会慢到无法使用。
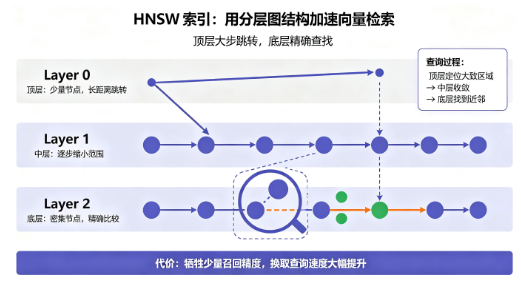
索引就是一套加速算法,用轻微牺牲一点点召回精度,换取查询速度大幅提升,这一类统称为ANN近似最近邻搜索。
- Flat暴力检索:全部向量逐一计算,结果100%准确;数据量大速度极差,适合十万以内小数据集。
- IVF倒排索引:先聚类分桶,查询只在少数几个桶内部搜索。适合中等规模数据。
- HNSW分层导航小世界图:现在工业界最主流。构建多层图结构,顶层大步跳转快速定位大致区域,逐层下探做精确查找,兼顾速度与召回效果,绝大多数生产环境优先选择HNSW索引。
四、向量数据库能干什么
- RAG检索增强生成(最主流):私有文档、知识库切成片段转为向量存储;用户提问把问题转向量,检索语义最相关片段,把片段丢给大模型做回答,缓解幻觉,弥补大模型训练截止之后知识不足的问题。
- 多模态检索:以图搜图、音频检索;
- 推荐系统:找到偏好相似的用户、商品;
- 内容去重、版权检测、异常日志检测;
- AI Agent长期记忆存储:保存Agent历史对话、经验记忆,需要的时候语义召回历史记录。
重要认知:向量数据库不会替代MySQL。二者互补使用:传统数据库存放订单、用户账号这类结构化业务数据;向量库专门负责语义、特征检索。
五、主流向量数据库选型参考
| 产品 | 部署方式 | 特点 | 适合场景 |
|---|---|---|---|
| Chroma | 开源本地嵌入式 | API极简,上手简单 | 本地原型、Demo开发,学习调试RAG |
| pgvector | PostgreSQL插件 | 复用现有PostgreSQL,不用新增一套运维 | 业务已经在用PostgreSQL,千万以内规模 |
| Qdrant | 开源自托管 /云服务 | Rust实现,性能强,支持元数据过滤 | 生产环境,中等大数据量 |
| Milvus | 开源分布式 | 支持大规模集群 | 亿级向量,企业大型系统 |
| Pinecone | SaaS云托管 | 完全托管,不用运维 | 不想维护服务器,快速上线 |
新手建议:学习原型优先Chroma;项目已经使用PostgreSQL优先pgvector;生产高性能优先Qdrant。
六、RAG完整简易流程
- 原始文档做分块Chunk切分,不能直接丢整篇超长文档;
- 调用Embedding嵌入模型,每个文档片段生成向量;
- 向量连同原文、元数据存入向量数据库;
- 用户提问,把用户问题同样用同一个嵌入模型转为向量;
- 在向量库做相似度检索,取出top‑k个最相关文档片段;
- 将检索出来的片段+用户问题一起组装提示词送入LLM;
- 大模型基于参考资料输出答案返回用户。
七、开发中高频踩坑提醒
- 嵌入模型必须统一:插入文档、用户查询,必须用一模一样的嵌入模型,更换模型必须全部重新向量化重建库,不能混用不同模型生成的向量;
- 文档分块Chunk很关键:块太大语义混杂,块太小信息残缺;一般中文512‑1024token,块之间设置少量重叠;
- 不要无脑把top‑k设置很大,RAG一般取3‑8条;
- 向量库只管检索,不负责大模型生成;检索出来的内容质量直接决定最终回答质量;
- 元数据metadata善用,做过滤条件,缩小检索范围,提升准确性。
写在最后
向量数据库的本质,是高维向量的专用存储与相似度检索引擎。它不是大模型,是AI的“外部书架”。
在RAG、Agent长期记忆、多模态检索场景是必不可少组件。但向量数据库本身不能解决全部幻觉,检索到错误内容,依旧会传给大模型产生错误回答。
选型上,优先看业务规模、现有技术栈,不要盲目追求分布式、超大型向量库;很多中小型项目pgvector、Chroma就足够满足需求。
0 条笔记