读懂Token(词元):大模型世界的文本原子
不管是使用ChatGPT、豆包、DeepSeek,还是开发AI Agent、写提示词,你总会看到一个名词:Token,中文叫词元。它是大模型处理文字的最小计算单位,计费、记忆容量、输出速度全部由它决定,是理解大模型的基础概念。
生活化类比
把一段文字比作一张披萨。人类阅读,是按完整句子、词语理解;而大模型不会直接读取整篇文字,会先用工具(分词器Tokenizer)把披萨切成一块块大小不一的小块,每一块就是一个Token。模型吃进这些小块做计算,最后再把小块拼接变回人类可读的文字。
一、Token到底是什么
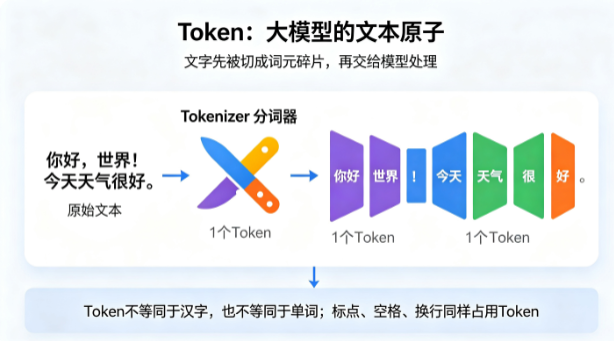
Token不是汉字,也不等于英文单词。
它是介于字符和完整词语之间的文本片段。高频常用词会合并为一个Token;生僻长词会被拆成多个碎片;标点、空格、换行符号,也会单独占用Token名额。
简单例子:
- 英文普通单词:
cat→ 1个Token - 英文长难词:
unbelievable→ 拆成un+believ+able,3个Token - 中文句子:
你好,世界!,中文消耗Token普遍高于英文,一个汉字通常约1‑2个Token - 符号:逗号、感叹号、空格,全部会计入Token计数。
关键点:不同模型分词器(Tokenizer)不一样,同一段文字,在不同模型上统计出来的Token数量会略有区别。
二、Token三个核心作用
1、决定模型的短期记忆:上下文窗口Context Window
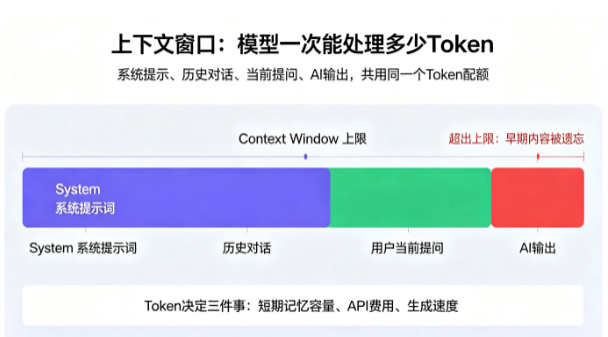
每一个大模型都有固定的上下文窗口,代表这一轮对话最多能处理多少Token。
这个窗口里面包含:系统提示词、全部历史对话、用户当前提问、AI即将输出的回答,全部加起来不能超过上限。
举几个常见模型参考:
- GPT‑3.5:4K Token
- GPT‑4 Turbo:128K Token
- Claude 3.5:200K Token
一旦超过窗口上限,模型就会遗忘最早的一部分内容。
提示词工程中著名的「迷失在中间Lost‑in‑the‑Middle」现象:放在一大段文本中间的内容,更容易被模型忽略。重要指令尽量放在提示词的开头或者末尾。
2、API调用的计费单位
云端大模型API,按照Token数量收费,分为输入Token、输出Token两部分计费:
- 输入Token:你发给模型的提示词、参考文档、对话历史;
- 输出Token:AI生成返回给你的内容;
通常输出Token单价会高于输入。
想要降低成本,提示词尽量精炼,减少冗余文字,长文档优先做摘要再送入模型。
3、决定生成回复的速度
大模型生成回答是一个Token接着一个Token逐词预测输出。输出的Token越多,等待时间越长。这就是流式输出打字效果的底层原理。
三、实用估算经验
- 英文:1000 Token ≈ 750个英文单词;
- 中文:1000 Token大约500‑700个汉字,不同模型差异较大,只能作为粗略估算;
- 代码、JSON:符号多,Token消耗和普通散文不一样;
- emoji表情、特殊符号也会消耗Token。
注意:上面全部是估算,想要精确数值,要使用对应模型配套的Tokenizer工具统计,不能直接按汉字、单词换算。
四、开发者与提示词使用者的实践启示
- 写System系统提示词,尽量精简,去掉废话,节约宝贵的Token额度;
- 长文档不要直接整段丢给模型,可以使用RAG检索增强,只送入相关片段,避免撑爆上下文窗口;
- 多轮对话场景:对话历史会持续累积Token,对话很长的时候,需要做摘要压缩或者重置会话;
- Agent开发中:图片、音频、多模态输入,同样会换算消耗Token,大图、长视频成本会明显上涨;
- 不要凭“字数”判断,只可以做估算,正式业务使用Tokenizer工具精确统计。
五、常见误区澄清
❌误区1:1Token=1个汉字 / 1个英文单词。
✅事实:没有严格一一对应关系,是子词碎片,由分词器算法BPE/SentencePiece决定。
❌误区2:只有文字才消耗Token。
✅事实:标点、空格、换行、图片、音频(多模态)全部占用Token配额。
❌误区3:字数一样,Token消耗就一样。
✅事实:同样字数,生僻词多的文本,Token消耗会更高。
写在最后
Token是大模型世界的基础计量单位,理解它,看懂Token消耗、上下文窗口的概念,不管是写提示词、调用API,还是开发AI Agent,都非常关键。
- 它是模型读取信息的最小碎片;
- 它限制模型一次能记住多少内容;
- 它是花钱计费、判断响应速度的标尺。
小建议:做重要业务,不要依赖肉眼估算Token,尽量使用模型官方Tokenizer工具统计真实消耗。
0 条笔记