RAG检索增强生成:让大模型用上私有知识库
RAG全称Retrieval‑Augmented Generation 检索增强生成,是大模型落地私有知识库最主流的方案。
简单理解:不直接让大模型凭空回答,先从自己的文档库检索相关资料,把资料交给大模型,模型参考资料再输出答案。
生活化类比
大模型就像记忆力有限的考生;RAG相当于开卷考试。考试的时候不许完全凭脑子回忆,先去翻阅指定参考书,找到对应段落,再结合书本内容作答。
可以解决两大痛点:①大模型知识有训练截止时间,不知道新资料;②缓解AI一本正经编造事实的幻觉问题。
一、两条核心流水线
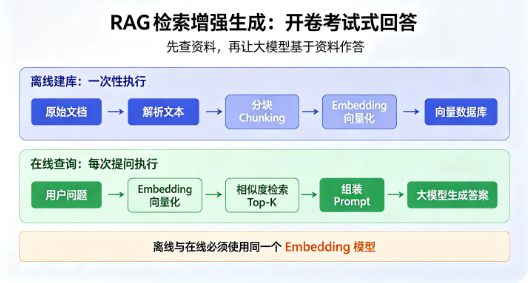
RAG分为离线预处理流水线(一次性执行)、在线查询流水线(用户每提问都要跑)。
1. 离线索引流水线(建库阶段,做一次)
- 文档解析:读取PDF、Word、Markdown,处理表格、图片,把复杂文档转为干净文本;
- 文档分块Chunking:把长文档切成一个个小片段;
- Embedding嵌入:每个片段转为向量;
- 入库:向量+原文+元数据存入向量数据库。
⚠️重点:离线是一次性工作,文档更新时,需要重新做分块、向量化、更新库。
2. 在线查询流水线(用户提问,每次都执行)
- 用户输入问题;
- 用户问题经过同一个嵌入模型转为查询向量;
- 在向量数据库做相似度检索,召回top‑k个最相关文档片段;
- 将用户问题 + 检索出来的文档片段拼装成Prompt;
- 大模型读取上下文,基于参考资料生成答案,返回给用户。
重要提醒:离线、在线,必须使用完全相同的Embedding嵌入模型,否则检索结果会完全错乱。
二、文档分块Chunking,RAG成败的关键
分块就是把长篇大论切为小块,块大小直接影响最终效果:
- 块太大:一块里面混杂很多无关内容,引入噪声,造成“上下文淹没”;
- 块太小:语义被切碎,单块信息残缺,检索到也无法回答完整问题。
常用策略:
- 固定大小切分:最简单,按token数量切割;缺点可能把完整一句话拦腰切断。
- 递归字符切分:优先按换行、句号等语义分隔符切割,适合Markdown、文章,工业界最常用。设置
chunk_overlap块重叠,相邻块少量文字重复,防止边界信息丢失。 - 语义切分:计算句子之间向量相似度,语义发生转折才切开;效果好,但计算开销高。
- 父子文档检索Small‑to‑Big:用小文档块做检索,命中之后,把对应的大父文档交给LLM;兼顾检索精度和上下文完整性,代价是存储成本翻倍。
通用经验:中文一般512‑1024token,重叠50‑100token。
三、基础Naive‑RAG会遇到哪些问题
最简单的基础RAG,只做向量检索,生产环境常常踩坑:
- 用户提问口语化,和文档书面语言差距大,检索不到;
- 专有名词、错误代码编号,纯向量检索容易搜不准;
- 召回一堆文档,良莠不齐,无关内容混进去,大模型被噪声干扰;
- 检索不到有效内容的时候,大模型依旧强行编造答案。
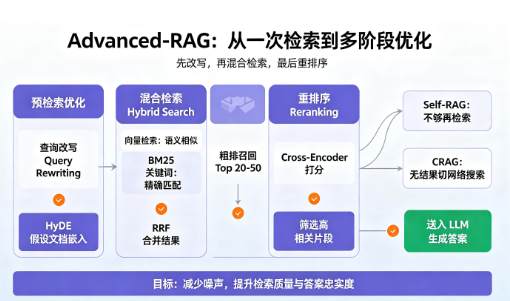
于是诞生Advanced‑RAG进阶RAG,分为预检索优化、检索融合、后检索优化三段。
四、Advanced‑RAG进阶RAG常用技术
1、预检索优化(改写用户问题)
- Query Rewriting查询改写:LLM把口语化提问改写为更适合检索的书面问句;
- HyDE假设文档嵌入:先让大模型生成一份假想的参考答案,拿这份假想答案的向量去检索,缩小用户提问和文档用词的鸿沟。
2、混合检索Hybrid Search
向量检索 + BM25关键词检索两路并行,再用RRF倒数排序融合合并结果。
- 向量检索:擅长语义,同义词、不同说法能匹配;
- BM25关键词检索:擅长专有名词、编码、型号的精确文字匹配。
技术文档、设备手册、代码知识库强烈推荐开启混合检索。
3、后检索优化:重排序Reranking
两阶段模式:
- 粗排:向量/混合检索,先召回比较多的候选文档(top20‑50);
- 精排:使用Cross‑Encoder重排序模型,把“问题+文档”成对打分,筛选质量最高少数几条交给大模型。
重排序计算成本高,不会处理全部文档,只对粗排出来的候选做二次打分。
4、Self‑RAG / CRAG纠错增强
- Self‑RAG:检索之后,大模型自己评估拿到的资料够不够用,不够就再次触发检索;
- CRAG纠正型RAG:评估发现本地知识库没有有效信息,自动切换调用网络搜索,防止硬靠错误资料生成答案。
五、GraphRAG图检索增强
传统RAG把文档全部当成独立碎片,很难做多跳推理。
比如提问:找出A公司和B公司共同投资的企业,普通RAG很难完成。
GraphRAG做法:
- 离线阶段:从文档提取实体、关系三元组,存入知识图谱;
- 在线查询:同时走两路:向量检索文本片段 + 知识图谱遍历实体关系;
- 将文本片段和图谱关系一起送入大模型生成回答。
GraphRAG不是万能:构建图谱成本很高,适合实体关系丰富的场景;普通问答知识库不必盲目上GraphRAG。
六、RAG怎么评测(RAGAS框架)
不能凭人的主观感受判断RAG好坏,RAGAS是业界自动化评测框架,四大核心指标全部0‑1,越接近1越好:
- Context Recall召回率:标准答案需要的知识点,有多少被成功检索出来;低分代表关键信息漏检。
- Context Precision精确率:检索回来的文档里面,有多少是真正和问题相关。
- Faithfulness忠实度(防幻觉):大模型输出的每一条结论,是否都能在检索上下文找到依据;低分说明AI在瞎编。
- Answer Relevance答案相关性:输出的回答是否真的在解答用户的提问,避免答非所问。
根据分数可以定位问题:召回低→优化检索;忠实度低→提示词约束或者检索到垃圾内容。
七、选型与落地踩坑总结
嵌入模型选型
- 闭源:OpenAI text‑embedding‑3‑small;
- 开源中文:BAAI/bge‑m3;
- 多模态图文:CLIP系列。
高频踩坑清单
- ❌离线、在线使用不一样的Embedding模型 → 向量空间不匹配,检索完全失效;
- ❌文档没有做合理分块,直接把整份PDF丢进去;
- ❌只靠纯向量检索,专有名词场景没有开启Hybrid混合检索;
- ❌不做重排序,直接把大量文档全部丢进Prompt,上下文淹没;
- ❌没有设置兜底逻辑,检索不到资料时,模型依旧强行编造;
- ❌忽略Token上限,检索返回过多片段,撑爆上下文窗口。
落地思路:优先把基础Naive‑RAG调通;遇到问题再叠加改写、混合检索、重排序;普通业务不要一上来直接上GraphRAG,增加大量维护成本。
写在最后
RAG的本质:给大模型配备外部知识库,让AI回答可以基于私有文档,缓解知识滞后与幻觉。
- 基础RAG适合简单知识库;
- 进阶Advanced‑RAG,通过查询改写、混合检索、重排序,解决复杂业务;
- GraphRAG适合实体关系多跳推理场景;
- RAGAS用来做自动化评测,定位是分块问题、检索问题,还是生成提示词的问题。
RAG不是银弹,如果检索拿到的就是错误内容,大模型依旧会输出错误答案,检索质量决定了RAG系统的天花板。
0 条笔记