AI Agent推理与规划:让智能体学会拆解任务、自我纠错
大模型本身擅长问答,但面对复杂现实任务,常常需要多步操作、调用工具、根据中间结果调整方案。推理与规划(Reasoning & Planning)就是AI Agent的思考引擎,决定智能体能不能把一个宏大目标拆成可落地子任务,并且在遇到失败时自我修正。
生活化类比
把Agent想象成项目经理:
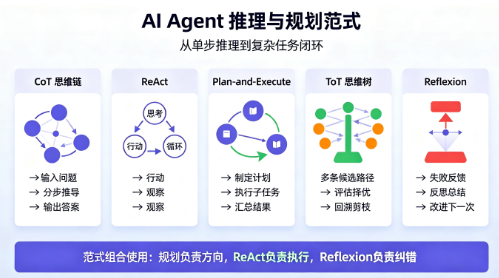
- CoT思维链:做题时在草稿纸上一步步演算;
- ReAct:一边思考、一边动手干活,做完看结果再想下一步;
- Plan‑and‑Execute:先写完整项目计划,再分派任务逐个执行;
- ToT思维树:同时构思好几套方案,对比择优;
- Reflexion:做完复盘,总结踩过的坑,下次避免重蹈覆辙。
一、CoT 思维链 Chain‑of‑Thought
核心:先写中间推导过程,再输出最终答案。
普通提问直接要结论,大模型容易“猜答案”;CoT强制模型把思考草稿输出出来,基于中间步骤再得出结论,数学、逻辑题准确率明显提升。
提示词简单写法:
请一步一步思考,先写出推导过程,再给出最终答案。
✅优点:实现最简单,只靠提示词,不用调用外部工具;
❌缺点:只能在脑子里推理,不能调用工具和外部系统,遇到需要查资料、运行代码的任务无能为力。
适用场景:数学计算、逻辑判断题,纯文本推理。
二、ReAct 推理‑行动循环 Reason + Act
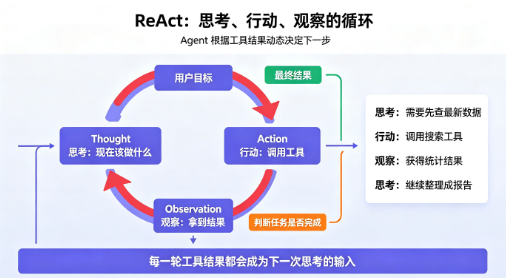
CoT只是脑子里空想;ReAct让思考和真实行动交替进行,是Agent最基础的工作循环。
循环三步:
- Thought思考:结合目标和已有结果,分析现在该干什么;
- Action行动:调用搜索、代码、API等外部工具;
- Observation观察:拿到工具返回结果,存入记忆,进入下一轮思考。
不断重复循环,直到判断任务完成。
✅优点:可以联动真实外部工具,根据工具反馈动态调整策略;实现简单,绝大多数入门Agent都用这套范式。
❌缺点:每一轮思考、工具结果全部塞进上下文窗口;任务步骤很长时,token快速膨胀,容易遗忘最初目标,甚至死循环。
适用场景:步骤不多、动态变化的任务,比如查资料做简单调研。
三、Plan‑and‑Execute 先规划,后执行
为了解决ReAct长任务容易失控的问题,把系统拆成两大角色:
- Planner规划者:拿到高层大目标,先生成完整分步任务清单;
- Executor执行者:相当于小型ReAct Agent,只负责执行当前单个子任务。
类比项目经理:先输出完整项目排期,再交给工人逐个落地。
✅优点:适合长线复杂任务,整体目标清晰,减少长链条遗忘问题;
❌缺点:如果现实发生意料之外变化,最开始写的计划会过时,需要重新规划。
适用场景:长文档分析、完整调研报告、多阶段项目。
四、ToT 思维树 Tree‑of‑Thoughts
CoT、ReAct都是一条道走到黑的线性思考。
ToT会同时生成多条推理分支,评估每条路径好坏,择优前进,甚至走不通就回溯换方案。
就像解难题,同时试2‑3种解题思路,评估哪个方向更可行,放弃死胡同。还可以搭配广度优先、深度优先搜索算法。
✅优点:适合需要多方案对比、创意、高难度逻辑问题;
❌缺点:要跑多条推理路径,token消耗成倍增加,成本很高。
适用场景:复杂数学、创意写作、游戏策略。
五、Reflexion 反思纠错机制
人类做完事情会复盘,Reflexion给Agent增加复盘能力。
工作流程:执行任务 → 判断失败(代码报错、结果不对)→ Reviewer评审模块写出反思总结,记录错误根源和改进办法,存入记忆;下一轮执行把反思作为参考,规避同类错误。
示例反思:
刚才API参数格式写错,接下来输出JSON要检查字段名称。
✅优点:具备自愈合能力,同样错误不会反复踩坑;
❌缺点:依赖明确的失败反馈(代码报错、测试结果);开放式主观任务很难判断是否失败,效果有限。
适用场景:代码生成、测试、有明确对错标准的任务。
六、MCTS蒙特卡洛树搜索
难度更高的搜索方案,借鉴AlphaGo下棋思路。大模型充当策略网络给出候选行动,仿真推演评估成功率,在庞大可能性空间里面挑选最优路径。一般用于极高难度的科研、复杂游戏场景,普通业务Agent很少直接使用。
七、工程落地:不要完全交给大模型自由规划
纯靠LLM零样本自由规划稳定性并不高,生产环境常用几种混合手段:
- SOP模板化:高频固定业务,预先写好标准流程,大模型只做填内容,不允许自由拆解步骤;
- HITL人在回路 Human‑in‑the‑Loop:Planner生成计划之后,关键步骤交给人类确认再执行;高危操作禁止Agent自主执行;
- 设置最大循环轮次,防止死循环;
- 混合架构:顶层用Plan‑and‑Execute做大任务拆分,每个子步骤内部跑ReAct,出错触发Reflexion反思。
各范式对比简表
| 范式 | 核心思路 | 优势 | 短板 | 适合场景 |
|---|---|---|---|---|
| CoT | 分步内部推理 | 实现简单,提升逻辑题准确率 | 不能调用工具 | 数学、纯文本推理 |
| ReAct | 思考‑行动‑观察循环 | 联动外部工具,动态调整 | 长任务上下文爆炸 | 中等步骤任务 |
| Plan‑and‑Execute | 先生成完整计划,再执行 | 长任务目标清晰 | 突发情况计划容易失效 | 大型复杂项目 |
| ToT | 多分支树状探索,择优回溯 | 多方案对比,难题能力强 | token开销巨大 | 创意、高难度逻辑 |
| Reflexion | 失败后复盘反思存入记忆 | 自我纠错,避免重复踩坑 | 依赖明确失败信号 | 代码、有客观判据任务 |
写在最后
推理规划是Agent的思考大脑,不同范式没有绝对好坏,看业务场景选择。
- 简单工具调用任务,ReAct够用;
- 大型复杂任务优先Plan‑and‑Execute;
- 需要自我纠错叠加Reflexion;
- 普通业务系统,不盲目追求完全自主规划,可以结合SOP、人工介入提升稳定性。
开发小提示:现实项目很少只用单一范式,大多是多种范式组合使用。
0 条笔记