大语言模型LLM通俗解读:AI Agent的“大脑”
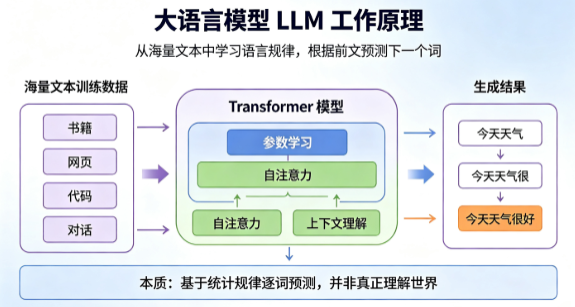
大语言模型(LLM)是整套AI系统、AI Agent的核心大脑。很多人以为大模型拥有真正的思考理解能力,实际上它的本质是在海量文本之上学习语言统计规律,逐个预测下一个token,生成通顺文本。它不会真正“懂得”世界,只是擅长模仿人类语言模式。
生活化类比
LLM就像博览群书的学生。训练阶段读海量书籍、网页、代码,不去死记硬背全文,而是学习文字之间的关联规律;提问的时候,根据前面的文字,猜接下来最合理的内容,一段一段拼接出完整回答。
一、什么是大语言模型?
“大”体现在两点:
- 参数量巨大:内部数十亿、上万亿可学习参数,存储从数据中学到的语言、常识、逻辑模式;
- 训练数据海量:阅读互联网公开文本、书籍、代码等海量素材。
生成机制:逐词预测下一个Token
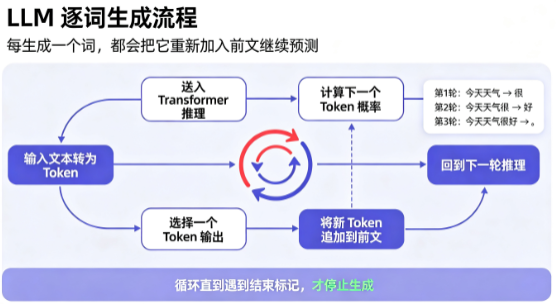
大模型不会一次性输出整段文字,执行推理的时候是循环工作:
- 把用户输入全部转为Token(模型处理文本最小单元,中文一个汉字约等于2个token);
- 根据全部前文,计算出下一个token的概率分布;
- 挑选合适的token作为输出;
- 把刚生成的词追加到输入末尾,重复计算,循环直到遇到结束标记。
举例子,输入:
今天天气
第一轮:输入“今天天气”,预测出很;
第二轮:输入变成今天天气很,再预测出好;
不断循环,生成完整句子。
二、底层核心:Transformer与自注意力Self‑Attention
现在几乎所有主流LLM都基于Transformer架构,其中自注意力机制Self‑Attention是最关键的创新。
自注意力的作用:处理句子里每一个token的时候,可以同时权衡句子中所有其他token的关联权重。
例句:
苹果的手机,它的电池很大
当处理“它”这个词,自注意力机制可以识别出,“它”指代的是“手机”,而不是苹果。
对比老一代RNN:RNN只能顺序一个词一个词处理,很难捕捉长距离文字关联;Transformer自注意力可以并行计算,长文本上下文理解能力强很多。
完整推理流程:
- 文本分词转为Token,映射成数字向量,加上位置编码;
- 自注意力层,计算词与词之间的关联;
- 前馈网络进一步加工特征;
- 输出层计算下一个token概率,选出输出;
- 循环执行,直到生成结束。
三、大模型与生俱来的短板
即便能力强大,LLM本身存在天然局限,做Agent开发时必须心里有数:
| 问题 | 现象说明 | 解决思路 |
|---|---|---|
| 知识截止 | 训练数据有时间终点,不知道截止时间之后发生的新闻事件 | 调用搜索工具,接入外部实时信息 |
| 幻觉 | 一本正经编造不存在事实、文献、数字 | RAG检索知识库、工具校验结果 |
| 长上下文遗忘 | 输入文本超长,会丢失早期部分信息 | 控制输入长度、摘要压缩、优化检索 |
| 复杂计算薄弱 | 简单加减尚可,复杂数学、统计容易算错 | 交给代码解释器工具执行计算 |
| 没有现实操作能力 | 不能联网、读写文件、访问数据库 | 依靠Tool‑Calling工具调用扩展能力 |
重点:原生LLM只是“大脑”,没有手脚,不能触碰外部真实世界。Agent就是给这个大脑配上工具、记忆、规划循环,弥补这些短板。
四、Prompt提示词:和大模型沟通的语言
Prompt就是给到大模型的全部输入指令,写好Prompt,可以大幅提升输出质量。
一条高质量Prompt一般包含四部分:
- 角色与上下文:告诉模型身份、背景信息;
- 明确任务指令:清晰说明要完成什么;
- 示例(Few‑shot,可选):给1‑N组输入输出样例,引导输出格式;
- 输出格式约束:指定JSON、列表、分段等格式。
实用小技巧:遇到复杂推理任务,可以用CoT思维链,在提示词中要求模型“一步步思考,先写出推导过程再给出答案”,推理准确率会明显提升。
五、调用大模型:API接入方式
实际开发AI Agent,几乎不会本地完整训练大模型,大多通过API调用现成服务。
通用逻辑:把提示词组装成消息列表,通过HTTP网络请求发送给模型服务商;服务商GPU执行推理,把生成结果返回。
OpenAI兼容接口已经成为行业事实标准,DeepSeek、通义千问、智谱、豆包等绝大多数国内大模型都兼容这套SDK,只需要更换
base_url和api_key,业务代码几乎不用改动。
简单伪代码示例
from openai import OpenAI# 切换不同模型,只改base_url、api_key、model名称
client = OpenAI(
api_key="你的密钥",
base_url="模型服务地址"
)resp = client.chat.completions.create(
model="模型名称",
messages=[
{"role":"system","content":"你是专业数据分析助手"},
{"role":"user","content":"帮我总结这段文本"}
],
stream=True # 开启流式逐字返回
)
# 循环读取流式返回结果
for chunk in resp:
print(chunk.choices[0].delta.content, end="")
stream=True流式:像ChatGPT一样,一字字返回,用户体验好;stream=False非流式:全部生成完成后一次性返回。
六、常见关键参数
- temperature温度:控制随机性。数值越高,创意发散越强;越低输出越确定保守。写代码、数据分析建议调低;写故事创作可以调高。
- max_tokens:限制模型最多能输出多少token,防止无限生成。
- top‑p / top‑k:控制候选词采样范围,用来平衡创造力和稳定性。
七、LLM和Agent的关系总结
- LLM只是组件之一,不等于完整Agent。LLM负责思考推理;记忆、工具调用、任务循环规划属于上层系统。
- LLM能力决定了Agent的天花板,如果大模型推理差,再好的Agent框架也救不了。
- Agent可以弥补LLM天生短板:通过工具解决实时信息、复杂计算;通过RAG降低幻觉;通过记忆保存会话信息。
开发启示:选型Agent项目,不能只看框架好不好,底层大模型的推理、工具调用能力同样至关重要。
写在最后
大语言模型依靠统计规律模拟人类语言,不是真正拥有智慧。它擅长理解文本、推理、生成内容,但受限于知识截止、幻觉、没有实操能力。
想要做自动化任务,需要在LLM之上叠加记忆、工具调用、ReAct循环,构建AI Agent;想要构建应用,掌握API调用、提示词工程,是一切开发的基础。
0 条笔记