多元线性回归是线性回归的扩展,同样属于监督学习回归算法。当输入特征不止一个,使用多个特征共同预测连续目标值时,就使用多元线性回归。
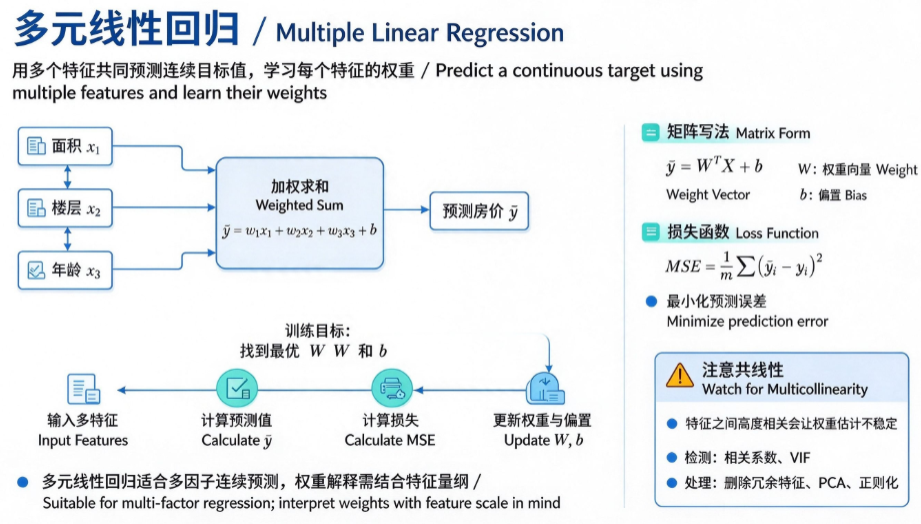
1. 基本公式
一元线性回归:
多元线性回归:
- :不同的输入特征
- :各个特征对应的权重
- :偏置(截距)
- :预测目标值
矩阵写法:
模型学习目标:找到一组权重 和偏置 ,最小化预测值与真实值之间的误差。
2. 损失函数:均方误差 MSE
代表样本数量,最小二乘法依然是求解的基础思路。
3. 核心概念:多重共线性
多元场景独有的重点问题:多重共线性
含义:特征之间存在很强的线性相关(比如同时使用“房屋面积”和“房间总面积”两个高度相关特征)。
带来的问题:
- 权重估计不稳定,微小的数据变化就会让w剧烈波动
- 权重的可解释性下降
- 模型容易难以收敛
检测与解决:
- 计算相关系数、VIF方差膨胀因子
- 删除冗余特征、特征降维(PCA)、正则化
4. 优缺点
✅ 优点
- 可解释性强:每个权重可以理解为“在其他特征不变时,该特征每变化1单位,目标值的平均变化量”
- 训练速度快,计算简单
- 是很多多因子预测模型的基础
❌ 缺点
- 只能拟合线性关系,无法捕捉非线性规律
- 对异常值敏感
- 特征之间容易出现多重共线性问题
- 假设误差服从正态分布
5. Python 代码示例
import numpy as np
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# 构造模拟数据:2个特征,房屋面积、楼层,预测房价
np.random.seed(42)
# 特征:面积、楼层
X = np.array([
    [80, 6], [100, 12], [70, 5], [120, 18], [90, 7],
    [110, 11], [85, 8], [130, 20], [95, 9], [105, 10],
    [75, 4], [115, 14], [88, 6], [125, 16], [98, 8]
])
# 真实房价,构造公式:房价 = 面积*0.8 + 楼层*0.3 + 噪声
y = X[:,0] * 0.8 + X[:,1] * 0.3 + np.random.normal(0, 2, size=len(X))

# 划分训练集、测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 训练多元线性回归模型
model = LinearRegression()
model.fit(X_train, y_train)

# 输出权重与偏置
print(f"面积权重 w1 = {model.coef_[0].item():.2f}")
print(f"楼层权重 w2 = {model.coef_[1].item():.2f}")
print(f"偏置 b = {model.intercept_.item():.2f}")

# 预测与评估
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f"测试集 MSE:{mse:.2f}")
运行结果:
面积权重 w1 = 0.54
楼层权重 w2 = 1.26
偏置 b = 15.61
测试集 MSE:3.19代码说明:model.coef_ 返回数组,依次对应各个特征的权重,使用 .item() 安全取出标量,规避numpy格式化报错。
6. 适用场景
- 多因子房价预测
- 销量预测(广告投入、季节、价格等多个因子)
- 能耗、产量、库存等多变量线性预测
- 数据分析,量化每个因素对结果的影响大小
7. 常见误区
- 权重越大代表这个特征越重要:权重大小受特征量纲影响,需要先做标准化,再对比权重。
- 多个特征效果一定更好:加入无关、冗余特征,会引入噪声,或者带来多重共线性。
- 权重为负数就代表这个特征没用:在其他特征不变的前提下,负权重代表该特征和目标负相关。
思考题
- 什么是多重共线性?它会给多元线性回归带来什么影响?
- 特征的单位不一样,直接对比权重大小是否合理?该怎么处理?
0 条笔记