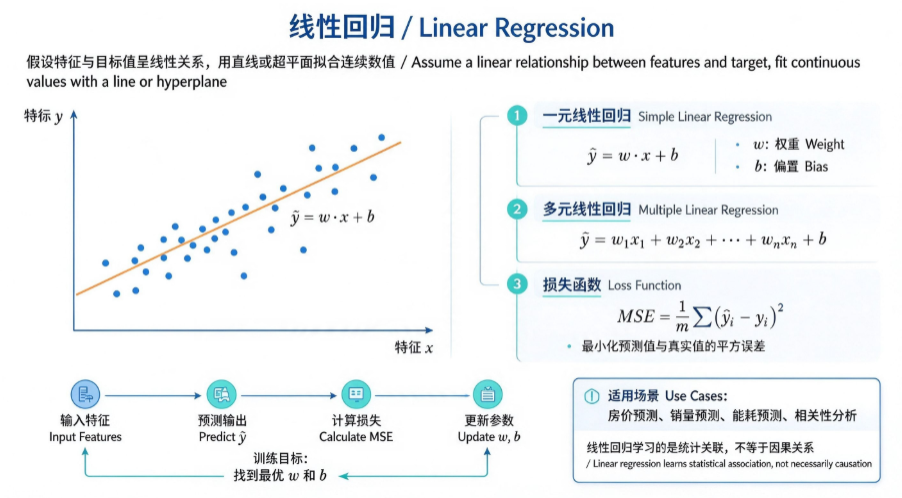
线性回归是最简单、最基础的监督学习回归算法,用来预测连续数值。它假设特征与目标值之间存在线性关系,用一条直线(超平面)拟合数据。
1. 基本公式
一元线性回归(只有1个特征):
- :权重(斜率)
- :偏置(截距)
- :输入特征
- :预测输出
多元线性回归(多个特征):
模型学习的目标,就是找到最合适的 和 ,让预测值和真实值差距最小。
2. 损失函数:均方误差 MSE
是样本数量; 为预测值, 为真实值。
线性回归默认使用最小二乘法,最小化均方误差。
3. 适用条件
- 特征和标签大致呈线性相关
- 误差服从正态分布
- 特征之间不要高度共线性(多重共线性会影响结果)
4. 优缺点
✅ 优点
- 简单、可解释性强,能直观看到每个特征对结果的影响
- 训练速度快,计算成本低
- 是很多进阶算法的基础
❌ 缺点
- 只能拟合线性关系,无法处理非线性数据
- 对异常值非常敏感
- 特征高度共线性时效果变差
5. Python 代码示例
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# 构造模拟数据
np.random.seed(42)
x = np.linspace(1, 10, 50).reshape(-1, 1)
y = 2.5 * x + 4 + np.random.normal(0, 1.2, size=x.shape)

# 划分训练集、测试集
X_train, X_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=42)

# 训练线性回归模型
model = LinearRegression()
model.fit(X_train, y_train)

# 输出学到的参数
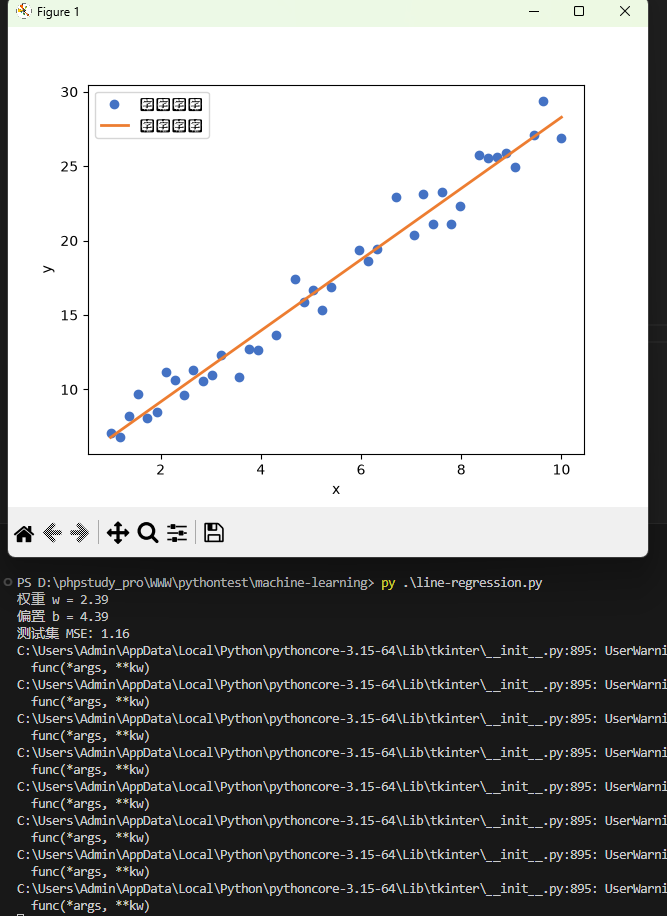
print(f"权重 w = {model.coef_[0]:.2f}")
print(f"偏置 b = {model.intercept_:.2f}")

# 预测
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f"测试集 MSE:{mse:.2f}")

# 绘图
plt.scatter(X_train, y_train, c="#4472c4", label="训练样本")
plt.plot(x, model.predict(x), c="#ed7d31", lw=2, label="拟合直线")
plt.xlabel("x")
plt.ylabel("y")
plt.legend()
plt.show()
执行结果(这里缺少字体):
6. 常见使用场景
- 房价预测
- 销量、营收预测
- 温度、能耗预测
- 相关性分析(看特征影响大小)
7. 常见误区
- 线性回归 ≠ 只能画直线:多元线性回归是高维超平面。
- 相关不等于因果:模型学到的是统计关联,不代表因果关系。
- MSE很小就一定好:需要同时看训练集、测试集误差,警惕过拟合。
思考题
- 如果数据明显是曲线趋势,直接用线性回归会出现什么问题?
- 数据里存在极端异常值,怎么降低对线性回归的影响?
0 条笔记