1. 什么是偏差与方差
偏差(Bias):模型预测平均值和真实值之间的差距,反映模型拟合能力本身。
- 高偏差:模型太简单,抓不住数据底层规律。
- 低偏差:模型足够复杂,可以贴近训练数据。
方差(Variance):在不同训练数据集上训练出来的模型,预测结果之间的波动程度,反映模型对数据噪声的敏感程度。
- 高方差:模型跟着训练集里的随机噪声变化,换一组数据结果差异很大。
- 低方差:模型输出稳定,不容易被少量样本扰动。
机器学习的核心目标,就是平衡偏差和方差,找到泛化能力最好的模型。
泛化能力:模型在 没见过的新数据(测试集) 上的预测效果。
2. 欠拟合(Underfitting)
欠拟合 = 高偏差、低方差
模型过于简单,连训练数据的基本模式都没有学习到。
特征:
- 训练集误差很高
- 测试集误差也很高
- 训练误差和测试误差差距不大
例子:用一条直线去拟合明显非线性的曲线数据。
解决办法:
- 使用更复杂的模型
- 增加特征、构造新特征
- 减少正则化强度
3. 过拟合(Overfitting)
过拟合 = 低偏差、高方差
模型太复杂,不仅学到数据规律,还把训练集里的噪声、随机误差当成规律记住了。
特征:
- 训练集误差很低
- 测试集误差很高
- 训练误差远小于测试误差
例子:高阶多项式,把每一个样本点都穿过,曲线弯弯曲曲。
解决办法:
- 增加训练样本数量
- 正则化(L1、L2正则、Dropout)
- 简化模型,减少特征
- 早停(Early Stopping)
- 数据增强
4. 理想拟合(Good Fit)
理想拟合:偏差、方差都比较小。
训练误差低,测试误差同样低,两者差距很小,模型具备良好泛化能力。
5. 偏差方差权衡(Bias-Variance Tradeoff)
模型复杂度变化时的规律:
- 模型简单 → 偏差↑,方差↓
- 模型复杂 → 偏差↓,方差↑
不存在同时无限降低偏差和方差的办法,我们只能寻找平衡点。
6. 代码示例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error

# 生成模拟数据
np.random.seed(42)
x = np.linspace(0, 1, 30).reshape(-1,1)
y = np.sin(2 * np.pi * x) + np.random.normal(0, 0.15, size=x.shape)
x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.3, random_state=42)

def fit_and_plot(degree):
    poly = PolynomialFeatures(degree=degree)
    x_train_p = poly.fit_transform(x_train)
    x_test_p = poly.transform(x_test)
    model = LinearRegression()
    model.fit(x_train_p, y_train)
    y_pred_train = model.predict(x_train_p)
    y_pred_test = model.predict(x_test_p)
    train_loss = mean_squared_error(y_train, y_pred_train)
    test_loss = mean_squared_error(y_test, y_pred_test)
    print(f"阶数:{degree} | 训练MSE:{train_loss:.4f} | 测试MSE:{test_loss:.4f}")
    x_line = np.linspace(0,1,100).reshape(-1,1)
    y_line = model.predict(poly.transform(x_line))
    plt.scatter(x_train,y_train,c="blue",label="train")
    plt.scatter(x_test,y_test,c="orange",label="test")
    plt.plot(x_line,y_line,"r-")
    plt.title(f"Polynomial degree {degree}")
    plt.legend()
    plt.show()

# 欠拟合(1阶)
fit_and_plot(1)
# 合适拟合(3阶)
fit_and_plot(3)
# 过拟合(10阶)
fit_and_plot(10)
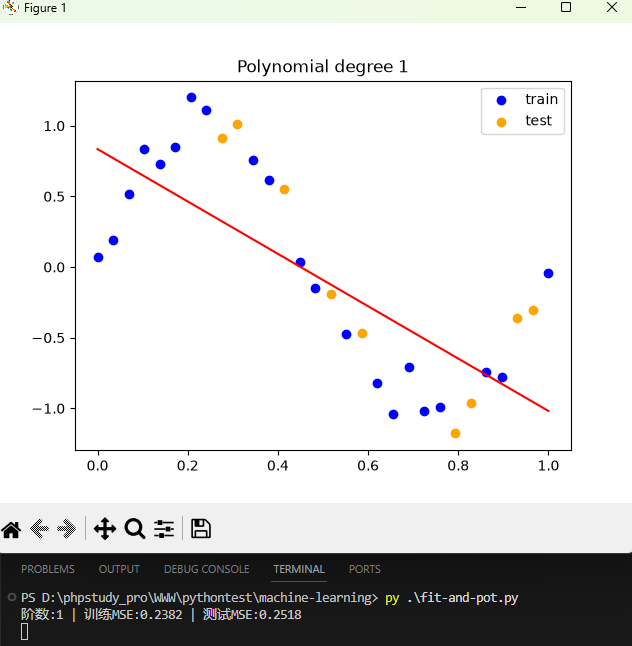
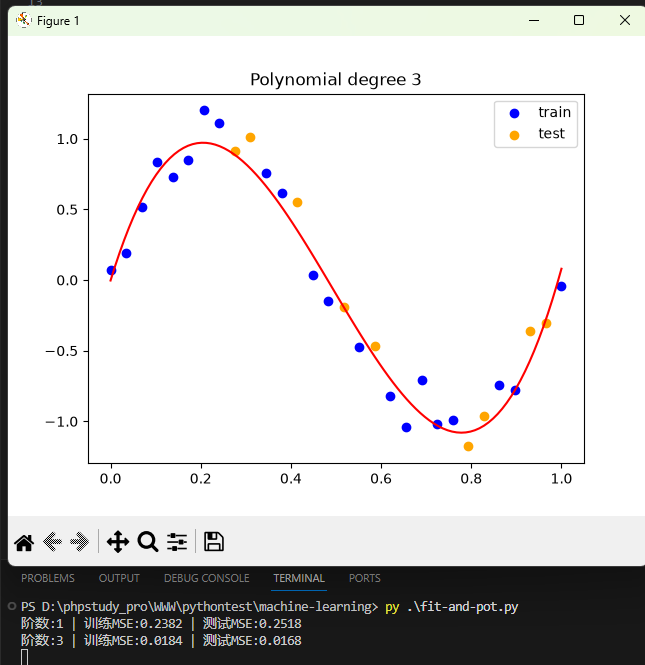
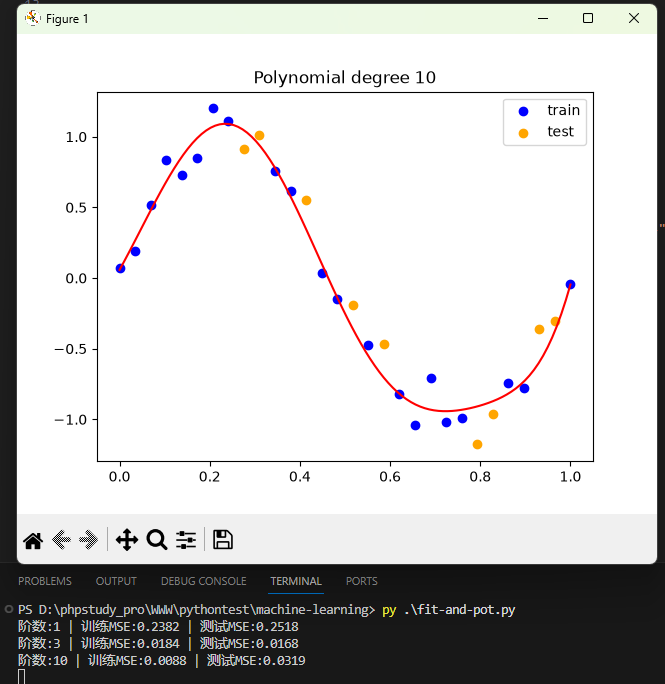
运行结果说明:
- 1阶多项式:训练、测试误差都很高 → 欠拟合
- 3阶多项式:训练和测试误差都比较低 → 拟合良好
- 10阶多项式:训练误差极低,测试误差飙升 → 过拟合
7. 常见误区
- 训练准确率高就等于模型好:不一定,很可能是过拟合。
- 过拟合就是模型参数太多:参数多是诱因,本质是噪声被学习。
- 正则化是用来降低偏差:正则化是用来抑制方差,防止过拟合。
思考题
- 如果你的模型训练误差很低,测试误差很高,属于什么问题?可以用哪些手段优化?
- 收集更多数据,一般对高偏差还是高方差问题更有效?
0 条笔记