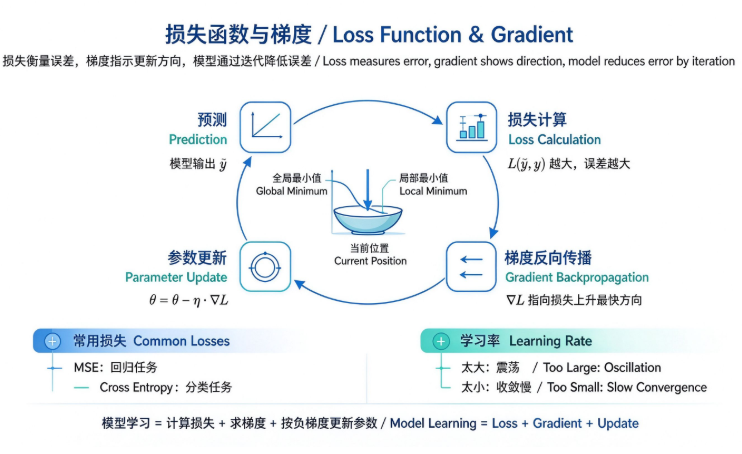
损失函数用来衡量模型预测结果和真实标签之间差距有多大;梯度告诉我们参数应该往哪个方向调整,才能缩小这个差距。损失函数是误差标尺,梯度是优化方向,二者是模型自动学习更新参数的核心。
一、损失函数(Loss Function)
模型输出预测值 ,真实标签是 ,损失函数 输入预测和真实值,输出一个代表误差大小的数字。损失越大,代表模型预测越不准;训练的目标,就是不断降低损失。
常用损失函数
- 均方误差 MSE(Mean Squared Error)
适合回归任务。
对误差做平方,放大较大误差。
- 交叉熵损失 Cross Entropy
适合分类任务(逻辑回归、神经网络),衡量预测概率分布和真实分布之间的距离,也是我们前面二分类任务常用的损失。
要点:损失函数必须可导,才能计算梯度。不可导的损失无法用梯度下降优化。
二、梯度(Gradient)
梯度就是损失函数对模型参数的偏导数组合。梯度指向损失上升最快的方向。
所以我们更新参数时,要向梯度的反方向走,让损失变小,这个算法就是梯度下降。
参数更新公式:
- :模型参数(权重w、偏置b)
- :学习率 learning rate,控制每一步走多大
- :损失函数的梯度
学习率的影响
- 学习率太大:步子迈太大,来回震荡,无法收敛,损失不降反升
- 学习率太小:更新极慢,训练耗时很久,容易困在局部最小值
三、完整训练循环(核心流程)
- 输入样本,模型正向传播,得到预测值
- 使用损失函数,计算当前损失
- 反向传播,计算损失对各个参数的梯度
- 沿着负梯度方向更新参数
- 重复迭代,直到损失稳定不再下降
配套代码示例(沿用统一 data.csv)
Age,Salary,Purchased
25,40000,0
45,80000,1
30,50000,0
48,,1
22,32000,0
35,60000,1
,55000,0
50,90000,1
29,43000,0
55,100000,1
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import log_loss

# 读取、清洗数据
df = pd.read_csv("data.csv")
df['Age'].fillna(df['Age'].mean(), inplace=True)
df['Salary'].fillna(df['Salary'].mean(), inplace=True)

X = df[['Age','Salary']]
y = df['Purchased']

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

# 逻辑回归,内部使用交叉熵损失、梯度下降优化
model = LogisticRegression()
model.fit(X_train, y_train)

# 计算交叉熵损失
y_pred_prob = model.predict_proba(X_train)
loss = log_loss(y_train, y_pred_prob)
print(f"训练集交叉熵损失:{loss:.4f}")
局部最小值 vs 全局最小值
损失函数的曲面可能凹凸不平,存在多个低谷:
- 全局最小值:整个曲面上损失最低的位置,是我们想要的最优参数
- 局部最小值:某一小块区域的低点,但不是全局最低
梯度下降只能看到当前位置的坡度,有可能停在局部最小值。深度学习中常用动量、自适应学习率优化器(Adam)缓解这个问题。
常见误区
- 损失越低 ≠ 模型一定越好:训练损失很低、测试损失很高,就是过拟合
- 学习率不是越大收敛越快,过大容易震荡不收敛
- 梯度不是用来直接修改参数,梯度只是方向,还需要学习率控制步长
小结
损失函数定义“我们要优化什么目标”,梯度给出“怎么调整参数”。所有基于梯度的模型,逻辑回归、SVM、神经网络,底层都是这套思路。理解损失和梯度,就看懂了模型“学习”的本质。
思考题
- 回归任务一般优先选择什么损失函数?二分类任务呢?
- 如果梯度等于0,意味着什么?
0 条笔记