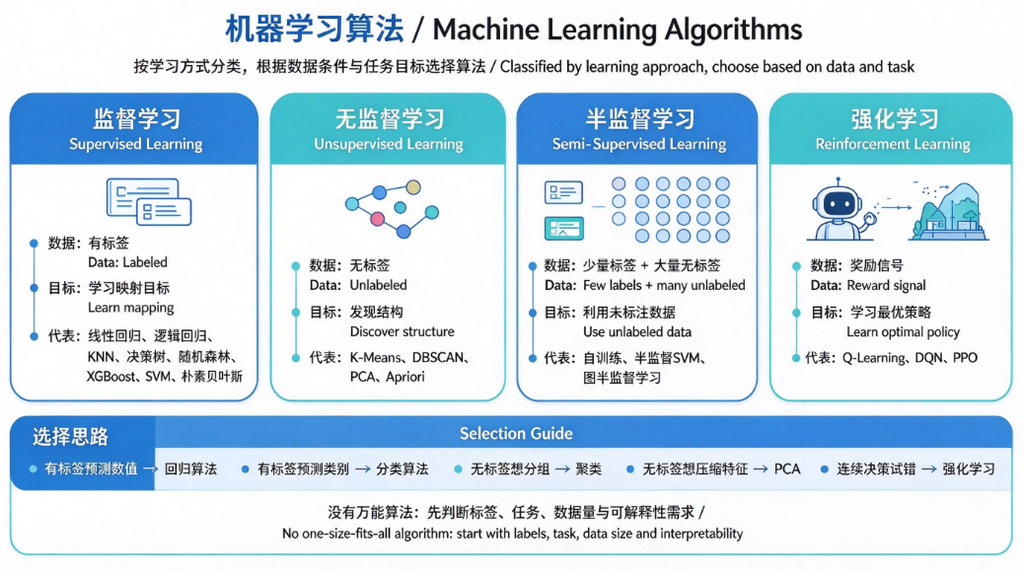
机器学习算法是让模型从数据中学习规律的具体方法。按照学习方式,一般分为监督学习、无监督学习、半监督学习、强化学习四大类,不同类别对应不同的数据条件与任务目标。
1. 监督学习算法
数据带有标签(输入+已知结果),模型学习输入到标签的映射关系,分为回归(预测连续数值)和分类(预测类别)。
| 算法 | 任务 | 简要说明 | 典型场景 |
|---|---|---|---|
| 线性回归 | 回归 | 假设特征和目标呈线性关系 | 房价预测、销量预测 |
| 逻辑回归 | 二分类 | 线性输出经过sigmoid转为概率 | 风控、垃圾邮件判断 |
| K近邻 KNN | 分类/回归 | 找距离最近的K个样本投票 | 简单图像识别、小样本分类 |
| 决策树 | 分类/回归 | 树状分支做判断,可输出特征重要性 | 风控规则、多因子分析 |
| 随机森林 | 分类/回归 | 多棵决策树集成,降低过拟合 | 表格数据预测、特征筛选 |
| XGBoost / LightGBM | 分类/回归 | 梯度提升树,依次拟合残差 | 竞赛、点击率预测 |
| 朴素贝叶斯 | 分类 | 基于贝叶斯公式,假设特征独立 | 文本分类、情感识别 |
| SVM 支持向量机 | 分类 | 寻找最优分隔超平面 | 高维小样本、文本分类 |
2. 无监督学习算法
数据没有标签,算法自动挖掘数据内部结构、分布、关联。
| 算法 | 任务 | 简要说明 | 典型场景 |
|---|---|---|---|
| K-Means | 聚类 | 把数据分成K个簇,按距离分组 | 用户分群、商品聚类 |
| DBSCAN | 聚类 | 基于密度聚类,自动识别离群点 | 异常检测、空间点聚类 |
| PCA主成分分析 | 降维 | 压缩特征,保留主要信息 | 特征压缩、可视化 |
| 关联规则(Apriori、FP-Growth) | 关联挖掘 | 找出经常一起出现的项目 | 购物篮分析、推荐 |
3. 半监督学习算法
少量带标签数据 + 大量无标签数据,适合标注成本很高的场景。
常见思路:先用无监督方式学习数据分布,再用少量标签微调模型。
典型场景:语音识别、图片分类。
4. 强化学习算法
没有固定标签,智能体(Agent)和环境交互,通过奖励Reward来学习最优决策策略。
核心循环:观察状态 → 执行动作 → 获得奖励 → 更新策略。
代表算法:Q-Learning、DQN、PPO。
典型场景:游戏AI、机器人控制、自动驾驶调度。
5. 通用选择思路
- 有标签、预测数值:线性回归、XGBoost
- 有标签、分类:逻辑回归、随机森林、LightGBM
- 无标签,想分组:K-Means
- 无标签,想压缩特征:PCA
- 连续决策、试错优化:强化学习
- 文本类任务:朴素贝叶斯、深度学习
没有万能算法,优先根据标签是否存在、数据量、特征类型、是否需要可解释性选择。
代码示例(多算法对比)
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.cluster import KMeans
from sklearn.metrics import accuracy_score

# 生成模拟分类数据
X, y = make_classification(n_samples=200, n_features=5, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# 监督:逻辑回归
lr = LogisticRegression()
lr.fit(X_train, y_train)
print("逻辑回归准确率:", accuracy_score(y_test, lr.predict(X_test)))

# 监督:随机森林
rf = RandomForestClassifier(n_estimators=50, random_state=42)
rf.fit(X_train, y_train)
print("随机森林准确率:", accuracy_score(y_test, rf.predict(X_test)))

# 无监督:KMeans聚类(不使用标签)
kmeans = KMeans(n_clusters=2, random_state=42, n_init="auto")
cluster_label = kmeans.fit_predict(X)
print("KMeans前10个聚类标签:", cluster_label[:10])
运行结果:
逻辑回归准确率: 0.8666666666666667
随机森林准确率: 0.8666666666666667
KMeans前10个聚类标签: [0 0 0 1 1 0 0 1 1 0]
常见误区
- 复杂算法一定更好:小数据集上,简单的逻辑回归、KNN效果可能更强,同时更容易解释。
- 集成算法不会过拟合:XGBoost、随机森林同样会过拟合,需要调参、正则、早停。
- 聚类算法一定能分出有意义的组:K-Means必须合理选择K,数据分布不合适时聚类结果没有价值。
思考题
- 当你拿到一批没有任何标签的用户数据,想做用户分群,应该优先选哪一类算法?
- 同样是表格预测任务,随机森林相比逻辑回归,最大优势是什么?
0 条笔记