概率思维,核心是学会在不确定性下思考。机器学习面对的现实世界几乎都不是绝对确定的,模型很少直接给出“一定是A、一定是B”的结论,而是输出可能性。概率思维就是用概率描述不确定、用新数据持续更新判断,是理解分类模型、朴素贝叶斯、最大似然的底层思想。
什么是概率思维
传统确定性思维:条件满足 → 结果一定发生。
概率思维:根据现有证据,估计结果发生的可能性;当拿到新数据,再修正这个可能性。
机器学习模型本质就是概率模型:它不追求百分百猜对,而是学习事件发生的概率分布。
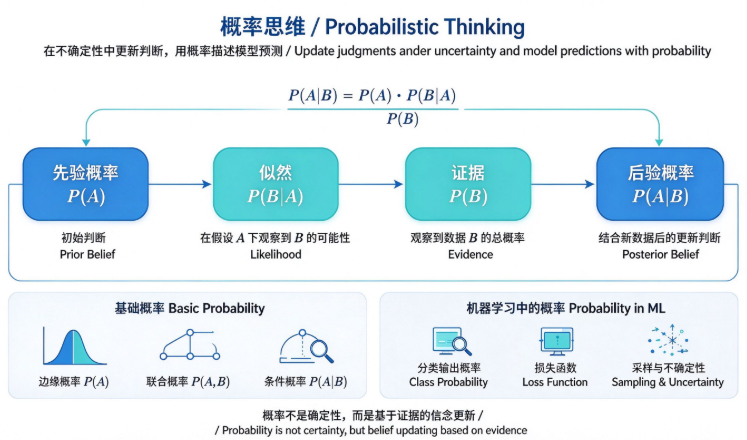
基础概率概念
1. 边缘概率 (P(A))
单独一件事发生的概率,不附加其他条件。
示例:随机抽取一个用户,购买商品的概率 。
2. 联合概率 P(A,B)
多个事件同时发生的概率。
示例:年龄35岁 并且 薪资60000,并且购买商品的概率。
3. 条件概率 P(A|B)
在B已经发生的前提下,A发生的概率。
示例:已知用户年龄35岁,他购买商品的概率 。
公式:
4. 独立事件
如果 ,说明B的发生不影响A,两个事件相互独立。朴素贝叶斯算法就强假设特征之间相互独立。
贝叶斯定理(概率思维的核心)
- :先验概率,看到数据之前,凭经验得到的初始判断
- :似然,假设A成立时,观察到B数据的可能性
- :证据概率,所有情况下观察到B的总概率
- :后验概率,拿到新证据B之后,更新得到的新判断
一句话理解:先用经验猜一个初始概率,再用新数据修正猜测。
套入我们数据集例子:
A = 用户会购买,B = 用户年龄、薪资特征。
模型目标:根据年龄薪资(证据B),求 。
最大似然估计
最大似然是另一种经典概率思路:固定观测到的数据,反过来寻找一组模型参数,让当前这批数据出现的可能性最大。
线性回归、逻辑回归的训练过程,底层大多是最大化似然。
简单理解:找一套参数,使得我们手上这份数据集最合理。
概率在机器学习中的典型应用
- 分类模型输出概率:逻辑回归输出 0.8,代表该样本属于正类的概率为80%
- 朴素贝叶斯分类器:直接基于贝叶斯定理做预测
- 损失函数:交叉熵,本质衡量预测概率分布和真实分布之间的差距
- 采样、随机初始化、随机森林、dropout,都建立在随机与概率基础上
- 置信区间、模型不确定性评估
配套代码示例(沿用统一 data.csv)
Age,Salary,Purchased
25,40000,0
45,80000,1
30,50000,0
48,,1
22,32000,0
35,60000,1
,55000,0
50,90000,1
29,43000,0
55,100000,1
import pandas as pd

df = pd.read_csv("data.csv")
df['Age'].fillna(df['Age'].mean(), inplace=True)
df['Salary'].fillna(df['Salary'].mean(), inplace=True)

# 先验概率:购买的概率
p_purchase = df["Purchased"].mean()
print(f"先验概率 P(购买) = {p_purchase:.2f}")

# 条件概率:Age >= 40 的用户中,购买的概率
cond = df[df["Age"] >= 40]
p_purchase_gte40 = cond["Purchased"].mean()
print(f"条件概率 P(购买|年龄>=40) = {p_purchase_gte40:.2f}")
概率思维容易踩坑的误区
- 混淆条件概率: 和 完全不是一回事
- 忽略先验:只看证据,不考虑事件本身发生的基础概率(基础率谬误)
- 把高概率当成确定事实:概率90%依然存在10%反例
- 假设独立:强行认为特征互不相关,忽略特征之间的关联
小结
概率思维教会我们接受不确定性。模型给出的不是标准答案,是基于历史数据计算出来的信念。贝叶斯框架提供了一套标准化的更新规则:先有预判,见到新数据,再调整预判。很多机器学习算法,本质上就是一套概率推理机器。
思考题
- 逻辑回归输出0.9,是不是代表这个预测一定正确?
- 和 哪一个是我们关心的后验概率?
0 条笔记