Python 是机器学习领域最主流的编程语言。它拥有丰富的科学计算库,代码简洁易读,上手门槛低,绝大多数机器学习项目都使用 Python 开发。
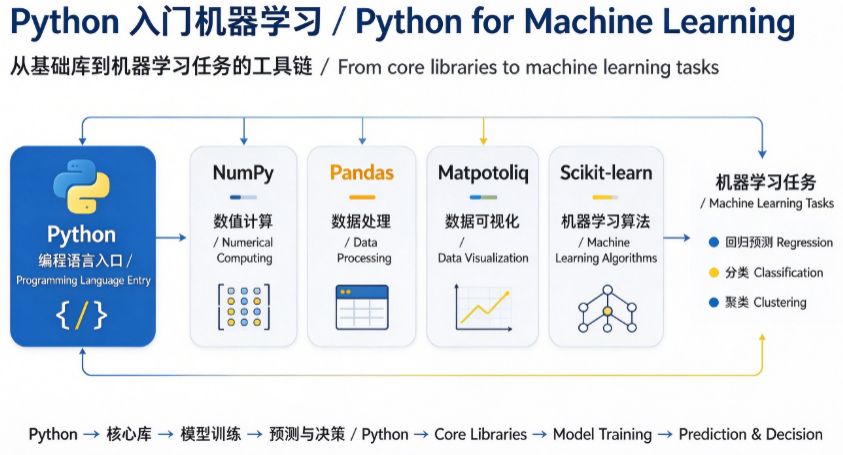
1. 机器学习常用 Python 库
入门阶段优先掌握下面4个核心库:
- NumPy:数值计算库,用于矩阵、数组运算,机器学习底层计算基础。
- Pandas:数据处理库,用来读取、清洗、查看表格数据(结构化数据集)。
- Matplotlib:可视化库,绘制折线图、散点图,查看数据分布、展示结果。
- Scikit-learn:经典机器学习算法库,封装了线性回归、分类、聚类、数据划分等全套工具,适合入门。
本教程实战案例全部基于
scikit-learn,不需要手写复杂算法。
2. 环境安装
使用 pip 一键安装依赖包:
pip install numpy pandas matplotlib scikit-learn
安装完成后,在 Python 中导入验证:
import numpy
import pandas
import matplotlib
import sklearn

print("numpy版本:", numpy.__version__)
print("pandas版本:", pandas.__version__)
print("matplotlib版本:", matplotlib.__version__)
print("scikit-learn版本:", sklearn.__version__)
3. 完整入门实战:线性回归预测
我们用线性回归,根据房屋面积预测房价,完整流程:加载数据 → 数据准备 → 划分训练集测试集 → 训练模型 → 预测 → 可视化。
# 导入所需库
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

# 1. 构造数据集
data = {
    "area": [60, 70, 80, 90, 100, 110, 120, 130, 140, 150],
    "price": [120, 140, 160, 185, 200, 220, 245, 260, 280, 305]
}
df = pd.DataFrame(data)

# 2. 提取特征X和标签y
X = df[["area"]]  # 特征:房屋面积(二维格式)
y = df["price"]   # 标签:房价

# 3. 划分训练集、测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 4. 创建模型并训练
model = LinearRegression()
model.fit(X_train, y_train)

# 查看模型学到的参数
print(f"系数 w:{model.coef_[0]}")
print(f"截距 b:{model.intercept_}")

# 5. 使用模型预测
y_pred = model.predict(X_test)
print("真实房价:", y_test.values)
print("预测房价:", y_pred)

# 6. 评估模型:均方误差
mse = mean_squared_error(y_test, y_pred)
print(f"均方误差 MSE:{mse:.2f}")

# 7. 可视化结果
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.scatter(X_train, y_train, color="blue", label="训练数据")
plt.scatter(X_test, y_test, color="orange", label="测试数据")
plt.plot(X, model.predict(X), color="red", label="拟合直线")
plt.xlabel("房屋面积(㎡)")
plt.ylabel("房价(万元)")
plt.legend()
plt.show()
代码要点说明
train_test_split:自动拆分训练集与测试集,test_size=0.2代表20%数据作为测试集;random_state固定随机种子,保证每次运行结果一致。LinearRegression():创建线性回归模型。model.fit(X_train,y_train):训练模型,模型从训练数据学习规律。model.predict():推理预测,输入特征,输出预测结果。mean_squared_error:回归任务评估指标,误差越小代表模型效果越好。
⚠️ 常见踩坑:matplotlib 图表不显示
- Jupyter:增加魔法命令
%matplotlib inline- VSCode:确认安装ipykernel;服务器环境可注释
plt.show(),改用plt.savefig("result.png")保存图片。
4. 机器学习项目标准Python工作流程
- 导入库:引入numpy、pandas、算法模型等
- 加载&清洗数据:读取csv,处理缺失值、异常值
- 准备特征与标签:分离X(特征)、y(标签)
- 数据集划分:训练集、测试集
- 创建模型:实例化算法
- 模型训练 fit()
- 预测 predict()
- 模型评估
- 可视化 / 保存模型
5. 模型保存与加载(拓展)
训练好的模型可以保存到本地,不用每次重新训练:
import joblib

# 保存模型
joblib.dump(model, "house_price_model.pkl")

# 加载模型
loaded_model = joblib.load("house_price_model.pkl")

# 使用加载后的模型做新预测
new_area = pd.DataFrame([[105]], columns=["area"])
result = loaded_model.predict(new_area)
print(f"面积105㎡的预测房价:{result[0]:.2f} 万元")
本章小结
- Python机器学习核心四大库:NumPy、Pandas、Matplotlib、Scikit-learn。
fit()训练模型;predict()用来预测。- 数据集需要拆分训练集、测试集,用来评估泛化能力。
- 训练后的模型可以通过 joblib 持久化保存,重复使用。
- 完整项目链路:数据准备 → 划分数据集 → 训练 → 预测 → 评估。
思考题
- scikit-learn库的作用是什么?
- fit() 和 predict() 分别在哪个阶段使用?
- 训练完成后如何保存模型,好处是什么?
0 条笔记