随机森林(Random Forest)属于Bagging集成学习,以决策树为基础学习器,通过多棵独立决策树投票得到预测结果,是工业界非常常用的模型。
1. 基本原理
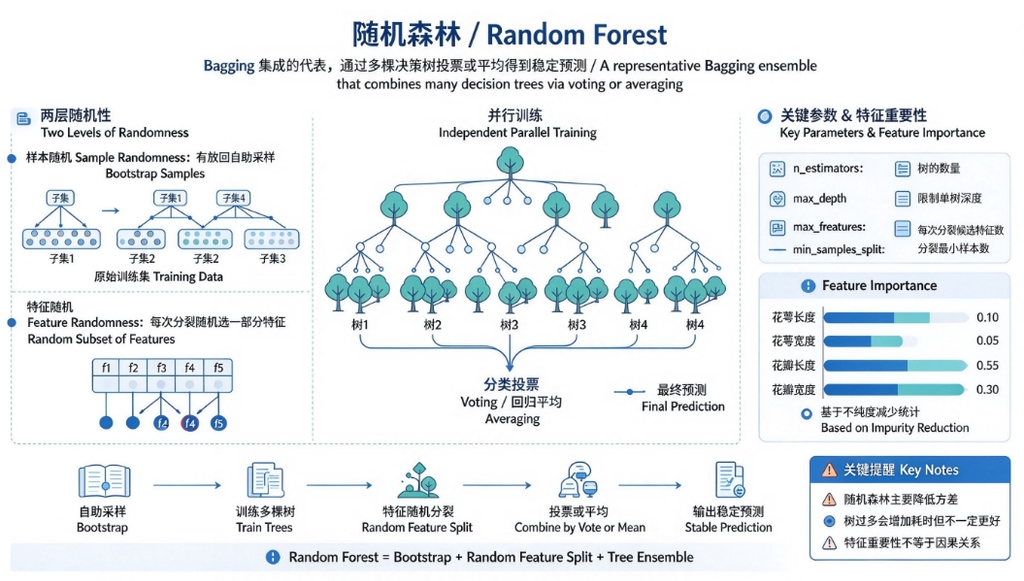
随机森林有两层随机,也是它和普通Bagging最核心的区别:
- 样本随机:对原始数据集做有放回自助采样(Bootstrap),每一棵树拿到不一样的训练样本子集。
- 特征随机:每一次节点分裂时,只从全部特征里随机挑选一部分特征来寻找最优分裂条件。
训练流程:
- 并行训练多棵决策树,树与树之间独立;
- 分类任务:所有树预测结果投票,票数最多的类别作为最终结果;
- 回归任务:所有树预测值取平均值作为最终结果。
两层随机降低树和树之间的相关性,减少整体方差,抑制单棵决策树容易过拟合的问题。
2. 重要参数
n_estimators:树的数量,树越多,效果越稳定,但训练和推理速度变慢;到达一定数量后,提升很小。max_depth:单棵树最大深度,用来限制单树过拟合。max_features:每次分裂随机选取的特征数量。min_samples_split:节点继续分裂所需的最小样本数。
3. 特征重要性
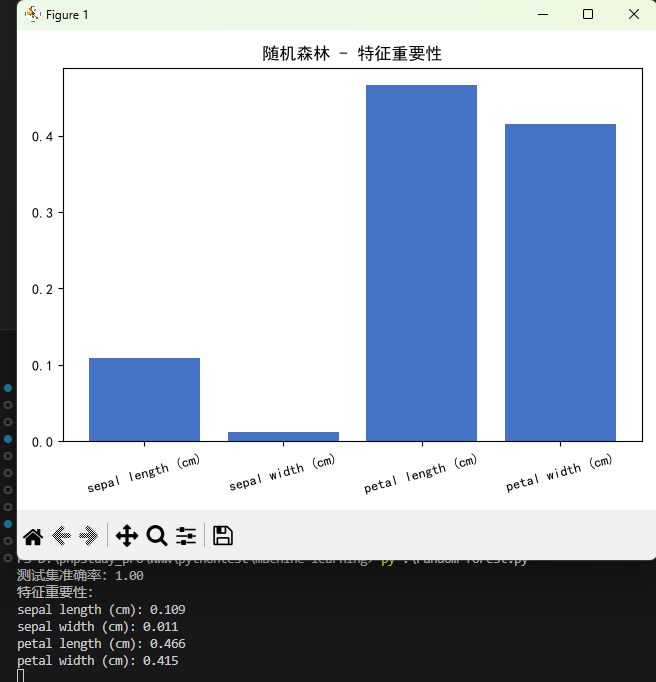
随机森林可以直接输出特征重要度,用来辅助特征筛选:
- 原理:统计某个特征在所有树的分裂中,减少的不纯度(基尼/熵)总和;
- 注意:仅代表对模型划分有用,不等于业务上的因果关系。
4. 优缺点
✅ 优点
- 继承决策树的优势:不需要特征归一化,能同时处理连续、离散特征
- 抗过拟合能力远强于单决策树
- 天然支持并行训练,训练速度不错
- 自带特征重要性输出,方便做特征工程
- 对异常值、噪声鲁棒性较好
❌ 缺点
- 模型可解释性变差,多棵树组合很难像单决策树一样读出清晰规则
- 对超高维稀疏数据(如长文本)效果一般
- 处理回归任务时,预测输出不能超过训练集标签的取值范围
5. Python 代码示例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 加载数据集
data = load_iris()
X = data.data
y = data.target
feature_names = data.feature_names

# 划分训练集、测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 构建随机森林
model = RandomForestClassifier(n_estimators=50, max_depth=3, random_state=42)
model.fit(X_train, y_train)

# 预测评估
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
print(f"测试集准确率:{acc:.2f}")

# 输出特征重要性
print("特征重要性:")
for name, score in zip(feature_names, model.feature_importances_):
    print(f"{name}: {score:.3f}")

# 绘制特征重要性柱状图
plt.bar(feature_names, model.feature_importances_, color="#4472c4")
plt.xticks(rotation=15)
plt.title("随机森林 - 特征重要性")
plt.tight_layout()
plt.show()
结果:
6. 适用场景
- 结构化表格数据:风控、用户画像、销量预测
- 需要快速拿到特征重要性,做特征筛选
- 作为机器学习基线模型,对比其他算法效果
7. 常见误区
- 树越多效果一定越好:n_estimators 超过阈值后,精度不再提升,只会增加耗时
- 随机森林不会过拟合:单棵树深度过大、树数量很多时依然会过拟合
- 特征重要性高就是业务上最重要的变量:只代表对模型划分有帮助,不代表因果
思考题
- 随机森林为什么要同时做样本随机和特征随机?
- 随机森林属于Bagging,它主要降低偏差还是方差?
0 条笔记