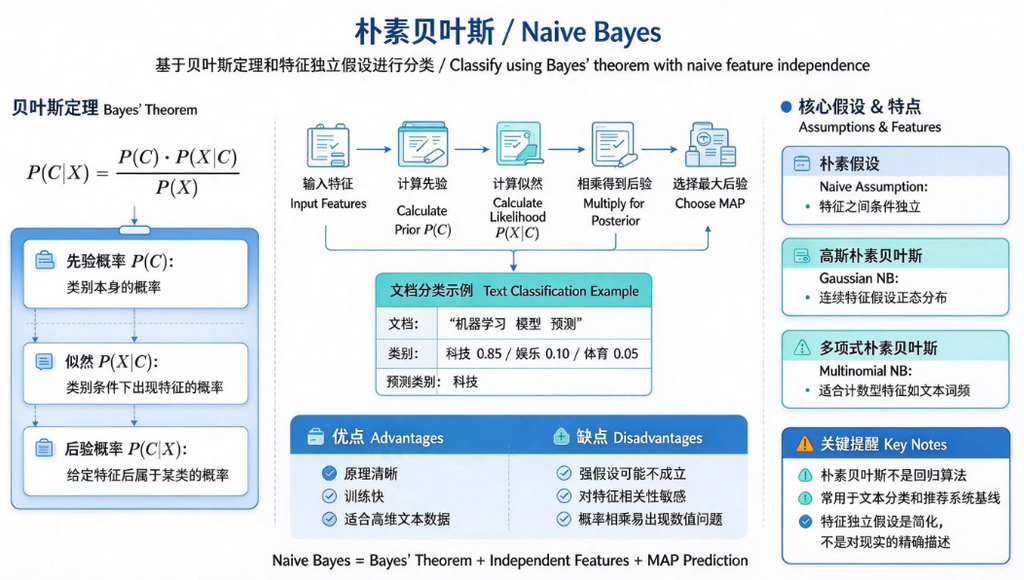
朴素贝叶斯(Naive Bayes)是基于贝叶斯定理的监督分类算法,“朴素”来自它的核心假设:各个特征之间相互独立。算法简单、训练速度极快,常用于文本分类。
1. 基本原理
贝叶斯公式:
- :先验概率,类别Y在数据集中出现的概率
- :似然,在类别Y下,特征X出现的概率
- :后验概率,已知特征X时,样本属于类别Y的概率
- :证据因子,对所有类别是同一个值,比较时可以忽略
朴素假设:给定类别Y,所有特征互相独立
预测规则:计算每个类别的后验概率,选择后验概率最大的类别作为输出。
2. 三种常用朴素贝叶斯变种
- 高斯朴素贝叶斯(GaussianNB):特征是连续数值,假设特征服从高斯正态分布
- 多项式朴素贝叶斯(MultinomialNB):离散计数特征,最常用于文本词频、TF-IDF
- 伯努利朴素贝叶斯(BernoulliNB):二值特征(0/1),代表特征是否出现
3. 优缺点
✅ 优点
- 训练、预测速度非常快,适合高维数据
- 占用内存小,实现简单
- 对缺失数据不敏感
- 多分类任务原生支持
❌ 缺点
- 特征独立假设在现实中大多不成立,这是它最大的短板
- 对零概率问题敏感(平滑处理可以缓解)
- 连续特征分布假设如果不匹配,效果下降明显
- 相比树模型、SVM,整体精度上限偏低
零概率问题:某个特征在某个类别下从来没有出现过,概率为0,会让整个乘积变成0;使用拉普拉斯平滑解决。
4. Python 代码示例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.metrics import accuracy_score

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 生成数据集
np.random.seed(42)
X, y = make_classification(n_samples=120, n_features=2, n_informative=2, n_redundant=0, random_state=42)

# 划分训练集、测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 高斯朴素贝叶斯
model = GaussianNB()
model.fit(X_train, y_train)

# 预测评估
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
print(f"测试集准确率:{acc:.2f}")

# 绘制决策边界
def plot_decision_boundary(clf, X, y):
    x_min, x_max = X[:,0].min()-1, X[:,0].max()+1
    y_min, y_max = X[:,1].min()-1, X[:,1].max()+1
    xx, yy = np.meshgrid(np.linspace(x_min, x_max, 100), np.linspace(y_min, y_max, 100))
    Z = clf.predict(np.c_[xx.ravel(), yy.ravel()])
    Z = Z.reshape(xx.shape)
    plt.contourf(xx, yy, Z, alpha=0.3, cmap='coolwarm')
    plt.scatter(X[:,0], X[:,1], c=y, cmap='coolwarm')
    plt.xlabel("x1")
    plt.ylabel("x2")

plot_decision_boundary(model, X_train, y_train)
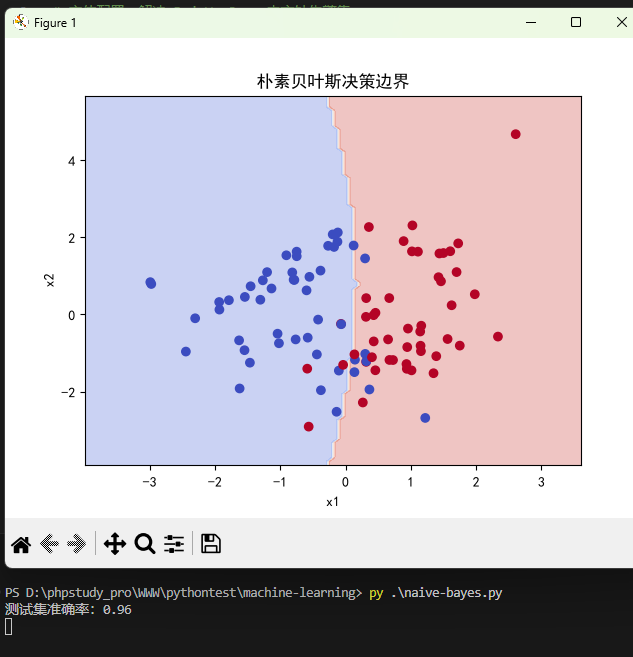
plt.title("朴素贝叶斯决策边界")
plt.show()
运行结果:
5. 适用场景
- 文本分类:垃圾邮件识别、新闻分类、情感分析(MultinomialNB)
- 实时分类场景、海量高维数据
- 简单基准模型,快速验证思路
6. 常见误区
- 朴素贝叶斯要求特征一定独立:只是假设独立,就算不独立也可以跑,只是效果会变差
- 所有朴素贝叶斯都可以用于文本:文本优先用多项式朴素贝叶斯,不要用高斯贝叶斯
- 零概率问题无法解决:拉普拉斯平滑可以给未出现的特征分配一个极小概率
思考题
- “朴素”二字代表什么含义?这个假设会带来什么影响?
- 拉普拉斯平滑的作用是什么?
0 条笔记