强化学习探索vs开采(Exploration vs Exploitation)
探索与开采(也译作利用)是强化学习里最核心的权衡难题。智能体在做决策时,永远面临两个选择:是尝试新动作,还是沿用当前已知最好的动作。
1. 概念说明
开采 Exploitation:基于已经学到的Q值,选择当前看起来收益最高的动作。
目的:拿到已经发现的稳定奖励,最大化当下回报。
风险:容易陷入局部最优,错过更好的动作。探索 Exploration:随机尝试之前很少做、甚至没做过的动作。
目的:收集未知状态-动作对的信息,挖掘更高回报的策略。
风险:有可能拿到较低奖励,短期收益变差。
核心矛盾:只开采,会局限在已知经验里;只探索,永远学不到稳定最优策略。
2. 经典平衡策略
‑贪心(Epsilon-Greedy)(最常用)
- 以概率 :随机探索,随便选一个动作
- 以概率 :开采,选Q值最大的动作
- 超参 一般随训练衰减:前期大,多探索;后期变小,专注开采。
软最大化策略 Softmax(玻尔兹曼探索)
按照Q值大小分配动作概率,Q越高的动作被选中概率越大,不是简单二选一。适合动作空间不大的场景。
上置信界 UCB(Upper Confidence Bound)
选择“Q均值 + 探索Bonus”最大的动作。给访问次数少的动作增加奖励加成,鼓励去试很少访问的动作。适合多臂老虎机问题。
3. 衰减策略( 衰减)
训练前期:环境陌生,信息少 → 大,多探索
训练中后期:经验充足 → 逐步降低,转向开采
示例:
ε 初始=0.9,每轮乘0.99,下限0.01
防止后期还在大量随机探索,导致模型无法收敛。
4. 优缺点
✅ 探索的价值
- 有机会发现更优的动作
- 避免卡在局部最优
- 收集陌生状态的信息
❌ 探索的代价
- 短期奖励不稳定、偏低
- 训练时间变长
✅ 开采的价值
- 稳定拿到当前已知最优奖励
- 训练后期收敛更快
❌ 开采的代价
- 信息固化,无法发现更好方案
- 容易过拟合到当前有限经验
5. Python 代码示例( 贪心)
import numpy as np
import matplotlib.pyplot as plt

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

np.random.seed(42)
n_actions = 4
Q = np.zeros(n_actions)
action_count = np.zeros(n_actions)

def epsilon_greedy(Q, epsilon):
    if np.random.random() < epsilon:
        # 探索:随机动作
        return np.random.randint(0, n_actions)
    else:
        # 开采:选Q最大
        return np.argmax(Q)

# 模拟\(\varepsilon\)衰减
eps_list = []
reward_list = []
epsilon = 0.9
for step in range(200):
    a = epsilon_greedy(Q, epsilon)
    # 模拟真实奖励:动作3是最优,奖励10,其他动作奖励均值偏低
    true_reward = 10 if a == 3 else np.random.normal(2, 1)
    alpha = 0.1
    Q[a] = Q[a] + alpha * (true_reward - Q[a])
    action_count[a] += 1

    eps_list.append(epsilon)
    reward_list.append(true_reward)

    # \(\varepsilon\)衰减
    epsilon = max(0.01, epsilon * 0.98)

plt.figure(figsize=(10,4))
plt.subplot(1,2,1)
plt.plot(eps_list)
plt.xlabel("步数")
plt.ylabel("\(\varepsilon\)")
plt.title("\(\varepsilon\)衰减曲线")

plt.subplot(1,2,2)
plt.plot(reward_list, alpha=0.6)
plt.xlabel("步数")
plt.ylabel("即时奖励")
plt.title("奖励变化")
plt.tight_layout()
plt.show()

print("最终Q值:", Q)
运行结果:
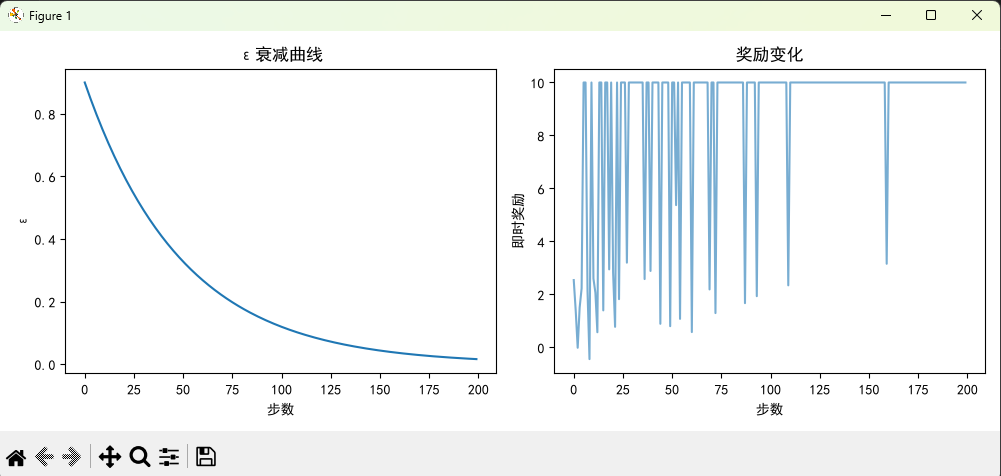
6. 适用场景
- 在线推荐、广告投放(多臂老虎机)
- 游戏AI、机器人控制
- 资源调度、实验调参
7. 常见误区
- 越小越好:前期太小,几乎不探索,很容易学到次优策略
- 探索越多越好:一直高,策略永远震荡,无法稳定
- 衰减固定不变:不同环境需要不同衰减速度,复杂环境需要更长探索期
思考题
- 如果一直固定为1,智能体会发生什么?固定为0呢?
- UCB对比贪心,探索逻辑有什么不一样?
0 条笔记