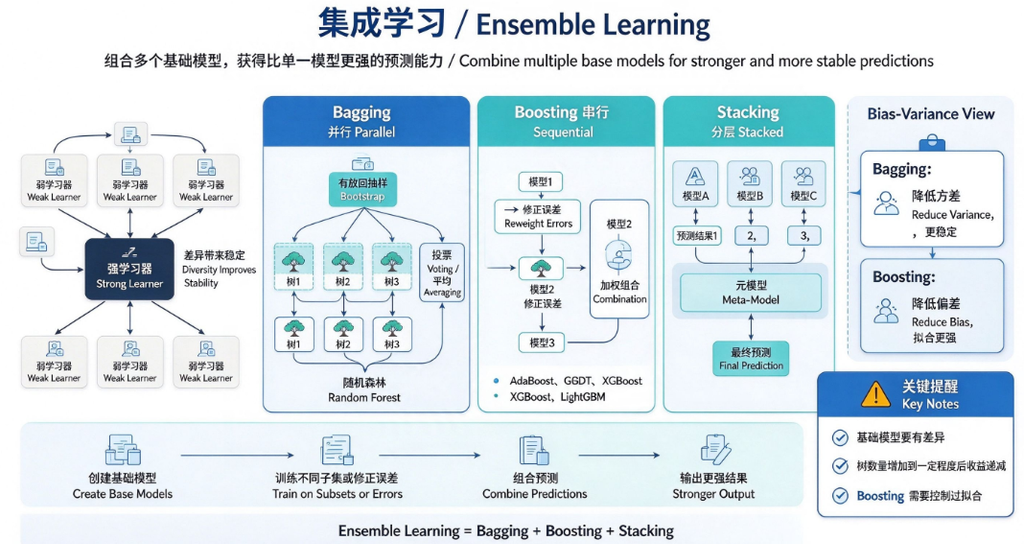
集成学习(Ensemble Learning)不是单一算法,而是将多个基础模型组合在一起,共同完成预测任务。利用多个模型的差异性,降低单个模型的误差,通常效果优于任意一个基础模型。
1. 核心思想
三个臭皮匠,顶个诸葛亮。
单个模型容易存在偏差或者方差问题:
- 弱学习器:效果一般、泛化能力有限的基础模型(常使用决策树)
- 集成学习:组合多个弱学习器,得到强学习器
集成学习主要分三大流派:Bagging、Boosting、Stacking。
2. 三大主流框架
Bagging(自助聚合)
并行训练,各个模型独立、互不影响。
- 对原始数据集做有放回抽样,得到多份不同训练子集
- 每份子集单独训练一个基础模型
- 预测:分类投票、回归取平均
代表:随机森林 Random Forest
随机森林额外增加特征随机选择,进一步降低树与树之间的相关性。
Boosting(提升)
串行训练,模型依次生成,后一个模型重点修正前一个模型的错误。
- 先训练第一个模型
- 对分错的样本提高权重,让下一个模型更加关注这些样本
- 不断迭代,最后加权组合所有模型
代表:AdaBoost、GBDT、XGBoost、LightGBM
Stacking(堆叠)
分层模型,第一层多个基础模型输出预测结果,作为第二层元模型的输入,由元模型学习如何融合结果。
- 第一层:多个不同基础模型
- 第二层:元学习器(比如逻辑回归)负责融合
3. 偏差与方差视角理解
- Bagging:降低方差,缓解过拟合(单棵树容易过拟合,多棵树平均后稳定)
- Boosting:降低偏差,提升模型拟合能力,但更容易过拟合
4. 优缺点
✅ 优点
- 预测精度高,是工业表格数据竞赛最常用方案
- 鲁棒性更强,不容易被噪声干扰
- 可以同时处理分类、回归任务
❌ 缺点
- 模型复杂度高,训练、推理耗时更大
- 可解释性变差,远不如单棵决策树直观
- 调参数量多,需要更多调优成本
5. Python 代码示例(随机森林)
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 生成数据集
np.random.seed(42)
X, y = make_classification(n_samples=150, n_features=2, n_informative=2, n_redundant=0, random_state=42)

# 划分训练集、测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 随机森林(Bagging代表)
model = RandomForestClassifier(n_estimators=50, max_depth=3, random_state=42)
model.fit(X_train, y_train)

# 预测评估
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
print(f"测试集准确率:{acc:.2f}")

# 绘制决策边界
def plot_decision_boundary(clf, X, y):
    x_min, x_max = X[:,0].min()-1, X[:,0].max()+1
    y_min, y_max = X[:,1].min()-1, X[:,1].max()+1
    xx, yy = np.meshgrid(np.linspace(x_min, x_max, 100), np.linspace(y_min, y_max, 100))
    Z = clf.predict(np.c_[xx.ravel(), yy.ravel()])
    Z = Z.reshape(xx.shape)
    plt.contourf(xx, yy, Z, alpha=0.3, cmap='coolwarm')
    plt.scatter(X[:,0], X[:,1], c=y, cmap='coolwarm')
    plt.xlabel("x1")
    plt.ylabel("x2")

plot_decision_boundary(model, X_train, y_train)
plt.title("随机森林决策边界")
plt.show()
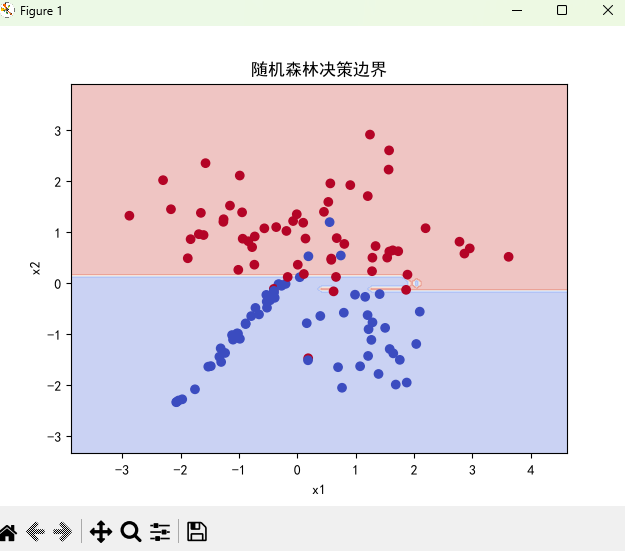
运行结果:
6. 适用场景
- 结构化表格数据(风控、广告、销量预测)
- 对精度要求高,接受一定推理耗时
- 机器学习竞赛基线首选模型
7. 常见误区
- 集成模型一定比单模型好:基础模型如果效果都很差,集成也很难提升
- 树越多效果一定越好:n_estimators 到一定程度后,收益不再增加,只会增加耗时
- Boosting 不容易过拟合:持续迭代会不断拟合噪声,需要正则、限制深度
思考题
- Bagging 和 Boosting 在训练顺序上有什么区别?
- 随机森林为什么同时对样本和特征做随机采样?
0 条笔记