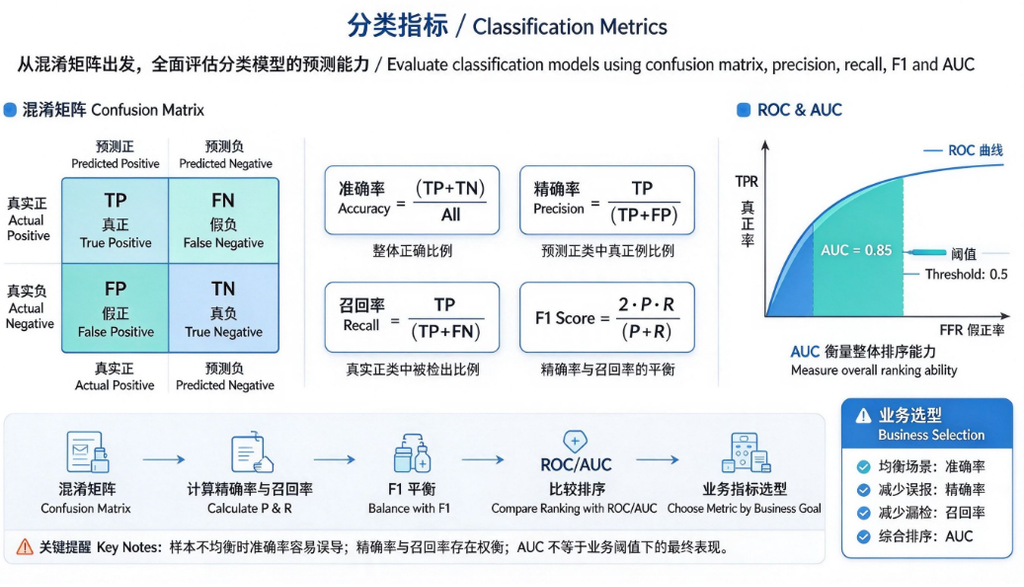
分类任务不能只用准确率来评判模型好坏,尤其在样本不均衡场景下,准确率会产生误导。我们依靠混淆矩阵衍生出精确率、召回率、F1、AUC等指标综合评估分类模型。
1. 混淆矩阵
二分类四个基础定义:
- TP(True Positive):真实正类,预测正类
- TN(True Negative):真实负类,预测负类
- FP(False Positive):真实负类,预测正类(误报)
- FN(False Negative):真实正类,预测负类(漏报)
| 预测正 | 预测负 | |
|---|---|---|
| 真实正 | TP | FN |
| 真实负 | FP | TN |
2. 常用指标公式
准确率 Accuracy
全部样本预测正确的比例。
缺陷:样本不均衡时,高准确率没有参考价值。例如99%都是负样本,模型无脑预测负,准确率也能达到99%。
精确率 Precision(查准率)
预测为正的样本里,真正是正样本的比例。
关注点:尽量少误报。适合垃圾邮件拦截、风控,不想误杀正常用户。
召回率 Recall(查全率)
所有真实正样本中,被成功找出的比例。
关注点:尽量不漏掉正样本。适合疾病筛查、故障检测,漏检代价很大。
F1-Score
精确率和召回率的调和平均,用来平衡两者:
F1越高,精确率和召回率同时比较优秀。
ROC曲线与AUC
- ROC:以FPR(假正率)为横轴、TPR(真正率)为纵轴,不断调整分类阈值画出的曲线
- AUC:ROC曲线下面积,取值 [0,1]
- AUC=1:完美分类;AUC=0.5:等价随机猜测;AUC<0.5:比随机还差
AUC优势:不受分类阈值影响,适合对比不同模型整体排序能力。
3. 多分类扩展
- 宏平均 macro:每个类别单独算指标,直接取平均,平等看待所有类别
- 加权平均 weighted:按各类样本数量加权,适合类别不均衡场景
4. Python 代码示例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score
from sklearn.metrics import confusion_matrix, roc_auc_score, roc_curve

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 构造二分类数据
np.random.seed(42)
X, y = make_classification(n_samples=200, n_features=5, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

model = LogisticRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)
y_prob = model.predict_proba(X_test)[:,1]

# 计算指标
acc = accuracy_score(y_test, y_pred)
pre = precision_score(y_test, y_pred)
rec = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)
auc = roc_auc_score(y_test, y_prob)

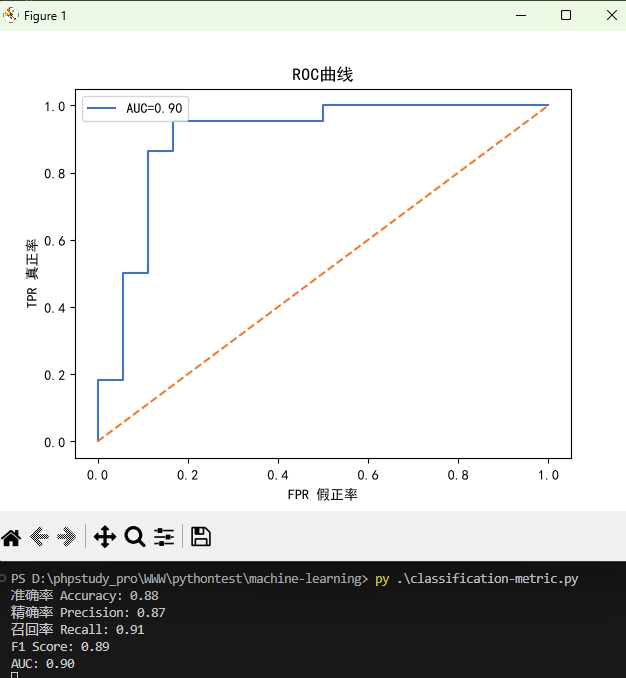
print(f"准确率 Accuracy: {acc:.2f}")
print(f"精确率 Precision: {pre:.2f}")
print(f"召回率 Recall: {rec:.2f}")
print(f"F1 Score: {f1:.2f}")
print(f"AUC: {auc:.2f}")

# 绘制ROC曲线
fpr, tpr, _ = roc_curve(y_test, y_prob)
plt.plot(fpr, tpr, color="#4472c4", label=f"AUC={auc:.2f}")
plt.plot([0,1],[0,1], color="#ed7d31", linestyle="--")
plt.xlabel("FPR 假正率")
plt.ylabel("TPR 真正率")
plt.title("ROC曲线")
plt.legend()
plt.show()
结果:
5. 指标选型参考
- 正负样本均衡、简单场景:优先看准确率
- 怕误报:优先精确率
- 怕漏检:优先召回率
- 需要兼顾精确率与召回率:F1
- 比较模型排序能力、阈值可调:AUC
6. 常见误区
- 准确率越高模型越好:不均衡数据集极易踩坑
- 精确率和召回率可以同时无限拉高:二者存在权衡关系,阈值上调,精确率上升、召回下降
- AUC高就一定适合业务:AUC代表排序能力,不代表业务阈值下的精确/召回满足需求
思考题
- 风控场景,拒绝贷款给客户,FP和FN分别代表什么?业务更关注哪一个?
- 什么场景下F1比准确率更适合作为评价标准?
0 条笔记