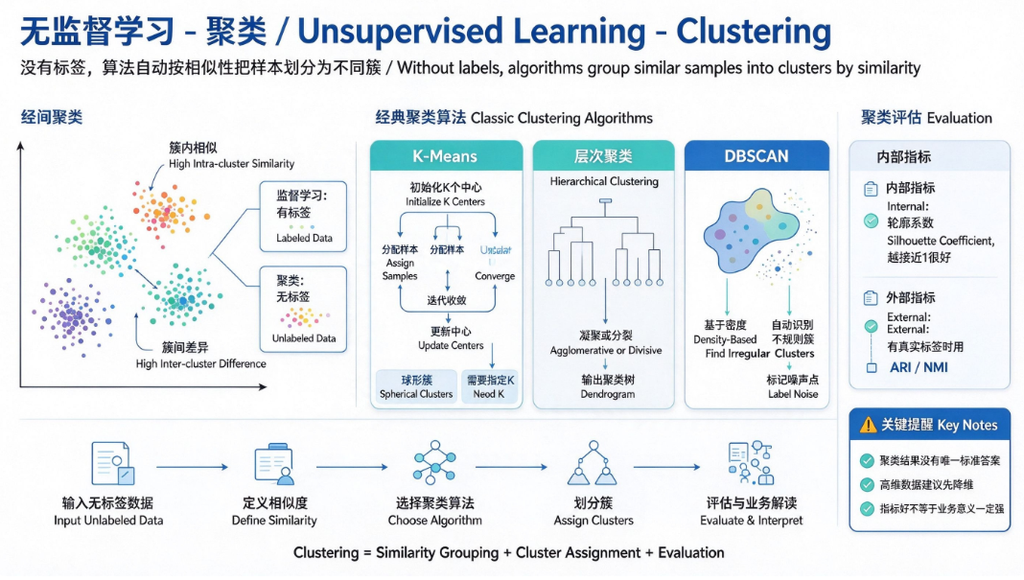
聚类属于无监督学习,训练数据没有标签,模型自动根据样本特征的相似程度,把相似样本划分到同一个簇(Cluster)。簇内样本相似度高,簇与簇之间差异大。
1. 基本原理
监督学习:数据带标签,模型学习“特征→标签”的映射关系。
聚类(无监督):只有特征,没有标签,算法自动寻找数据内在分组结构。
核心:相似度计算,常用欧氏距离、曼哈顿距离、余弦距离。
2. 经典聚类算法
K-Means(K均值聚类)
最常用、简单的聚类算法。
步骤:
- 预先指定聚类数量K,随机初始化K个簇中心
- 分配:每个样本归到距离最近的簇中心
- 更新:每个簇重新计算均值,作为新的簇中心
- 循环分配、更新,直到簇中心不再明显变化
✅ 优点:速度快、实现简单,适合大规模数据
❌ 缺点:需要提前指定K;对初始中心点、异常值敏感;适合球形分布数据
层次聚类 Hierarchical Clustering
分为自底向上(凝聚)、自顶向下(分裂),输出聚类树(谱系图)。
优点:不需要预先指定K;缺点:计算量大,大数据慢。
DBSCAN(基于密度的聚类)
依靠样本密度划分簇,不需要预先设置K。
- 核心点、边界点、噪声点
- 可以识别不规则形状簇,自动识别离群点
缺点:对距离参数敏感,高维数据效果变差。
3. 聚类评估指标
聚类没有标签,评估分为两类:
- 内部指标(只用数据本身)
轮廓系数 Silhouette Coefficient:取值 [-1,1],越接近1,聚类效果越好。 - 外部指标(有真实标签时)
ARI调整兰德系数、NMI归一化互信息,用来和真实分组对比。
4. 优缺点
✅ 优点
- 不需要标注数据,标注成本很高的场景非常合适
- 用来做数据探索、发现隐藏模式、用户分群
- 可以作为前置预处理,为后续监督学习做特征
❌ 缺点
- 结果没有绝对“正确答案”,主观性强
- 高维数据距离失效(维度灾难),一般需要降维
- 算法对参数敏感,调参难度大
5. Python 代码示例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 生成聚类模拟数据
np.random.seed(42)
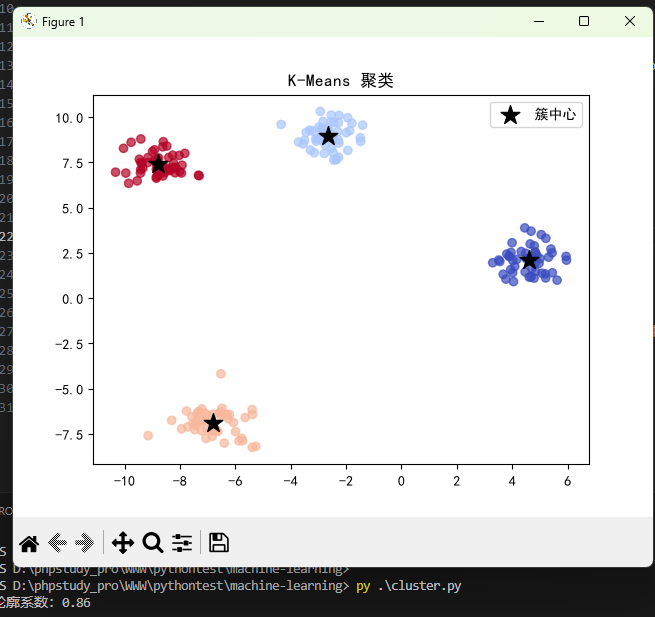
X, _ = make_blobs(n_samples=200, n_features=2, centers=4, cluster_std=0.7, random_state=42)

# K-Means 聚类,指定K=4
kmeans = KMeans(n_clusters=4, random_state=42, n_init='auto')
y_pred = kmeans.fit_predict(X)

# 轮廓系数
sil = silhouette_score(X, y_pred)
print(f"轮廓系数:{sil:.2f}")

# 绘图
plt.scatter(X[:,0], X[:,1], c=y_pred, cmap="coolwarm", alpha=0.7)
# 绘制簇中心
centers = kmeans.cluster_centers_
plt.scatter(centers[:,0], centers[:,1], c='black', marker='*', s=200, label="簇中心")
plt.legend()
plt.title("K-Means 聚类")
plt.show()
6. 适用场景
- 用户分群、商品分组、文本主题挖掘
- 异常检测(DBSCAN识别噪声点)
- 数据探索、降维后的分组可视化
- 半监督学习:先聚类,再打少量标签
7. 常见误区
- 聚类一定能分出有业务意义的组:算法只按距离分组,分组不一定符合业务理解
- K-Means 适合所有形状数据:只擅长球形簇;长条、环形簇建议DBSCAN
- 轮廓系数越高就一定适合业务:只是数学指标,需要结合业务解读
思考题
- K-Means 为什么需要提前给定K?有什么办法辅助选择K?
- DBSCAN 和 K-Means 的适用场景有什么差别?
0 条笔记