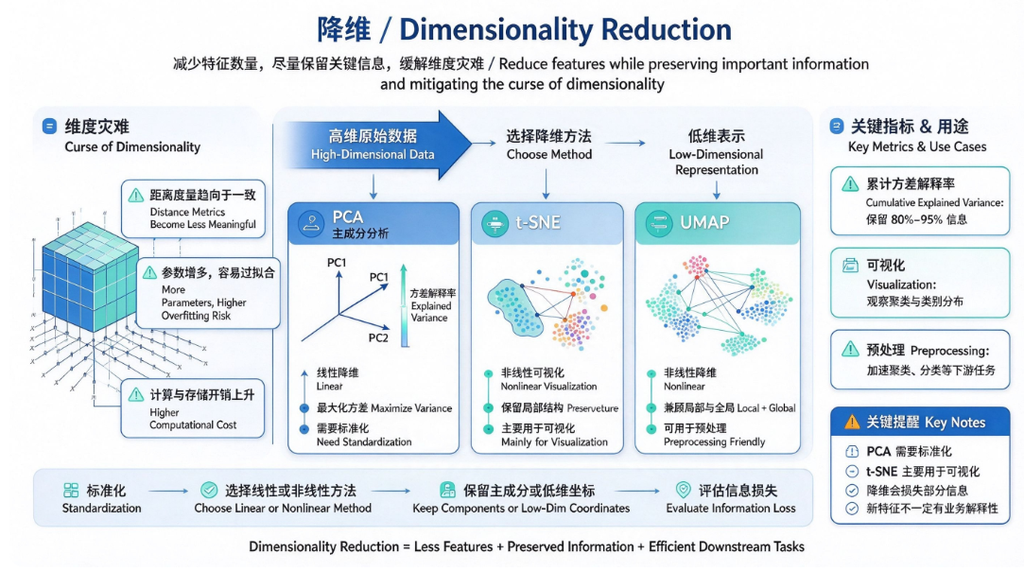
降维是无监督学习常用的数据预处理手段。简单来说:减少特征数量,同时尽量保留数据里的有效信息。高维特征会带来维度灾难,降维可以压缩数据、降噪、方便可视化。
1. 什么是维度灾难
当特征维度很高时:
- 样本之间距离趋向一致,距离度量失效(KNN、聚类效果变差)
- 模型参数变多,更容易过拟合
- 计算、存储开销大幅上升
降维就是用来缓解维度灾难。
2. 主流降维算法
PCA 主成分分析(最常用)
核心:寻找新的正交坐标轴(主成分),按方差从大到小排序;
- 第一主成分:捕获数据最大方差
- 第二主成分:捕获剩余最大方差,且和第一主成分正交
- 丢弃方差很小的主成分,实现降维
PCA 是线性降维,适合线性结构数据;需要先标准化。
t-SNE
非线性降维,擅长二维/三维可视化;
重点保留局部样本之间的相对距离。
缺点:计算慢、不适合做下游模型输入,一般只用来画图,不能用于训练。
UMAP
非线性降维,t-SNE 的改进版本:
保留局部结构的同时兼顾全局结构,速度更快,既可以可视化,也可以作为模型预处理。
其他
- LDA 线性判别分析:带标签的降维(监督降维,目标是拉开类别间距)
- 因子分析:寻找隐藏潜变量
3. PCA 关键要点
- 方差解释率:每个主成分能承载多少原始数据信息
- 累计方差解释率:用来选择保留多少维,一般保留 80%~95% 信息
- PCA 输出的新特征没有物理含义,是原始特征的线性组合
4. 优缺点
✅ 优点
- 减少特征数量,加速模型训练
- 去除冗余特征、降低特征之间的多重共线性
- 降噪,去掉方差很小的噪声维度
- 二维可视化,方便观察数据分布
❌ 缺点
- PCA 是线性的,无法捕捉复杂非线性关系
- 丢失一部分信息,降维会带来信息损失
- 新特征失去可解释性,不再是原始业务特征
- 对异常值敏感
5. Python 代码示例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 加载鸢尾花数据集,4维特征
data = load_iris()
X = data.data
y = data.target

# PCA必须标准化
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)

# 降维到2维
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X_scaled)

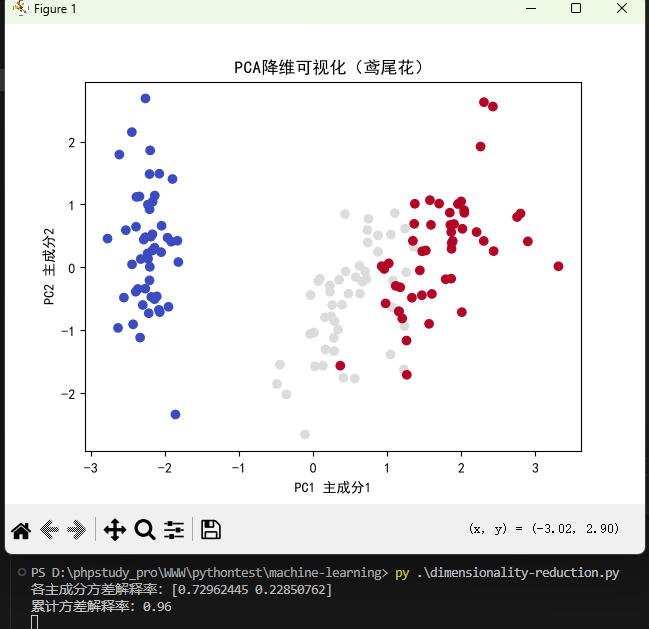
print(f"各主成分方差解释率:{pca.explained_variance_ratio_}")
print(f"累计方差解释率:{np.sum(pca.explained_variance_ratio_):.2f}")

# 绘图
plt.scatter(X_pca[:,0], X_pca[:,1], c=y, cmap="coolwarm")
plt.xlabel("PC1 主成分1")
plt.ylabel("PC2 主成分2")
plt.title("PCA降维可视化(鸢尾花)")
plt.show()
6. 适用场景
- 特征很多、特征高度相关(多重共线性)
- 高维数据可视化
- 作为预处理,加速聚类、SVM等算法
- 去除噪声
7. 常见误区
- 降维一定提升模型效果:降维会丢失信息,有可能效果变差
- t-SNE降维后可以直接拿去训练模型:t-SNE只适合可视化
- PCA不需要标准化:不同量纲特征会主导方差,必须标准化
思考题
- PCA为什么需要做标准化?
- t-SNE 和 PCA 在用途上最大区别是什么?
0 条笔记