回归模型用于预测连续数值,不能直接用分类任务里的准确率来衡量好坏,需要使用专门的回归评估指标,用来判断模型预测值和真实值之间的误差大小。
1. 常用评估指标
设: 为真实值, 为模型预测值, 为样本数量。
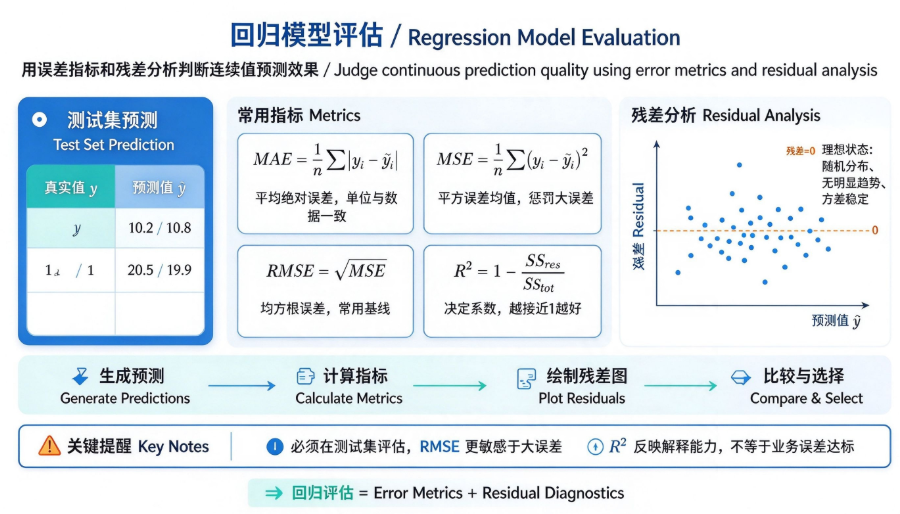
平均绝对误差 MAE(Mean Absolute Error)
- 含义:预测值与真实值差值的绝对值平均值
- 特点:对异常值不敏感,误差直观,单位和原始数据一致
均方误差 MSE(Mean Squared Error)
- 含义:误差平方的平均值
- 特点:放大较大的误差,惩罚偏离很远的预测点
均方根误差 RMSE(Root Mean Squared Error)
- 含义:MSE开平方根
- 特点:单位和原始数据一致,是回归最常用指标之一
决定系数(R-Squared)
是真实标签的平均值
- 取值范围:一般
- :模型完美拟合;:效果等于直接取均值预测;负数代表模型比直接取均值还差
重点: 受数据波动影响,不能只看单一指标,需要和MAE/RMSE一起参考。
2. 残差分析(辅助评估)
残差 = 真实值 − 预测值
理想回归模型的残差满足:
- 残差均值接近0
- 残差随机分布,没有明显趋势、弯曲、漏斗形状
- 残差方差稳定(同方差)
如果残差图有明显规律,说明模型还有信息没有学到,可能是非线性关系,需要换模型或者做特征工程。
3. 评估流程
- 训练模型,在测试集上做预测(不要用训练集评估,容易过拟合)
- 计算 MAE、MSE、RMSE、
- 绘制残差图,观察误差分布
- 对比多个模型指标,选择合适模型
4. Python 代码示例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 构造数据
np.random.seed(42)
X = np.linspace(0, 10, 100).reshape(-1,1)
y = 2.5 * X.flatten() + 4 + np.random.normal(0, 1.2, size=100)

# 划分数据集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 训练线性回归
model = LinearRegression()
model.fit(X_train, y_train)
y_pred = model.predict(X_test)

# 计算评估指标
mae = mean_absolute_error(y_test, y_pred)
mse = mean_squared_error(y_test, y_pred)
rmse = np.sqrt(mse)
r2 = r2_score(y_test, y_pred)

print(f"MAE = {mae:.2f}")
print(f"MSE = {mse:.2f}")
print(f"RMSE = {rmse:.2f}")
print(f"\(R^2\) = {r2:.2f}")

# 绘制残差图
residual = y_test - y_pred
plt.scatter(y_pred, residual, c="#4472c4")
plt.axhline(y=0, color="#ed7d31", linestyle="--")
plt.xlabel("预测值")
plt.ylabel("残差")
plt.title("残差分布图")
plt.show()
运行结果:
5. 指标怎么选
- 需要直观理解误差大小:优先 MAE
- 希望严惩大误差:优先 RMSE
- 看模型对数据的解释能力:看
- 业务有明确误差上限:结合业务阈值判断
6. 常见误区
- 在训练集上评估指标:会高估模型效果,无法反映泛化能力
- 只看R²,忽略RMSE:R²高不代表绝对误差满足业务要求
- 不同量纲的数据直接对比RMSE:RMSE和数据单位强相关,跨数据集不能直接比较
思考题
- RMSE 和 MAE 哪个更容易受异常值影响?为什么?
- 能不能为负数?负数代表什么含义?
0 条笔记