决策树是一种监督学习算法,既可以做分类,也可以做回归。它模拟人类的判断逻辑,通过一系列if-then分支规则完成预测,可读性很强。
1. 基本原理
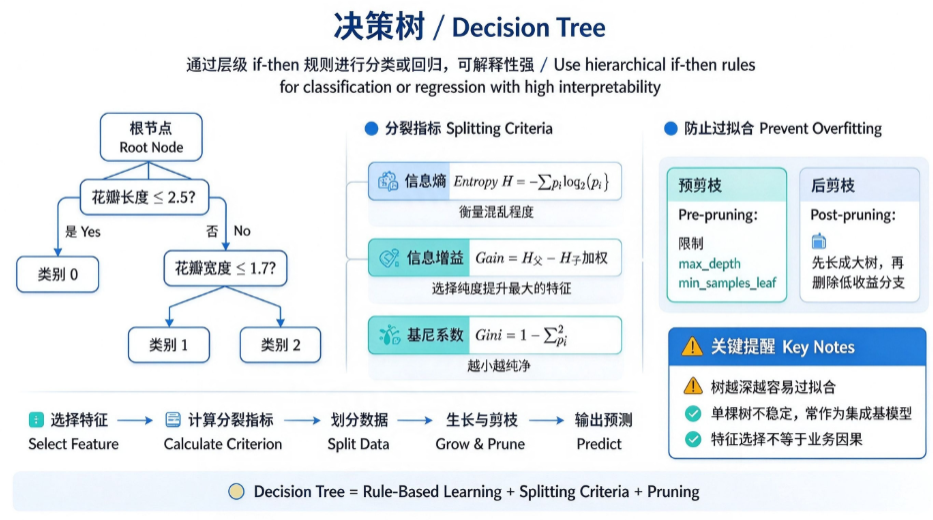
决策树由根节点、内部节点、分支、叶子节点组成:
- 根节点:全部样本的起点
- 内部节点:特征判断条件
- 分支:判断结果
- 叶子节点:最终预测输出(类别或者数值)
核心思想:选择特征对数据集进行划分,划分之后,子集内部的数据尽量“纯净”。
分类树常用:基尼系数(Gini)、信息熵(Entropy);回归树常用:均方误差MSE。
信息熵(衡量混乱程度)
是第i类样本占比;熵越大,数据越混乱。
信息增益
信息增益越大,代表这个特征划分之后,数据混乱度下降越多,优先选这个特征分裂。
基尼系数
基尼系数越小,数据集纯度越高。sklearn决策树默认用基尼系数。
2. 决策树生长与剪枝
- 预剪枝:树生长过程中提前停止,限制最大深度、最小样本数,防止无限分裂
- 后剪枝:先生成完整大树,再从底部删掉收益很小的分支
不做剪枝的决策树非常容易过拟合,会死死记住训练数据的噪声。
3. 优缺点
✅ 优点
- 输出规则清晰,可以可视化,可解释性强
- 不需要对特征做归一化、标准化
- 可以同时处理连续特征和离散特征
- 能自动学习特征交互关系
❌ 缺点
- 容易过拟合
- 对数据微小变动敏感,样本稍微变化,树结构可能大变
- 偏向选择取值很多的特征
- 单棵决策树效果上限一般,工业上大多配合集成学习(随机森林、XGBoost)
4. Python 代码示例
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.tree import DecisionTreeClassifier, plot_tree
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 加载鸢尾花数据集
data = load_iris()
X = data.data
y = data.target
feature_names = data.feature_names
class_names = data.target_names

# 划分训练集、测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 构建决策树,预剪枝:限制最大深度
model = DecisionTreeClassifier(criterion="gini", max_depth=3, random_state=42)
model.fit(X_train, y_train)

# 预测评估
y_pred = model.predict(X_test)
acc = accuracy_score(y_test, y_pred)
print(f"测试集准确率:{acc:.2f}")

# 绘制决策树
plt.figure(figsize=(12, 8))
plot_tree(model, feature_names=feature_names, class_names=class_names, filled=True)
plt.show()
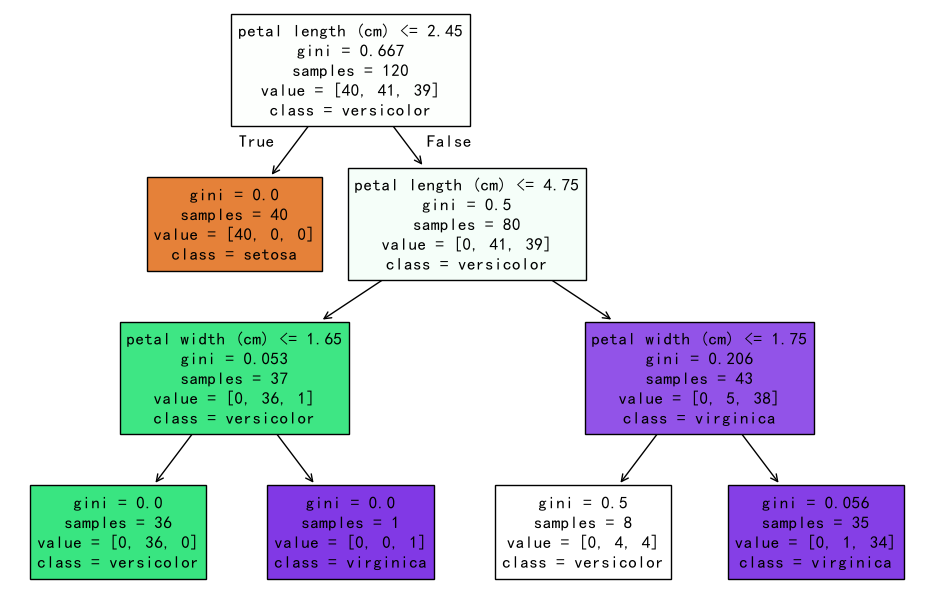
运行结果:
5. 适用场景
- 需要可解释规则的业务:风控审批、医疗辅助判断
- 表格结构化数据
- 作为集成模型的基础单元(随机森林、GBDT)
6. 常见误区
- 决策树不用调参:max_depth、min_samples_split 等参数是控制过拟合的关键
- 树越深效果越好:深度太大极易过拟合
- 自动选出的特征就是业务上最重要的特征:只代表对划分有用,不代表业务因果
思考题
- 信息熵和基尼系数分别适合什么场景?
- 为什么单棵决策树不稳定,集成之后效果会明显提升?
0 条笔记