强化学习(Reinforcement Learning,RL)不同于监督学习、无监督学习,它是智能体(Agent)在环境中不断交互试错,通过累积奖励学习最优策略的学习范式。
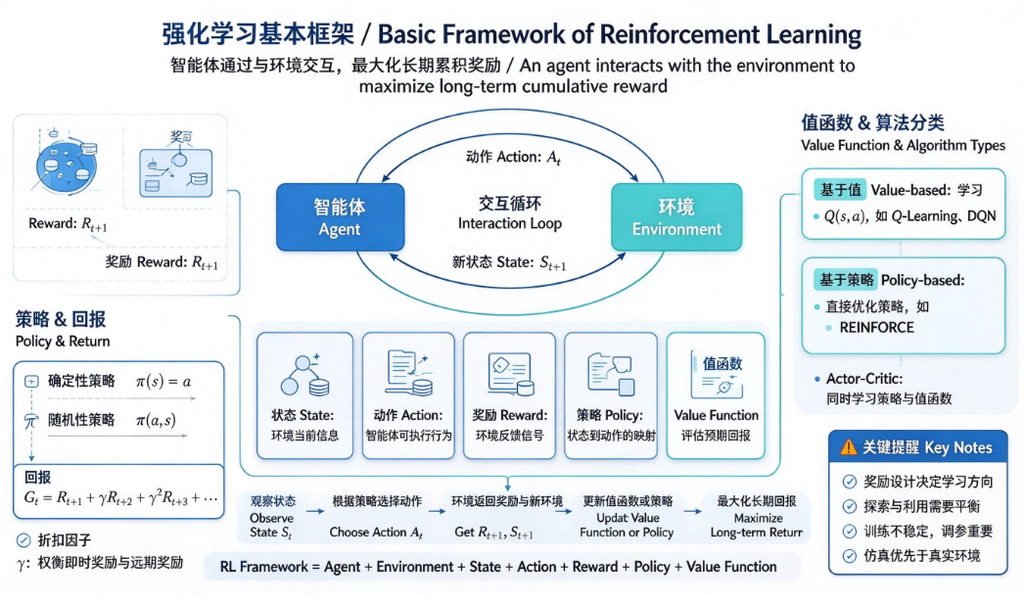
1. 五大核心组件
- 智能体 Agent:学习者、决策者,负责输出动作
- 环境 Environment:智能体所处的外部世界,接收动作、返回新状态与奖励
- 状态 State (S):环境当前的观测信息,描述当下局面
- 动作 Action (A):智能体可以执行的行为
- 奖励 Reward (R):环境给智能体的反馈,正数代表正向激励,负数代表惩罚
交互循环:
2. 策略 Policy
策略 是智能体的决策规则:给定状态,输出动作。
- 确定性策略:,一个状态固定输出一个动作
- 随机性策略:,输出动作的概率分布
强化学习最终目标:找到最优策略,让长期累积回报最大,而不是单步奖励最大。
3. 回报(Return)与折扣因子
总回报:从当前时刻开始,后续所有奖励加权求和
- :折扣因子
- 接近1:看重远期未来奖励
- 接近0:只在乎眼前即时奖励
4. 值函数 Value Function
值函数用来评估状态或者状态-动作对能拿到多少预期回报
- 状态值函数 :在状态下,按策略执行,能获得的期望累积回报
- 动作值函数 :在状态执行动作之后,后续能获得的期望累积回报(Q值)
5. 两大经典分类
- 基于值(Value-based):学习Q值,通过Q值选择动作,代表算法:Q-Learning、DQN
- 基于策略(Policy-based):直接学习优化策略,代表算法:REINFORCE
还有Actor-Critic,同时学习策略和值函数,结合两者优势
6. 优缺点
✅ 优点
- 不需要预先标注样本,靠交互收集数据
- 适合序列决策、连续交互场景
- 可以处理动态环境,在线持续学习
❌ 缺点
- 训练不稳定、调参难度大
- 奖励函数设计非常关键,奖励设置不对会学出奇怪策略(奖励陷阱)
- 试错成本高,真实环境交互有风险,一般先仿真训练
7. Python 极简示例(Q-Learning 示意)
import numpy as np
import matplotlib.pyplot as plt

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

# 简单格子环境,4个状态,2个动作:0左,1右
np.random.seed(42)
n_states = 4
n_actions = 2
Q = np.zeros((n_states, n_actions))

alpha = 0.1    # 学习率
gamma = 0.9    # 折扣因子
epsilon = 0.1  # epsilon-greedy探索

def choose_action(s):
    if np.random.random() < epsilon:
        return np.random.randint(n_actions)
    else:
        return np.argmax(Q[s])

# 迭代训练
for episode in range(200):
    s = 0
    while s != 3:
        a = choose_action(s)
        if a == 1 and s < 3:
            s_next = s + 1
            r = 1 if s_next == 3 else 0
        else:
            s_next = s
            r = 0
        # Q更新
        Q[s,a] = Q[s,a] + alpha * (r + gamma * np.max(Q[s_next]) - Q[s,a])
        s = s_next

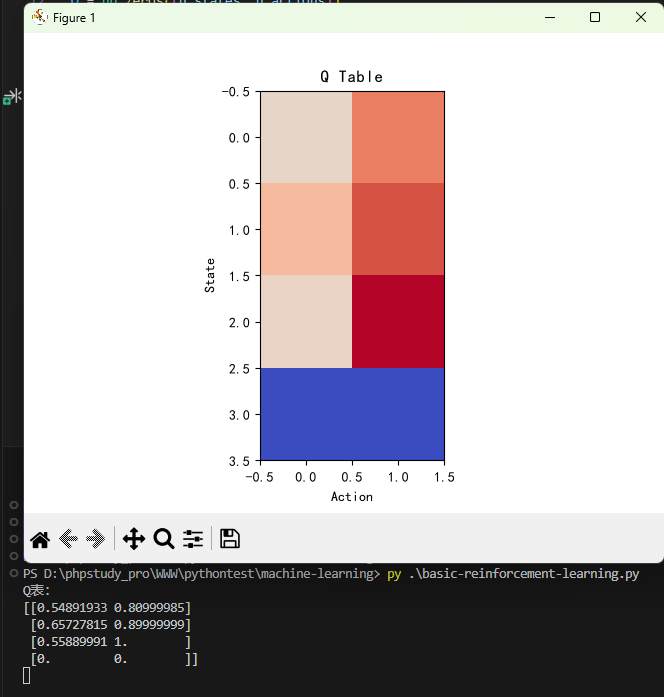
print("Q表:")
print(Q)
plt.imshow(Q, cmap="coolwarm")
plt.xlabel("Action")
plt.ylabel("State")
plt.title("Q Table")
plt.show()
运行结果:
8. 适用场景
- 游戏AI、机器人控制、自动驾驶决策
- 推荐系统动态排序、资源调度
- 博弈、时序序列决策任务
9. 常见误区
- 奖励越高越好:智能体会钻奖励函数漏洞,出现投机行为
- 强化学习和监督学习一样:监督学习用标签,强化学习只有延迟奖励
- 折扣因子 越大收敛越快: 太大容易震荡,过小短视
思考题
- 即时奖励和长期回报的区别是什么?折扣因子 起到什么作用?
- Epsilon-Greedy 策略里,探索(exploration)和利用(exploitation)是什么意思?
0 条笔记