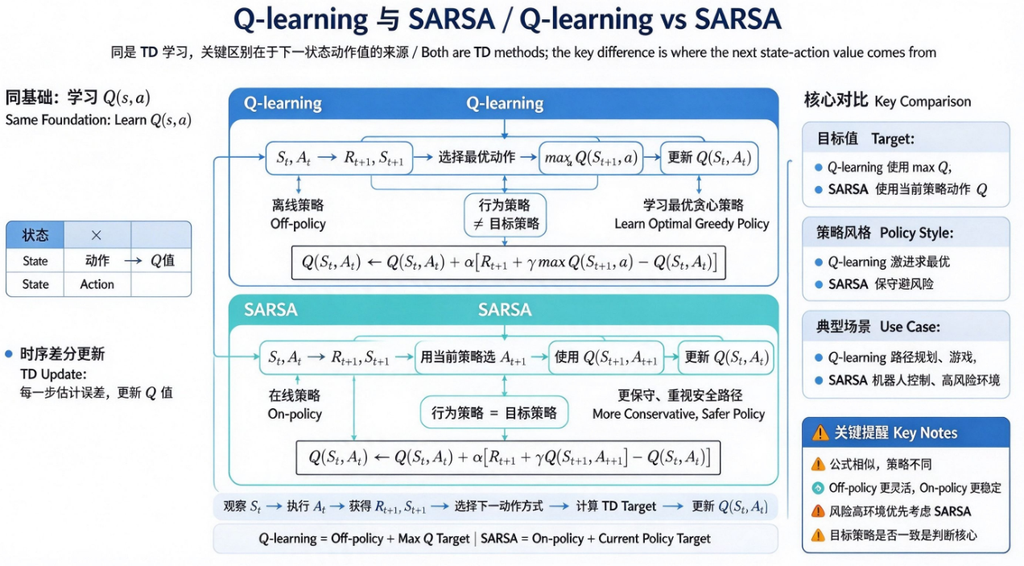
Q-learning 和 SARSA 都是基于值函数的时序差分(TD)强化学习算法,维护一张 Q 表(状态-动作值函数),用来估计 。二者最大区别:Q-learning 是离线策略(Off-policy),SARSA 是在线策略(On-policy)。
1. 核心概念回顾
- (Q(s,a)):在状态 执行动作 ,后续能获得的期望累积回报
- 时序差分 TD:不需要等到回合结束,每一步就更新Q值
- 在线策略:用来收集样本的策略,和用来更新Q值的策略是同一个
- 离线策略:用一个策略收集样本,学习另一个更优策略
2. SARSA
名字来源于更新公式里的五元组:
- 先在 选动作 ,得到奖励 、下一个状态
- 再用当前策略,在 选出下一个动作
- 更新公式:
特点:
- On-policy,跟着自己的探索策略学习
- 更加保守,倾向避开危险、高惩罚的路径
- 适合环境里有很大风险、需要安全策略的场景
3. Q-learning
更新只使用 ,不需要预先选
- 直接取下一状态里最大的Q值
- 更新公式:
特点:
- Off-policy,学习最优贪心策略,样本可以来自带有探索的策略
- 更加大胆,敢于学习最优路径,忽略探索过程里的随机动作
- 最经典、入门最常用
4. 对比表
| 项目 | SARSA | Q-learning |
|---|---|---|
| 策略类型 | On-policy 在线策略 | Off-policy 离线策略 |
| 目标Q值 | (当前策略选出的动作) | maxaQ(St+1,a)(最优动作) |
| 行为风格 | 保守、安全 | 激进、追求最优路线 |
| 样本 | 行为策略和目标策略一致 | 行为策略 ≠ 目标策略 |
5. Python 代码示例
import numpy as np
import matplotlib.pyplot as plt

# 字体配置,解决 DejaVu Sans 中文缺失警告
plt.rcParams['font.sans-serif'] = ['SimHei', 'DejaVu Sans']
plt.rcParams['axes.unicode_minus'] = False

np.random.seed(42)
alpha = 0.1
gamma = 0.9
epsilon = 0.1
n_states = 5
n_actions = 2

def choose_action(s, Q):
    if np.random.rand() < epsilon:
        return np.random.randint(n_actions)
    else:
        return np.argmax(Q[s])

# Q-Learning
Q_ql = np.zeros((n_states, n_actions))
for ep in range(300):
    s = 0
    while s != 4:
        a = choose_action(s, Q_ql)
        if a == 1 and s < 4:
            s_next = s + 1
            r = 1 if s_next == 4 else 0
        else:
            s_next = s
            r = 0
        # Q-learning:取max Q
        td_target = r + gamma * np.max(Q_ql[s_next])
        Q_ql[s,a] = Q_ql[s,a] + alpha * (td_target - Q_ql[s,a])
        s = s_next

# SARSA
Q_sarsa = np.zeros((n_states, n_actions))
for ep in range(300):
    s = 0
    a = choose_action(s, Q_sarsa)
    while s != 4:
        if a == 1 and s < 4:
            s_next = s + 1
            r = 1 if s_next == 4 else 0
        else:
            s_next = s
            r = 0
        a_next = choose_action(s_next, Q_sarsa)
        # SARSA:用下一个动作的Q
        td_target = r + gamma * Q_sarsa[s_next, a_next]
        Q_sarsa[s,a] = Q_sarsa[s,a] + alpha * (td_target - Q_sarsa[s,a])
        s, a = s_next, a_next

print("Q-learning Q表:")
print(Q_ql)
print("SARSA Q表:")
print(Q_sarsa)

plt.figure(figsize=(9,4))
plt.subplot(1,2,1)
plt.imshow(Q_ql, cmap="coolwarm")
plt.title("Q-learning Q Table")
plt.xlabel("Action")
plt.ylabel("State")

plt.subplot(1,2,2)
plt.imshow(Q_sarsa, cmap="coolwarm")
plt.title("SARSA Q Table")
plt.xlabel("Action")
plt.ylabel("State")
plt.tight_layout()
plt.show()
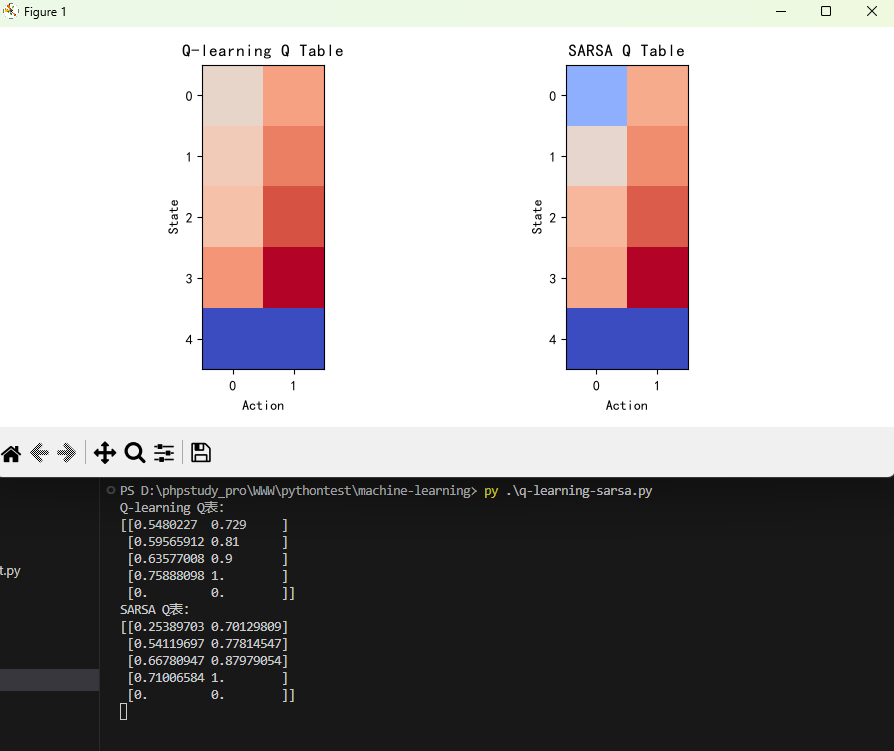
运行结果:
6. 适用场景
- Q-learning:路径规划、游戏、想直接学习全局最优策略
- SARSA:机器人控制、真实环境,风险高,需要规避危险动作
7. 常见误区
- SARSA效果一定比Q-learning差:只是策略风格不同,风险高的场景SARSA更合适
- 离线策略一定更好:离线策略样本利用更灵活,但学习稳定性会变差
- 两者公式几乎一样,没有本质区别:目标策略是否和行为策略一致是核心差异
思考题
- On-policy 和 Off-policy 的区别是什么?
- 在有悬崖的格子世界(Cliff Walking),SARSA 和 Q-learning 走出的路线会有什么不同?
0 条笔记