看懂计算机视觉:从卷积网络到文生图VLM多模态大模型
人类获取的绝大部分外界信息来自眼睛,但对于计算机来说,图片只是一大堆RGB数字像素。计算机视觉(CV),就是教会机器看懂图片、视频的技术。手机人脸解锁、自动驾驶识别路况、AI绘画、医学影像读片,背后全是计算机视觉。
计算机视觉发展走过两条重要路线:早期以CNN卷积神经网络为主;后来Transformer进入视觉领域,出现ViT;再到扩散模型、CLIP、VLM视觉语言大模型,实现看图说话、文生图。
通俗比喻:
CNN卷积神经网络就像人眼的视觉皮层,一点点抓取边缘、纹理、轮廓;
ViT视觉Transformer把图片拆成小块,像处理文字token一样,全局理解整张图片;
扩散模型,从一堆随机噪声,一步步还原出完整图片;
VLM视觉语言大模型,同时看懂图片+读懂人类文字指令。
一、CNN卷积神经网络:计算机视觉的基石
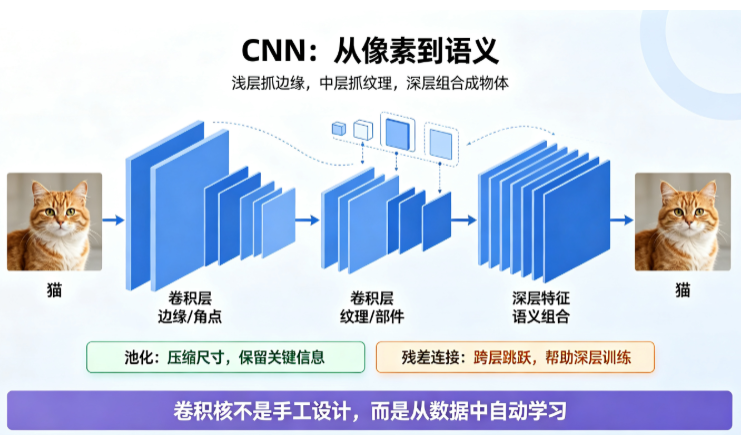
卷积是CNN最核心操作:用一个小的卷积核窗口,在图像上面滑动扫描,提取图像局部特征。
- 浅层卷积核抓底层特征:边缘、线条、角点;
- 深层卷积组合底层特征,识别纹理、部件,最后识别物体。
两大关键操作:卷积 + 池化
- 卷积:滑动窗口做加权求和,生成特征图,挖掘图像特征。卷积核不是人手动写死,是模型训练过程自己学出来的。
- 池化Pooling:压缩特征图尺寸,降低计算量,保留关键信息。最常用最大池化,取窗口内像素最大值。
ResNet残差连接,解决网络“变深就训不动”
网络层数堆得越深,理论上识别能力越强,但深层网络容易出现梯度消失,越训效果越差。
ResNet提出残差跳跃连接(Skip‑Connection):不再让网络从零学习完整映射,只学习输入需要“修改多少”,公式 y = F(x)+x。输入直接跨过卷积层加到输出,梯度可以直接回传,于是网络可以做到几十上百层。
经典CNN架构简单对比
| 模型 | 核心创新 | 特点 |
|---|---|---|
| AlexNet | ReLU、Dropout、数据增强 | 开启深度学习CV时代 |
| VGG | 统一小3×3卷积核 | 结构简单,容易复现 |
| ResNet | 残差跳跃连接 | 支持上百层超深网络 |
| EfficientNet | 深度、宽度、分辨率复合缩放 | 参数效率高,轻量高性能 |
二、ViT视觉Transformer:把图片当句子处理
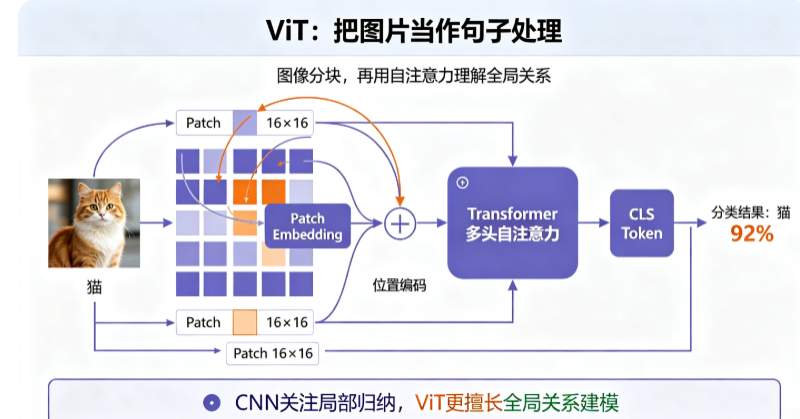
2020年《An Image is Worth 16×16 Words》提出ViT,把NLP的Transformer搬到图像。
Patch图像分块
图像是二维网格,Transformer擅长处理一维序列。
ViT做法:把一张大图切成很多固定大小小块(Patch,常见16×16像素)。每一个小块当成一个“文字token”,投影成向量,再送入Transformer做自注意力计算。
同时增加:
- 位置编码:告诉模型每一块图片在原图的哪个位置;
- CLS分类token:专门用来汇总整张图片全局信息,最后拿来做图像分类。
CNN vs ViT怎么选
- CNN:有很强的图像先验知识,小数据集表现好,硬件优化成熟,推理速度快;
- ViT:依靠自注意力,擅长捕捉图片远距离关联,需要海量训练数据才能发挥全部实力,大数据集上限更高。
现在也有ConvNeXt这类混合架构,融合两者优势。
三、三大经典视觉任务:分类、检测、分割
1. 图像分类:这张图是什么
输入一张图片,输出类别。比如识别是猫、狗、汽车。CNN、ViT都可以完成这个任务。
2. 目标检测:是什么 + 在什么位置
不仅要知道图里有什么,还要输出物体的矩形框坐标。分两大流派:
- 两阶段检测(Faster‑R‑CNN):先生成候选物体区域,再分类、修正框位置;精度高,速度偏慢。
- 单阶段检测(YOLO系列):整张图划分网格,一步同时输出类别+框,速度极快,适合摄像头、视频实时识别。
- DETR:用Transformer做检测,抛弃锚框、NMS,直接序列输出检测结果。
3. 图像分割:识别到每一个像素
比检测更进一步,不再只用方框,给图像每一个像素打上标签。
- 语义分割:只区分类别,所有的人全部标为同一类,不区分个体;
- 实例分割:区分每一个独立个体,图中多个人,要分开标记;
- 全景分割:同时处理物体和背景,统一语义+实例。
Meta的SAM(Segment Anything Model)提示分割模型:输入点、框,模型就能抠出对应物体,实现零样本通用分割,大幅降低分割落地成本。
四、扩散模型:AI绘画背后的秘密
现在Stable Diffusion、Midjourney都是基于扩散模型。整套流程分为前向加噪、反向去噪。
- 前向扩散(训练阶段):给清晰图片一步一步持续添加高斯噪声,最后图片彻底变成白噪声。这个过程数学可计算。
- 反向扩散(生成阶段):训练U‑Net网络,输入带噪声图片,预测图中的噪声;从纯噪声图片开始,循环预测、去除噪声,一点点还原出清晰图像。
U‑Net网络:U型结构,下采样压缩特征,上采样恢复分辨率,跳跃连接传递细节,是扩散模型的核心骨干网络。
Stable Diffusion为了提速,不直接在像素图片运算,使用VAE变分自编码器,压缩到更小的隐空间做去噪,最后再解码还原图片。搭配CLIP文本编码器,实现文字提示词生成图片。
采样器
DDPM原始需要1000步,太慢;DDIM、DPM‑Solver等采样器,20‑30步就可以生成高质量图片,现在AI绘画普遍使用快速采样器。
五、CLIP:打通文字和图像的桥梁
CLIP(OpenAI)用对比学习完成图文对齐。
把图片、文字分别编码,投射进同一个向量空间:匹配的图文对向量相似度高;不匹配图文相似度低。
CLIP带来最重要能力:零样本图像分类。不用重新训练模型,直接用文字描述类别,就能完成图片识别。
CLIP也是文生图、VLM视觉语言模型的重要底层组件。
六、VLM视觉语言模型:看图说话的多模态AI
VLM视觉语言模型,就是现在GPT‑4V、LLaVA这类模型,既看得懂图片,又能理解文字,实现看图问答、图片描述。
典型架构(LLaVA为代表)三部分:
- 视觉编码器(来自CLIP/ViT),把图片转成一组特征向量;
- 投影层:把图像向量转换为大语言模型能接收的token格式;
- 大语言模型LLM:接收拼接后的图片token+文本prompt,输出自然语言回答。
现在很多AI应用:截图问答、OCR理解图片、分析图表,底层都是VLM视觉语言模型。
七、计算机视觉常见落地场景
| 领域 | 典型应用 | 适用技术 |
|---|---|---|
| 自动驾驶 | 识别车辆、行人、车道、交通标识 | 目标检测+语义分割 |
| 医学影像 | CT、X光识别病灶 | 分割、图像分类 |
| 工业质检 | 零件缺陷检测 | 检测、实例分割 |
| 消费电子 | 人脸解锁、人像抠图 | 检测+分割 |
| AIGC | AI文生图、图生图 | 扩散模型+CLIP |
| 多模态AI | 图片问答、图表解析 | VLM视觉语言大模型 |
写在最后
计算机视觉经历了CNN → ViT → 扩散模型 → VLM多模态的演变。
- 传统CNN适合工业检测、小数据集;
- ViT擅长大数据全局视觉任务;
- 扩散模型主攻图像生成创作;
- VLM视觉语言模型打通图像与自然语言,是现在的主流发展方向。
计算机视觉不再只是单纯识别物体,而是走向“看懂内容,并且能用语言交互”的多模态时代。
0 条笔记